Apuntes · Capítulo 12Recursión
Funciones como valores
Funciones como valores
La semana pasada escribieron un solucionador de sudokus con backtracking, y en la clase vieron N reinas. Si ponen los dos programas lado a lado, se parecen mucho: elegir, explorar, deshacer. Lo que cambia es poco: qué opciones hay, cuándo una opción es válida y qué se hace con una solución. El resto del código es el mismo, y lo escribimos dos veces.
Con lo que saben, un parámetro puede cambiar con qué datos trabaja una función. Hoy aprenderemos a cambiar qué hace. Una función se puede guardar en una variable, pasar como argumento, poner en un arreglo y llamar después. En C, eso se hace con un puntero a función (function pointer).
No es del todo nuevo. En Introducción a la Computación llamaron a qsort pasándole el nombre de una función
de comparar, y esa función se copió como receta, porque aún no tenían punteros. Hoy abriremos esa caja: al
final del capítulo podrán escribir su propio qsort. Después veremos el problema más interesante del tema: C
no deja que una función lleve datos consigo, y todo el mundo lo resuelve con el mismo patrón, el contexto
void *.
En el laboratorio juntarán todo en un backtracker que no sabe qué problema resuelve, y resolverá N reinas y el sudoku sin cambiarle una línea.
Ruta de lectura.
- Antes de clase (15 a 20 minutos, obligatoria): la introducción, Una función también tiene dirección y La sintaxis.
- En clase: Separar el qué del cómo,
qsortpor dentro, Comparadores destruct,bsearch, C no tiene clausuras, Tablas de funciones y Un backtracker que no sabe qué resuelve.- Después de clase: Por qué no se resta y El laboratorio, paso a paso. Luego el Resumen y los Ejercicios. Para ir más allá: los últimos ejercicios del capítulo.
Código. Los programas de este capítulo están en
code/week-12. Dentro del entorno del curso, entren a esa carpeta y corranmakepara compilar los ejemplos ymake testpara comprobarlos. Los comandos de este capítulo se corren desde ahí. Los programas deerrors/tienen errores a propósito y se compilan a mano, como se muestra en cada caso.
Una función también tiene dirección
Un programa compilado son instrucciones de máquina, y esas instrucciones están en la memoria mientras el programa corre. Por eso una función empieza en alguna dirección, igual que una variable. Llamar a una función es, en el fondo, saltar a esa dirección.
gdb lo puede mostrar sin correr el programa. En function_pointer.c hay dos funciones, add y multiply.
Las direcciones dependen del entorno.
$ gcc -Wall -Wextra -std=c17 -g -O0 function_pointer.c -o build/function_pointer_gdb
$ gdb -q -batch -ex 'print add' -ex 'print &add' -ex 'print multiply' build/function_pointer_gdb
$1 = {int (int, int)} 0x7a8 <add>
$2 = (int (*)(int, int)) 0x7a8 <add>
$3 = {int (int, int)} 0x7c8 <multiply>
Lean la primera línea: add es de tipo int (int, int), “función que recibe dos int y devuelve un int”,
y vive en cierta dirección. La segunda línea es la dirección de add, con el tipo int (*)(int, int),
“puntero a una función así”. Las dos son la misma dirección.
Esa es la regla de C, y se parece a la de los arreglos de la semana 4: el nombre de una función, usado sin
paréntesis, se convierte en su dirección. Por eso add y &add dan lo mismo, y por eso escribían
qsort(grades, N, sizeof(grades[0]), compare_ints) sin ningún &.
Error común. Confundir
addconadd(2, 3). Lo primero es la función misma: su dirección. Lo segundo la llama, y lo que queda es unint. Aqsortse le pasacompare_ints, sin paréntesis, porque esqsortquien la va a llamar.
La sintaxis
Una variable que guarda la dirección de una función se declara con esta forma, que asusta la primera vez. En
function_pointer.c:
int (*op)(int, int) = add;Se lee desde el nombre hacia afuera:
| Parte | Se lee |
|---|---|
op |
op es |
(*op) |
un puntero |
(*op)(int, int) |
a una función que recibe dos int |
int (*op)(int, int) |
y devuelve un int |
Con esa variable se llama a la función como si op fuera su nombre. También se puede escribir (*op)(2, 3),
que significa exactamente lo mismo: C acepta las dos formas, y en este curso usaremos la primera.
op = multiply;
printf("op(2, 3) = %d\n", op(2, 3));
printf("(*op)(2, 3) = %d\n", (*op)(2, 3));
printf("op == multiply: %d\n", op == multiply);
$ build/function_pointer
op(2, 3) = 5
op(2, 3) = 6
(*op)(2, 3) = 6
op == multiply: 1
apply(chosen, 2, 3) = 5
apply(multiply, 2, 3) = 6La misma línea, op(2, 3), dio 5 y luego 6. Es una variable: lo que hace la llamada se decide cuando el
programa corre, mirando qué dirección tiene op en ese momento. Los punteros a función se pueden asignar,
comparar con == y con NULL, pero no tiene sentido hacer aritmética con ellos: una función no es un
arreglo.
Con typedef
Esa sintaxis se complica rápido, sobre todo si la función recibe otra función. Por eso casi siempre se le da
un nombre al tipo con typedef, que ya conocen de la semana 7. Se escribe como una declaración, con typedef
delante, y el nombre queda donde iría la variable:
typedef int (*BinaryOp)(int, int);Ahora BinaryOp es un tipo, y se puede usar en cualquier lugar: en una variable, en un campo de un struct,
en un arreglo y en un parámetro. Una función que recibe otra se lee mucho mejor:
int apply(BinaryOp op, int a, int b) {
    return op(a, b);
}
A la función que se pasa para que otra la llame se le dice callback. apply no sabe qué operación va a
hacer. Lo sabe quien la llama.
Dos errores, y lo que dice gcc
Los paréntesis alrededor de *op no son decoración. Sin ellos, el * se pega al tipo de retorno, y lo que se
declara es otra cosa: una función op que devuelve un int *. En errors/missing_parens.c:
int *op(int, int) = add;$ gcc -Wall -Wextra -std=c17 errors/missing_parens.c -o build/missing_parens
errors/missing_parens.c:9:5: error: function 'op' is initialized like a variableEl tipo de un puntero a función incluye sus parámetros y su retorno. Una función con otra forma no se puede
asignar. En errors/wrong_signature.c, negate recibe un solo int:
BinaryOp op = negate;$ gcc -Wall -Wextra -std=c17 errors/wrong_signature.c -o build/wrong_signature
errors/wrong_signature.c:11:19: error: initialization of 'BinaryOp' {aka 'int (*)(int, int)'} from incompatible pointer type 'int (*)(int)' [-Wincompatible-pointer-types]Este gcc lo trata como error. Otras versiones lo dan solo como advertencia, así que no se confíen: si ven
esa advertencia, es un bug.
En C. Un
void *puede guardar la dirección de cualquier dato, pero el estándar no dice que pueda guardar la de una función. Por eso aquí no imprimimos direcciones de funciones con%p: esa regla deprintf, con su(void *), es para datos. Si necesitan guardar funciones de cualquier forma, usen un puntero a función, no unvoid *.
Separar el qué del cómo
Veamos para qué sirve todo esto. En repeated_loops.c hay dos funciones que cambian todos los precios de un
arreglo:
void add_tax_all(double *prices, int n) {
    for (int i = 0; i < n; i++) {
        prices[i] = prices[i] * 1.18;
    }
}(half_price_all es igual, con prices[i] / 2.0.)
Son idénticas, salvo por una expresión. Si mañana hay que recorrer el arreglo de otro modo, hay que cambiarlas todas. El cómo se recorre está repetido, y mezclado con el qué se hace con cada elemento.
Con un callback, los separamos. En prices.c, el ciclo se escribe una vez, y el qué se pasa como parámetro:
typedef double (*PriceChange)(double);void change_all(double *prices, int n, PriceChange change) {
for (int i = 0; i < n; i++) {
prices[i] = change(prices[i]);
}
}add_tax es una función de una línea. Lo que escribe el programa es lo mismo que repeated_loops.c, y una
prueba lo comprueba. Agregar una operación ya no toca el ciclo.
Tres formas de recorrer un arreglo
Casi todo lo que se hace con un arreglo cae en una de estas tres formas, y tienen nombres que verán en muchos lenguajes:
| Forma | Qué produce | Callback | Ejemplo |
|---|---|---|---|
| map | Un arreglo del mismo tamaño, con cada elemento transformado | Recibe un elemento y devuelve el nuevo | Agregar el impuesto |
| filter | Un arreglo con los elementos que cumplen algo | Recibe un elemento y dice sí o no | Los aprobados |
| fold | Un solo valor, que resume el arreglo | Recibe el acumulado y un elemento, y devuelve el nuevo acumulado | La suma, el mayor |
change_all es un map, que trabaja sobre el mismo arreglo. Veamos fold, que es la menos obvia. También en
prices.c:
double fold_prices(const double *prices, int n, PriceFold combine, double initial) {
    double result = initial;
    for (int i = 0; i < n; i++) {
        result = combine(result, prices[i]);
    }
    return result;
}
Cambiando el callback y el valor inicial, la misma función calcula una suma o busca el mayor:
printf("total: %.2f\n", fold_prices(prices, COUNT, add_prices, 0.0));
printf("mayor: %.2f\n", fold_prices(prices, COUNT, larger_price, prices[0]));
$ build/prices
total: 139.50
mayor: 100.00
11.80 29.50 5.31 118.00
5.90 14.75 2.65 59.00Sigan el total a mano, con los precios 10, 25, 4.5 y 100: result vale 0, 10, 35, 39.5 y 139.5.
El filter queda como pseudocódigo, porque lo escribirán en C en el laboratorio. Noten que k avanza más lento
que i: por eso el resultado puede guardarse sobre el mismo arreglo.
algoritmo filtrar(entrada, n, conservar, salida)
    k ← 0
    para i desde 0 hasta n - 1 hacer
        si conservar(entrada[i]) entonces
            salida[k] ← entrada[i]
            k ← k + 1
        fin si
    fin para
    devolver k
fin algoritmo
Idea clave. Una función que recibe otra separa dos decisiones: cómo se recorre, que se escribe una vez, y qué se hace con cada elemento, que lo decide quien llama. Cada una se prueba por su lado.
qsort por dentro
Ya pueden leer la firma completa de qsort, aquí con nombres más claros para los parámetros:
void qsort(void *base, size_t count, size_t size, int (*compare)(const void *, const void *));Cada parámetro está ahí por una razón, y todas son la misma: qsort no sabe qué está ordenando.
void *base: la dirección del arreglo, sin decir de qué tipo. Lo vieron conmallocen la semana 5.size_t count: cuántos elementos tiene.size_t size: cuánto ocupa cada uno, en bytes. Sin el tipo, es la única forma de saber dónde empieza el siguiente.compare: un puntero a función. Es lo único que sabe del significado de los datos.
¿Por qué el comparador recibe const void *? Por dos razones, una por cada palabra. void *, porque qsort
solo tiene direcciones y no puede dar otra cosa: quien sabe qué hay ahí es quien escribió el comparador, y por
eso es él quien convierte. const, porque es una promesa: comparar no cambia los elementos.
Escribamos uno
La mejor forma de entenderlo es escribirlo. El ordenamiento por selección de Introducción a la Computación
busca el menor de lo que falta y lo pone al frente. Hagámoslo sin saber el tipo. En any_sort.c:
void any_sort(void *base, size_t count, size_t size, Compare compare) {
    unsigned char *bytes = base;
    for (size_t i = 0; i < count; i++) {
        size_t smallest = i;
        for (size_t j = i + 1; j < count; j++) {
            if (compare(bytes + j * size, bytes + smallest * size) < 0) {
                smallest = j;
            }
        }
        if (smallest != i) {
            swap_bytes(bytes + i * size, bytes + smallest * size, size);
        }
    }
}
Es el mismo algoritmo. Cambian tres cosas:
a[j] < a[smallest]pasó a ser una llamada acompare. La función no sabe comparar, y le pregunta a quien sí sabe.a[j]pasó a serbytes + j * size.any_sortno sabe de qué tipo es el elemento, pero sabe dónde está:jvecessizebytes después del inicio. Esa es la aritmética de punteros de la semana 4, hecha a mano. Por esobyteses ununsigned char *: ununsigned charocupa un byte, así que sumarle 1 avanza un byte.- Intercambiar pasó a ser copiar bytes. Sin el tipo no hay cómo declarar una variable temporal, pero un
elemento no es más que
sizebytes seguidos, y esos se pueden intercambiar uno por uno. Es la funciónswap_bytesdel mismo archivo.
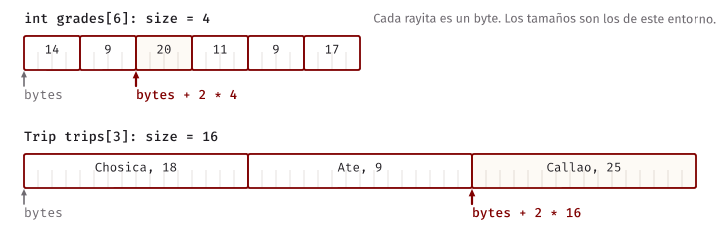
El arreglo se pasa como void * y llega como bytes: por eso no hace falta ningún cast. La misma función
ordena un arreglo de int y uno de struct, porque lo único que cambia es el tamaño y el comparador:
$ build/any_sort
9 9 11 14 17 20
Ate 9
Callao 25
Chosica 18
El qsort de la biblioteca usa otro algoritmo, más rápido, como vieron en Introducción a la Computación. La
forma de hablar con el comparador es esta misma.
Error común. Sumar directamente a un
void *. En C no está definido, porquevoidno tiene tamaño. Lo engañoso es quegcclo acepta como una extensión propia y no dice nada con-Wall -Wextra:$ gcc -Wall -Wextra -std=c17 errors/void_arithmetic.c -o build/void_arithmetic $ build/void_arithmetic 9Solo avisa si se le pide. Conviertan primero a
unsigned char *, y su código será C de verdad.$ gcc -Wall -Wextra -std=c17 -Wpointer-arith errors/void_arithmetic.c -o build/void_arithmetic errors/void_arithmetic.c:7:23: warning: pointer of type 'void *' used in arithmetic [-Wpointer-arith]
La forma del comparador no se negocia
¿Por qué no escribir un comparador más cómodo, que reciba const int *? En errors/typed_compare.c:
int compare_ints(const int *a, const int *b) {$ gcc -Wall -Wextra -std=c17 errors/typed_compare.c -o build/typed_compare
errors/typed_compare.c:11:41: error: passing argument 4 of 'qsort' from incompatible pointer type [-Wincompatible-pointer-types]Se puede callar al compilador con un cast, y eso es peor. errors/typed_compare_cast.c compila sin
advertencias y en este entorno ordena bien:
qsort(grades, 3, sizeof(grades[0]), (Compare) compare_ints);$ gcc -Wall -Wextra -std=c17 -g -fsanitize=address,undefined errors/typed_compare_cast.c -o build/typed_compare_cast
$ build/typed_compare_cast
9 14 20Y sigue siendo comportamiento indefinido: llamar a una función a través de un puntero de otro tipo no está permitido. Ya saben de la semana 7 lo que vale que “funcione”.
Comparadores de struct
En Introducción a la Computación, la receta copiaba los dos elementos a variables. Ahora que tienen punteros,
un struct no hace falta copiarlo. En sort_students.c:
int compare_by_name(const void *first, const void *second) {
    const Student *a = first;
    const Student *b = second;
    return strcmp(a->name, b->name);
}
No hace falta un cast: void * se convierte solo a cualquier puntero a dato, como con malloc. Y el const
se mantiene.
Para otro criterio, se escribe otro comparador. Para ordenar de mayor a menor, se invierten los signos: en
compare_by_grade_desc, el que tiene más nota devuelve -1.
Un criterio con desempate llama a los otros dos. Primero la nota, y si es igual, el nombre:
int compare_by_grade_then_name(const void *first, const void *second) {
    int by_grade = compare_by_grade_desc(first, second);
    if (by_grade != 0) {
        return by_grade;
    }
    return compare_by_name(first, second);
}
$ build/sort_students
por nombre:
Abel 17
Carmen 17
Luis 9
Nadia 14
Rosa 14
por nota y luego nombre:
Abel 17
Carmen 17
Nadia 14
Rosa 14
Luis 9¿Por qué no basta con ordenar por nombre y después por nota? Porque qsort no promete ser estable: un
ordenamiento es estable si los elementos que dan igual conservan el orden que tenían, y qsort no lo
garantiza. Si les importa el orden de los empates, el comparador debe decidirlo.
Un nivel más de punteros
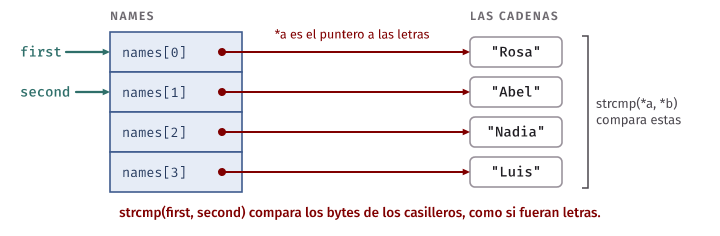
Hay un caso que engaña a todo el mundo: un arreglo de cadenas. Cada elemento es un const char *, y qsort
pasa la dirección del elemento. Entonces el comparador recibe la dirección de un puntero. En
sort_names.c:
const char *names[COUNT] = {"Rosa", "Abel", "Nadia", "Luis"};int compare_names(const void *first, const void *second) {
const char *const *a = first;
const char *const *b = second;
return strcmp(*a, *b);
}
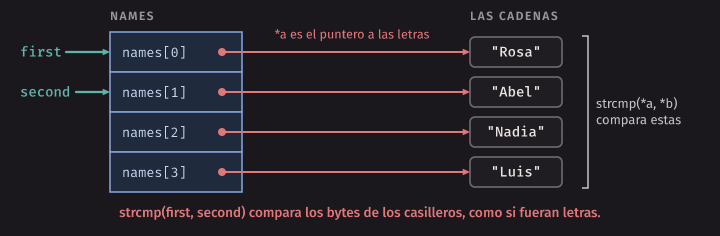
El tipo const char *const * se lee como antes, desde el nombre hacia afuera: a es un puntero a un puntero
constante a char constante. Lo natural es intentar strcmp(first, second), porque void * se convierte
solo. En errors/wrong_level.c:
return strcmp(first, second);$ gcc -Wall -Wextra -std=c17 -g -fsanitize=address,undefined errors/wrong_level.c -o build/wrong_level$ build/wrong_level
Nadia
Luis
Rosa
AbelCompila sin decir nada, ningún sanitizer se queja y el resultado no está ordenado. strcmp está comparando
los bytes de las direcciones como si fueran letras. Esta es la primera cara de lo que se pierde con void *:
el compilador ya no puede revisar los tipos. El resultado exacto depende de dónde queden las cadenas en la
memoria.
Por qué no se resta
En Introducción a la Computación se advirtió: no abrevien un comparador con return a - b;. Ahora veamos con
precisión qué falla. La resta de dos int puede no caber en un int. En errors/subtract_compare.c, se
compara directamente, sin qsort, el menor int que existe contra 1:
int compare_by_subtracting(const void *first, const void *second) {
    int a = *(const int *) first;
    int b = *(const int *) second;
    return a - b;
}
$ gcc -Wall -Wextra -std=c17 -g -fsanitize=address,undefined errors/subtract_compare.c -o build/subtract_compare
$ build/subtract_compare
errors/subtract_compare.c:8:14: runtime error: signed integer overflow: -2147483648 - 1 cannot be represented in type 'int'
con resta: 2147483647
sin resta: -1-2147483648 es menor que 1, así que el comparador debería devolver un negativo. Devolvió 2147483647: el
signo salió al revés. Y ese valor es solo lo que salió aquí, porque el overflow de un int es
comportamiento indefinido.
Con datos así, qsort ordena mal. En errors/subtract_sort.c:
int values[COUNT] = {2000000000, -2000000000, 5, 1500000000, -1500000000};$ gcc -Wall -Wextra -std=c17 errors/subtract_sort.c -o build/subtract_sort
$ build/subtract_sort
5
1500000000
2000000000
-2000000000
-1500000000Terminó sin ningún error, y los negativos quedaron al final. Sin sanitizers, nada avisa. Y con notas de 0 a 20, la resta sí funciona, que es lo peor del asunto: pasa todas las pruebas, hasta que llega un dato grande.
La forma correcta compara, en vez de restar. Se puede escribir con if, como en la receta, o en una línea:
return (a > b) - (a < b);Una comparación vale 1 o 0, así que esa resta da 1, -1 o 0, y nunca hace overflow.
Con double hay otro problema. Un comparador devuelve int, así que lo que devuelve se convierte, y la
conversión descarta los decimales. En errors/double_compare.c:
$ gcc -Wall -Wextra -std=c17 -g -fsanitize=address,undefined errors/double_compare.c -o build/double_compare
$ build/double_compare
2.9 2.1 2.5 1.8
Entre 2.9 y 2.1, la resta da 0.8, que convertido a int es 0: “da igual”. Ninguna herramienta se queja,
porque esa conversión está bien definida, como vimos en la semana 7. Simplemente, el arreglo no queda
ordenado.
Idea clave. Un comparador compara. No resta, ni con enteros ni con decimales:
(a > b) - (a < b)funciona con los dos.
bsearch
bsearch, de stdlib.h, hace una búsqueda binaria con la misma filosofía:
void *bsearch(const void *key, const void *base, size_t count, size_t size,
              int (*compare)(const void *, const void *));
Devuelve la dirección del elemento encontrado, o NULL si no está. Tiene dos detalles que conviene mirar. El
primero es que el arreglo debe estar ordenado por el mismo criterio del comparador: si no, el resultado no
significa nada.
El segundo es el orden de los argumentos del comparador: bsearch promete que el primero es la clave, y
el segundo un elemento. Por eso la clave no necesita ser del tipo del elemento. Para buscar un alumno por
código, basta con un int. En search_students.c:
int compare_code_with_student(const void *key, const void *element) {
    int code = *(const int *) key;
    const Student *student = element;
    return (code > student->code) - (code < student->code);
}
Por dentro es la búsqueda binaria de siempre, con la misma aritmética de any_sort. any_search, en el mismo
archivo, tiene la misma firma, y la comparamos con la de la biblioteca. Dos detalles: su high es una
posición después del último candidato, porque con size_t un middle - 1 daría la vuelta si middle
vale 0, como vieron en la semana 7. Y un cast (void *) le quita el const al devolver: la firma de la
biblioteca hace lo mismo, para servir tanto a arreglos constantes como a los que no lo son.
$ build/search_students
1311: nota 12
1311: nota 12
1312: no está
1312: no está
C no tiene clausuras
Ahora, el problema. Queremos sumar las notas mayores que 15, recorriendo el arreglo con un callback. Sin
problema: una función is_above_15. ¿Y las mayores que 10? Otra función, is_above_10. ¿Y si el límite lo
escribe el usuario cuando el programa ya está corriendo? Ahí no hay nada que hacer, porque las funciones se
escriben antes de compilar.
El callback necesita, además del elemento, un dato que conoce quien llama. Y entre los dos hay una función, el recorrido, que no sabe nada de límites.
Otros lenguajes tienen una herramienta directa para esto: una clausura (closure), que es una función que
se lleva consigo los datos del lugar donde se creó. Se escribe algo como “la función que dice si x es mayor
que limit”, y limit viaja dentro de la función.
C no tiene clausuras. Un puntero a función es una dirección de código, y nada más: no hay dónde guardar un
dato adentro. Si is_above necesita un límite, tiene que recibirlo por sus parámetros, o tomarlo de una
variable global. Y las variables globales ya las descartamos en la semana 3: el callback funcionaría, pero dos
búsquedas con dos límites se pisarían entre sí, y ya no se podría razonar sobre la función mirándola sola.
En C. Quizá lean en algún lado que
gccpermite escribir una función dentro de otra. Es cierto, yerrors/nested_function.ccompila y corre con nuestros flags. Pero no es C: es una extensión degcc(con-pedanticavisaISO C forbids nested functions), y otros compiladores no la aceptan. Tampoco es una clausura: esa función interna no se puede usar cuando la función de afuera ya terminó. No la usamos.
El patrón de contexto
La solución de C es simple. Si el puntero a función no puede llevar datos, los llevamos aparte: quien recorre
recibe dos cosas, el callback y un void * con los datos, y se los pasa juntos, sin mirarlos. A ese
puntero se le llama contexto. En for_each.c:
typedef void (*Visitor)(int value, void *context);void for_each(const int *values, int n, Visitor visit, void *context) {
for (int i = 0; i < n; i++) {
visit(values[i], context);
}
}for_each no toca context. Solo lo transporta. ¿Por qué void *? Porque for_each no sabe qué necesita
cada callback, y así sirve para todos. Quien sabe qué hay ahí es el callback, que lo convierte:
typedef struct {
    int limit;
    int sum;
    int taken;
} SumAbove;
void add_if_above(int value, void *context) {
SumAbove *state = context;
if (value > state->limit) {
state->sum += value;
state->taken++;
}
}Quien llama prepara sus datos en una variable local, y pasa su dirección:
SumAbove strict = {15, 0, 0};
for_each(grades, COUNT, add_if_above, &strict);
printf("mayores que %d: %d, suman %d\n", strict.limit, strict.taken, strict.sum);
$ build/for_each
mayores que 15: 2, suman 37
mayores que 10: 5, suman 75
nota: 14
nota: 9Mírenlo en la memoria. Durante la llamada, el contexto es una dirección que pasa de marco en marco hasta el
callback, y apunta de vuelta al marco de main:
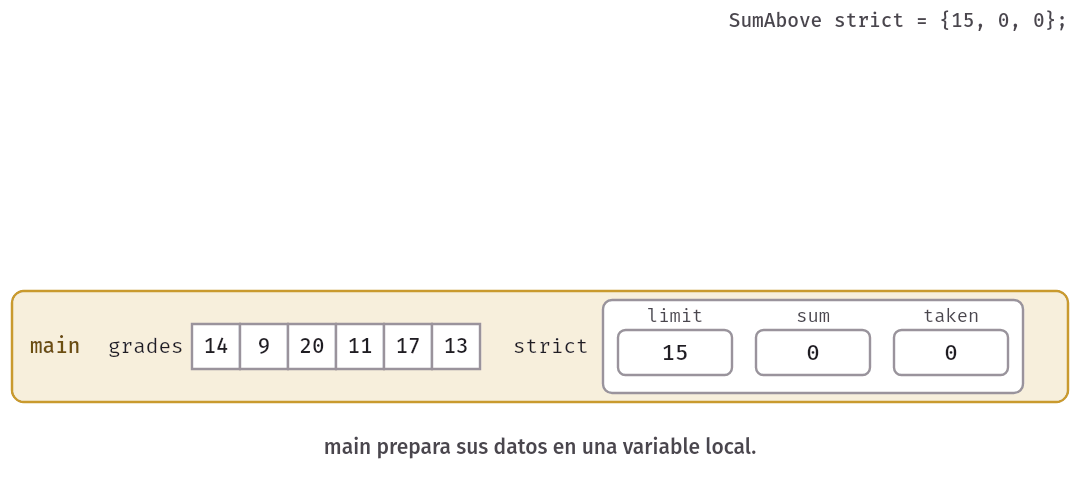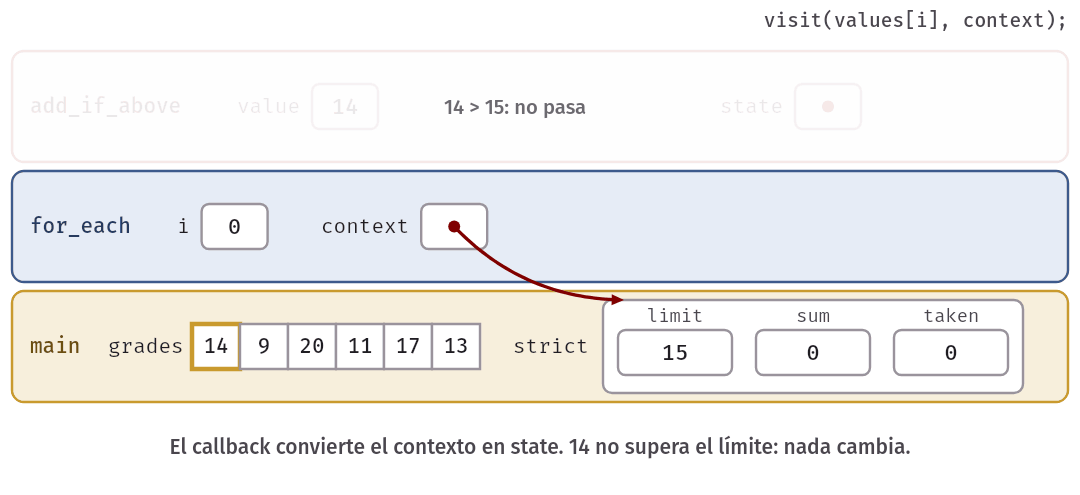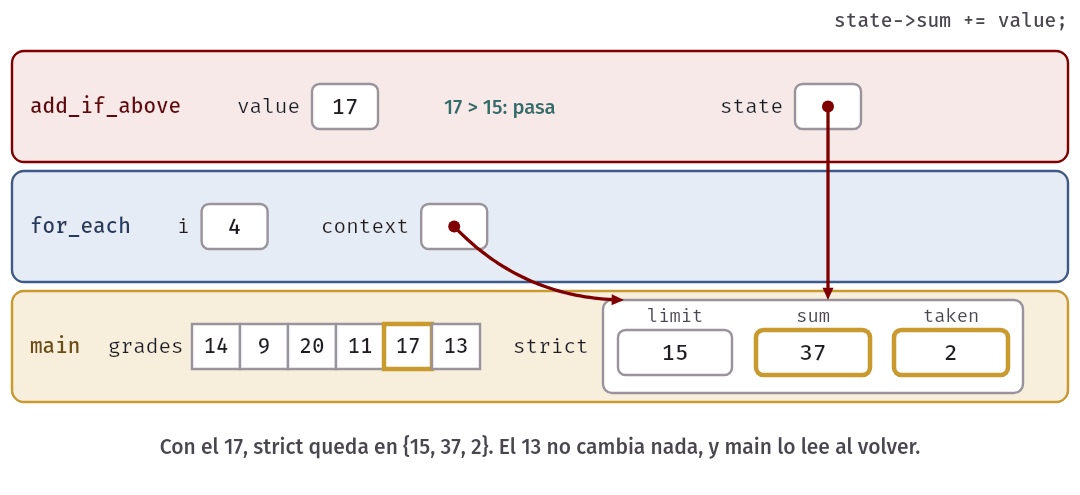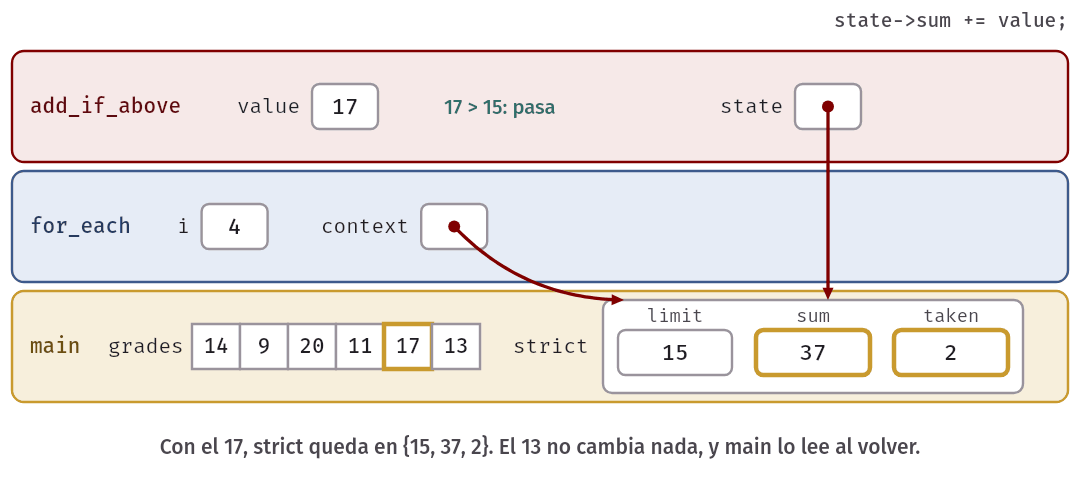
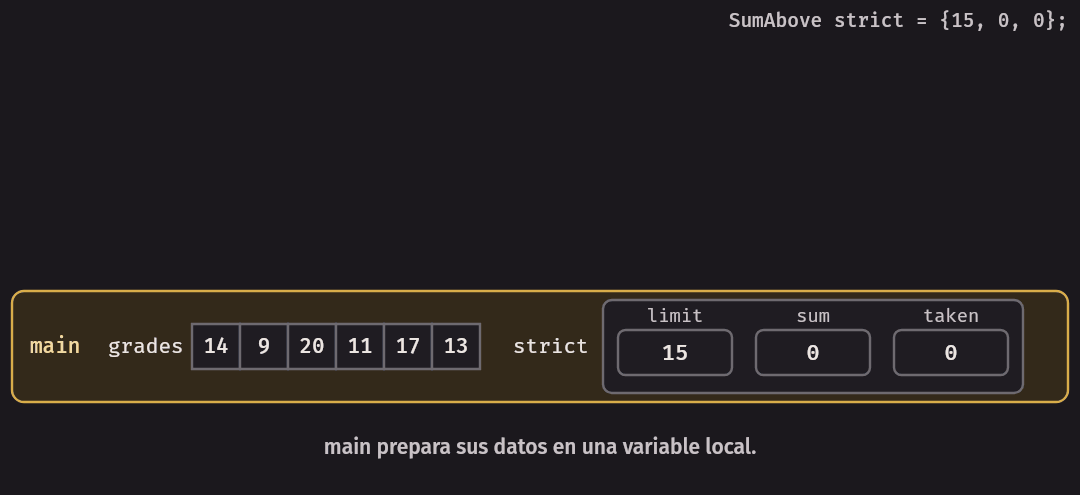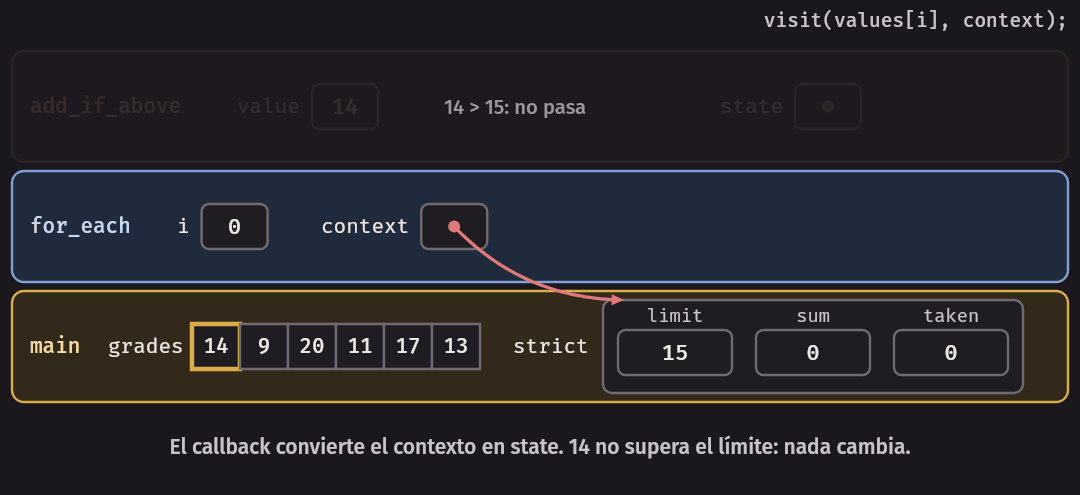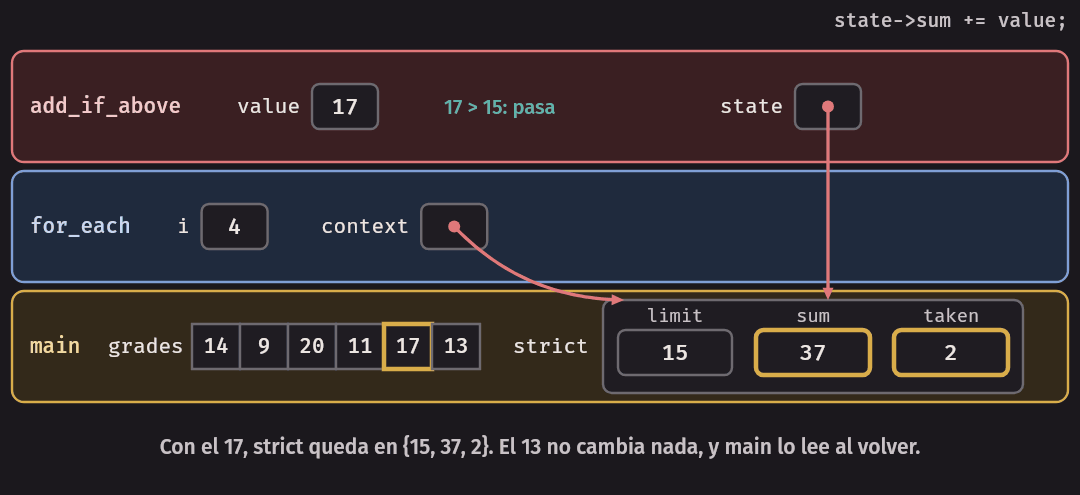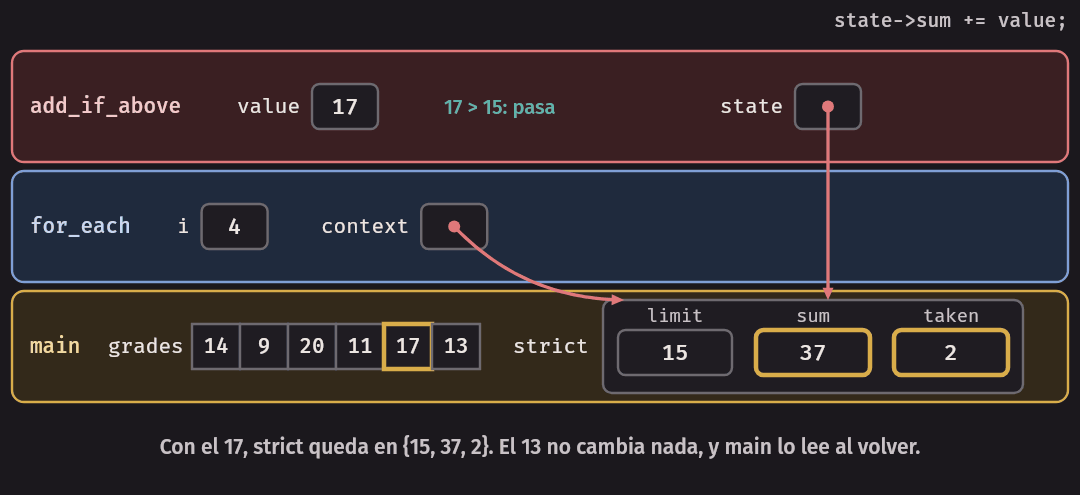
Esto trae tres cosas buenas. Sirve para entrar datos, como limit, y también para sacarlos, como sum. Dos
búsquedas con dos límites no se estorban, porque cada una tiene su variable. Y es seguro, por lo que
aprendieron de los marcos: strict vive en main, que no termina hasta después de que for_each volvió.
El contexto puede ser cualquier cosa, no solo un struct. Las dos últimas líneas de la salida vienen de otro
callback, print_labeled, que usa el contexto como la cadena con la que debe empezar cada línea.
En C.
qsortybsearchson más antiguos que este patrón, y su comparador no recibe contexto. Si el criterio depende de un dato que se conoce al correr, como la columna por la que se ordena, en C estándar no hay una forma limpia de pasarlo. Por eso existen variantes que no son del estándar, comoqsort_r. Si escriben una función que recibe un callback, denle suvoid *context, aunque hoy no lo necesite.
Qué se pierde
Al pasar por void *, el tipo desaparece. add_if_above supone que le llegó un SumAbove *, y nadie lo
revisa. En errors/wrong_context.c le pasamos la dirección de un int, y compila sin ninguna advertencia:
for_each(grades, COUNT, add_if_above, &limit);$ gcc -Wall -Wextra -std=c17 -g -fsanitize=address,undefined errors/wrong_context.c -o build/wrong_context
$ build/wrong_context
==162==ERROR: AddressSanitizer: stack-buffer-overflow on address 0xffff9d200034 at pc 0xaaaacc191650 bp 0xffffdf6b2ff0 sp 0xffffdf6b3008
READ of size 4 at 0xffff9d200034 thread T0
#0 0xaaaacc19164c in add_if_above errors/wrong_context.c:17
#1 0xaaaacc191918 in for_each errors/wrong_context.c:24
#2 0xaaaacc191b44 in main errors/wrong_context.c:31Aquí ASan lo encontró porque el callback se salió de la variable: state->sum queda después del int. Si no
se sale, nadie avisa. En errors/wrong_context_silent.c, el callback espera un int, y le pasamos la
dirección de un double que vale 15.0:
double limit = 15.0;
for_each(grades, COUNT, print_if_above, &limit);
$ gcc -Wall -Wextra -std=c17 -g -fsanitize=address,undefined errors/wrong_context_silent.c -o build/wrong_context_silent
$ build/wrong_context_silent
14 pasa
9 pasa
20 pasa
finNi gcc, ni ASan, ni UBSan. El 9 “pasa” el límite de 15, porque el callback lee 4 de los 8 bytes del
double, y en esta máquina esos 4 bytes son ceros. Se parece a leer la variante equivocada de una union, de
la semana 7, pero es peor. Aquello interpretaba los bytes con otro tipo, y C lo permite. Esto lee un double
a través de un int *, y eso sí es comportamiento indefinido. Y aun así, ninguna herramienta avisó.
Eso es lo que se paga: la revisión de tipos. Con un SumAbove * en la firma, gcc lo habría rechazado.
Con void *, la concordancia entre el callback y su contexto es una promesa que ustedes deben cumplir,
igual que la etiqueta de una unión etiquetada. Dos reglas ayudan:
- El callback y su contexto se escriben juntos, y la llamada a quien recorre va cerca. El comentario del callback dice qué espera.
- El callback convierte el contexto en su primera línea, a una variable con nombre. Así, la suposición queda escrita, y a la vista.
Error común. Olvidar de quién es el contexto. Quien recorre solo lo presta al callback, y no lo libera. El owner es quien llama, y debe mantenerlo vivo mientras alguien pueda usarlo: si un módulo guardara ese puntero para después, un contexto en una variable local dejaría de existir antes de tiempo, como vieron en la semana 4.
Tablas de funciones
Un puntero a función es un valor, así que se puede guardar en un arreglo o en un struct. Una tabla de
funciones es eso: un arreglo que une cada caso con la función que lo atiende. En calculator.c:
typedef struct {
    const char *name;
    BinaryOp run;
} Operation;
const Operation table[] = {
{"suma", add},
{"resta", subtract},
{"producto", multiply},
{"mayor", larger},
};Elegir una operación ya no es un switch: es buscar una fila, y llamar a la función que está ahí.
printf("%s de %d y %d: %d\n", chosen->name, a, b, chosen->run(a, b));$ build/calculator suma
suma de 12 y 5: 17
$ build/calculator mayor
mayor de 12 y 5: 12
$ build/calculator potencia
no conozco la operación potenciaAgregar una operación es una función y una fila. La lógica de elegir no se toca, y la tabla se puede recorrer: por ejemplo, para escribir la lista de operaciones disponibles en un mensaje de ayuda.
También se puede indexar con un enum, y entonces elegir la función toma un solo paso, sin buscar. Pero miren
lo que se pierde. En la semana 7, -Wswitch les avisaba de un caso sin atender en un switch. Una tabla no
tiene esa revisión. En errors/table_gap.c, se agregó OP_LARGER y la tabla quedó con un hueco:
enum op_kind { OP_ADD, OP_SUBTRACT, OP_LARGER, OP_COUNT };const BinaryOp table[OP_COUNT] = {add, subtract};$ gcc -Wall -Wextra -std=c17 -g -fsanitize=address,undefined errors/table_gap.c -o build/table_gap
$ build/table_gap
==188==ERROR: AddressSanitizer: SEGV on unknown address 0x000000000000 (pc 0x000000000000 bp 0xfffff5b6fcb0 sp 0xfffff5b6fcb0 T0)
==188==Hint: pc points to the zero page.Compiló sin aviso. Lo que falta en un arreglo inicializado queda en cero, y un puntero a función en cero es
NULL. Llamarlo salta a la dirección 0: el pc 0x000000000000 del informe.
switch sobre un enum |
Tabla de funciones | |
|---|---|---|
| Agregar un caso | Un case en cada switch |
Una fila |
| Si olvidan un caso | -Wswitch avisa |
Nadie avisa; NULL al correr |
| Agregar una operación que atienda todos los casos | Una función con un switch, sin tocar lo demás |
Una columna en cada fila |
| Listar las operaciones, o elegir por nombre | Hay que escribir cada caso | Se recorre la tabla |
Las dos son buenas. Prefieran la tabla cuando los casos son muchos y parejos, y el switch cuando hacen cosas
distintas, o cuando quieren que el compilador les revise que están todos.
Un backtracker que no sabe qué resuelve
Volvamos al principio. El backtracking de la semana 11 tiene una forma fija, y unos pocos puntos en que cada problema es distinto. Ahora tenemos la herramienta para separarlos.
Primer paso: qué hacer con cada resultado
La forma más simple es un generador de permutaciones que no sabe qué se hará con ellas. En permutations.c,
el esquema de elegir, explorar y deshacer es el de siempre, y en lugar del printf hay un callback:
typedef void (*OnPermutation)(const int *items, int n, void *context);void explore(int *items, int n, int position, OnPermutation visit, void *context) {
if (position == n) {
visit(items, n, context);
return;
}
for (int i = position; i < n; i++) {
swap(&items[position], &items[i]);
explore(items, n, position + 1, visit, context);
swap(&items[position], &items[i]);
}
}Elegir es intercambiar, y deshacer es intercambiar de vuelta, sin el arreglo used de la semana pasada: por
eso salen en otro orden. context baja intacto por toda la recursión. Un callback las imprime, y otro, con un
struct de contexto, las cuenta:
$ build/permutations
1 2 3
1 3 2
2 1 3
2 3 1
3 2 1
3 1 2
120 permutaciones, en 60 el primero es menor que el último
Son las 5! = 120 hojas del árbol de permutaciones de la semana pasada, y las 3! = 6 de arriba.
Segundo paso: todo lo demás
¿Qué queda fijo en explore? Los pasos, las opciones y la forma de poner y deshacer. Para que sirva para
cualquier problema, hay que preguntarle todo eso a callbacks. Este es el motor, que escribirán en el
laboratorio:
algoritmo explorar(problema, contexto, paso)
    si paso = problema.pasos entonces
        devolver problema.en_solucion(contexto)
    fin si
    para opcion desde 0 hasta problema.opciones(contexto, paso) - 1 hacer
        si problema.es_valida(contexto, paso, opcion) entonces
            problema.poner(contexto, paso, opcion)
            detener ← explorar(problema, contexto, paso + 1)
            problema.deshacer(contexto, paso, opcion)
            si detener entonces
                devolver verdadero
            fin si
        fin si
    fin para
    devolver falso
fin algoritmo
Lean lo que no aparece: tableros, reinas, dígitos. El estado completo del problema está detrás de
contexto, y el motor nunca lo mira. Todo eso va junto en un struct de punteros a función. En
lab/backtrack.h:
typedef struct {
    // Cuántas decisiones hay que tomar. Una solución es haber tomado todas.
    int steps;
    // Cuántas opciones hay en este paso. Se prueban de la 0 a la anterior a ese número.
    int (*options)(void *context, int step);
    // ¿Se puede tomar esta opción, dado lo que ya se decidió?
    int (*is_valid)(void *context, int step, int option);
    // Toma la opción: cambia el estado.
    void (*place)(void *context, int step, int option);
    // Deshace lo que hizo place, con los mismos argumentos.
    void (*undo)(void *context, int step, int option);
    // Se llama con cada solución. Devuelve 1 para detener la búsqueda y 0 para seguir.
    int (*on_solution)(void *context);
} Problem;
Un struct lleno de punteros a función es un módulo en forma de valor: un conjunto de operaciones que se
puede pasar como argumento. La semana 6 separó la interfaz de la implementación al compilar. Esto la separa al
correr.
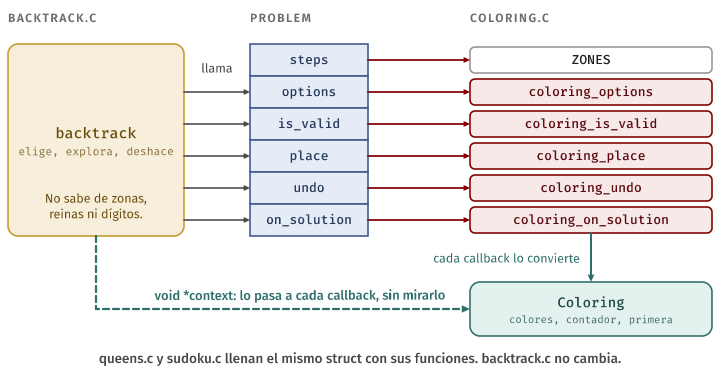
Dos decisiones merecen explicación:
undose llama siempre, aunque haya que detenerse. Por eso en el pseudocódigodeshacerva antes de mirardetener. La semana pasada, al encontrar la primera solución no deshacían, porque el estado era la respuesta. Aquí, el motor no sabe si alguien quiere la primera solución o todas, así que tiene una sola promesa: al terminar, el estado queda como estaba. Por esoon_solutiontiene que copiar lo que quiera conservar.- Las soluciones se cuentan en el contexto, y no en el motor. El motor no sabe qué le interesa a cada problema: quizá contar, quizá guardar la primera, quizá detenerse en la segunda.
El motor solo devuelve cuántos nodos visitó, para poder comparar. Un nodo es cada llegada a explorar,
incluida la raíz, igual que la semana pasada. Por eso 8 reinas da aquí los mismos 2057 nodos.
El mismo motor, tres problemas
Elegir un problema es responder las mismas preguntas:
| Pregunta | Pintar un mapa | N reinas | Sudoku |
|---|---|---|---|
| ¿Qué es un paso? | Una zona | Una fila | Una celda vacía |
| ¿Qué es una opción? | Un color | Una columna | Un dígito menos 1 |
| ¿Cuántos pasos? | Las zonas | n |
Las celdas vacías |
| ¿Cuándo es válida? | Ninguna vecina anterior tiene ese color | Ninguna reina anterior la ataca | board_can_place |
| ¿Qué guarda el contexto? | Los colores y el contador | Las columnas y el contador | El tablero, las celdas vacías y el contador |
El primero está completo en lab/coloring.c, para que lo usen de modelo: cinco zonas, tres colores, y dos
zonas vecinas no pueden tener el mismo. El contexto es un struct propio del problema:
typedef struct {
    int color[ZONES];
    long solutions;
    int first[ZONES];
} Coloring;
Cada callback es muy corto, y empieza convirtiendo el contexto:
static int coloring_is_valid(void *context, int step, int option) {
    const Coloring *state = context;
    for (int zone = 0; zone < step; zone++) {
        if (NEIGHBORS[step][zone] && state->color[zone] == option) {
            return 0;
        }
    }
    return 1;
}
Armar el problema es llenar el struct y llamar al motor:
Problem problem = {
    .steps = ZONES,
    .options = coloring_options,
    .is_valid = coloring_is_valid,
    .place = coloring_place,
    .undo = coloring_undo,
    .on_solution = coloring_on_solution,
};
Con su motor, esto debe escribir:
$ build/lab/coloring
12 soluciones, 34 nodos
A: rojo
B: verde
C: azul
D: rojo
E: verde
Comprueben las 12 a mano antes de creerle al programa. A, B y C son vecinas entre sí, así que hay 3 × 2 × 1 formas de pintarlas. D es vecina de B y de C, y le queda un solo color. E solo es vecina de D, y le quedan 2. En total, 6 × 1 × 2 = 12.
Lo que cuesta
Seamos honestos con el precio. Una función de 15 líneas pasó a ser un struct con cinco callbacks por
problema. Para un solo problema, no vale la pena: escriban el backtracking directo, como la semana pasada. Se
justifica cuando hay varios, o cuando el motor lo escribe otra persona.
Cada revisión de validez es ahora una llamada a través de un puntero, y todo el estado pasa por void *, sin
revisión de tipos.
Y hay decisiones que este motor no deja tomar. La poda del laboratorio de la semana pasada elegía la celda con
menos opciones mientras buscaba. Aquí el orden de los pasos es fijo, porque el motor cuenta step de uno
en uno. Se podría agregar otro callback, pero una interfaz con demasiados es tan difícil de usar como el
código repetido. Decidir qué entra en una interfaz genérica es la parte difícil de diseñarla.
El código de esta semana
make compila los programas de la clase en build/. make test corre tres archivos de pruebas:
| Archivo | Qué comprueba |
|---|---|
test_examples.py |
Que los programas compilan sin advertencias y terminan sin informes, y cada afirmación sobre herramientas: qué avisa gcc y qué detectan los sanitizers |
test_notes.py |
Vuelve a correr los comandos de este capítulo y compara su salida, y revisa que el código citado exista. Los bloques que dependen del sistema se corren, pero no se comparan |
test_lab.py |
La solución del laboratorio, si está disponible |
make test-lab corre esas mismas pruebas de laboratorio sobre su código.
El laboratorio, paso a paso
Los archivos de partida están en code/week-12/lab, y su README.md tiene las preguntas y lo que pide cada
parte. Aquí están las ideas, no el código.
Sesión 1
Comparadores. compare.h define un Trip, con ruta, pasajeros y tarifa. Escriben tres comparadores, y
sort_trips.c, ya hecho, los elige con una tabla. Las pruebas usan INT_MIN, INT_MAX y tarifas que
difieren en menos de 1: un comparador que resta no pasa.
array_map, array_filter y array_fold. Son las tres formas de esta semana, para int. La salida de
array_filter puede ser el mismo arreglo de la entrada, y si siguen el pseudocódigo, eso ya funciona.
El contexto. array_count_if transporta el void *, sin mirarlo, y count_above lo usa para contar
cuántos superan un umbral. ¿Dónde está el umbral? El parámetro de count_above es una variable local, y su
dirección sirve de contexto. Sin globales: una prueba lo revisa.
Sesión 2
El motor. Traduzcan el pseudocódigo a C, con una función auxiliar static para la recursión, y
backtrack que la llama y devuelve los nodos. Compruébenlo primero con coloring, que ya está hecho: si da
12 y 34, funciona.
N reinas. En queens.c, el struct del estado y la función que arma el Problem ya están hechos.
Escriben los cinco callbacks. Estos números los pueden comparar con los que obtuvieron:
n |
Soluciones | Nodos, contándolas todas | Nodos, hasta la primera |
|---|---|---|---|
| 4 | 2 | 17 | 9 |
| 5 | 10 | 54 | 6 |
| 6 | 4 | 153 | 32 |
| 7 | 40 | 552 | 10 |
| 8 | 92 | 2057 | 114 |
Noten que con n = 5 y 7 la primera solución aparece muy pronto, y con n = 6 no. Nada obliga a que crezca
de forma pareja.
Sudoku. board.c trae hecho el lector, con el mismo formato de la semana pasada, y board_can_place. Un
paso es una celda vacía: sudoku.c ya arma las listas de filas y columnas. Por dentro, una opción va de 0 a
8, y el dígito es la opción más 1.
sudoku_main busca hasta 2 soluciones, para saber si es única, y por eso sus nodos no se comparan con los de
la semana pasada, que se detenía en la primera. Aunque encuentre una rápido, sigue hasta recorrer todo lo que
queda. Los tableros son de esta clase, generados por nosotros, y una prueba comprueba que cada uno tiene una
sola solución:
| Tablero | Celdas vacías | Soluciones | Nodos |
|---|---|---|---|
facil.txt |
36 | 1 | 69 |
medio.txt |
45 | 1 | 848 |
dificil.txt |
52 | 1 | 26019 |
sin_solucion.txt |
45 | 0 | 689 |
repetido.txt |
35 | 0 | 0 |
En sin_solucion.txt, ningún dígito choca con otro: solo se descubre que no hay solución buscando.
repetido.txt tiene un dígito repetido en la primera fila, y sudoku_search lo rechaza sin buscar, por eso 0
nodos.
Cuando todo funcione, miren qué no cambió: backtrack.c se compila igual para los tres programas, y no
menciona ninguno.
Resumen
- Una función tiene una dirección. Su nombre, sin paréntesis, se convierte en esa dirección.
- Un puntero a función se declara
int (*op)(int, int), y contypedefse lee mucho mejor:typedef int (*BinaryOp)(int, int);. Sin los paréntesis, es otra cosa. - El tipo incluye los parámetros y el retorno. Forzarlo con un cast y llamar es comportamiento indefinido.
- Un callback es una función que se pasa a otra para que esta la llame. Sirve para separar cómo se recorre de qué se hace con cada elemento: map, filter y fold.
qsortybsearchno saben qué tipo manejan. Por eso recibenvoid *, un tamaño en bytes y un comparador. Para hacer aritmética, se convierte aunsigned char *, no se suma a unvoid *.- El comparador recibe
const void *, y debe tener esa forma exacta. En un arreglo de cadenas, cadavoid *es la dirección de un puntero. qsortno es estable. Si importa el orden de los empates, el comparador debe decidirlo.return a - b;puede hacer overflow, y condoublepierde los decimales. Usen(a > b) - (a < b).- En
bsearch, el arreglo está ordenado por el mismo criterio, y el primer argumento del comparador es la clave. - C no tiene clausuras: un puntero a función no lleva datos. El patrón es pasar un
void *contextjunto al callback, que quien recorre transporta sin mirar. - Con el contexto se pierde la revisión de tipos. Que el callback y su contexto concuerden es una promesa de ustedes, y a veces ninguna herramienta lo detecta.
- Una tabla de funciones elige una operación con datos en vez de con un
switch, pero pierde el aviso de-Wswitch. - Un backtracker genérico recibe un
structcon callbacks para las opciones, la validez, poner, deshacer y la solución. El estado va en el contexto, y el motor nunca lo mira.
Ejercicios
Decidan primero y ejecuten después. Todo programa revisa sus lecturas, compila sin advertencias y libera lo que reserva.
-
Declaren un
typedefpara una función que recibe dosinty devuelve unint. Luego, sintypedef, declaren un arreglo de tres punteros a esas funciones. ¿Cuál se lee mejor? -
¿Qué declara cada línea? Escríbanlo en palabras y compruébenlo compilando algo que las use.
a) int *f(int); b) int (*f)(int); c) int (*f[3])(int); d) void g(int (*f)(int), int n); -
Sigan a mano
fold_pricesconlarger_pricesobre{4.5, 25.0, 10.0}, y hagan una tabla como la del capítulo. ¿Por qué aquí el valor inicial esprices[0], y no 0.0? Encuentren un arreglo con el que 0.0 dé un resultado falso. -
Sin compilar, digan qué escribe cada llamada, y luego compruébenlo con un comparador que resta y otro que no. ¿Cuál es comportamiento indefinido?
a) compara 3 y 5 b) compara -5 y 3 c) compara 2000000000 y -2000000000 d) compara INT_MIN y 0 -
Escriban un comparador que ordene un arreglo de
doublede mayor a menor, y otro que ordene cadenas por longitud y, si empatan, en orden alfabético. Pruébenlos con empates. -
Cambien
any_sortpara que lleve unvoid *contextque le pasa al comparador. Úsenlo para contar cuántas comparaciones hace, sin variables globales, y para ordenar unstructpor un criterio elegido al correr. -
Escriban
int count_if_string(const char *const *words, int n, int (*accept)(const char *, void *), void *context)y úsenla para contar las palabras que empiezan con una letra dada. ¿Por qué aquí no basta una función por letra? -
En
errors/wrong_context_silent.c, el 9 pasa el límite. Expliquen qué 4 bytes lee el callback. Cambien eldoublea 15.1 y compruébenlo. ¿El resultado sería igual en otra máquina? -
Agreguen a
calculator.cuna operacióncociente, cuidando la división entre cero. Luego hagan que, sin argumentos, el programa escriba la lista de operaciones, recorriendo la tabla. ¿Cuántas líneas cambiaron? -
Usen el
backtrack.cdel laboratorio, sin cambiarlo, para generar todos los subconjuntos de un arreglo que suman un valor dado. ¿Qué son el paso y la opción? ¿Cuántos nodos visita, con y sin poda enis_valid, en un arreglo de 20 números positivos? Comparen con susubset_sumde la semana pasada.