Apuntes · Capítulo 1Repaso y entornos
Lo esencial de C, otra vez
Lo esencial de C, otra vez
En Introducción a la Computación aprendieron a escribir programas pequeños en C. Pasó un
tiempo, y seguro que algo se olvidó: qué da -7 % 3, por qué 1 / 2 da 0, qué hace
exactamente un for. Este capítulo lo refresca rápido. No vuelve a enseñar C desde cero:
da por hecho que ya lo vieron una vez y va directo a lo que se olvida o se confunde.
Después pone el foco en dos hábitos que van a usar todo el semestre. El primero es separar
lo que calcula de lo que lee y escribe, y probar el cálculo con assert. El segundo es
compilar con -Wall -Wextra y leer cada advertencia como si fuera un error.
El código de este capítulo está en code/week-01. Dentro del
entorno del curso, entren a esa carpeta y corran make para compilar los ejemplos y
make test para comprobarlos. Los comandos de este capítulo se corren desde ahí. Los
programas de errors/ tienen errores a propósito y se compilan a mano, como se muestra en
cada caso.
Ruta de lectura.
- Antes de clase (15 a 20 minutos, obligatoria): la introducción, De qué trata este curso, Cómo usar este repaso y Funciones.
- En clase: un repaso rápido de tipos, operadores, ciclos y funciones, y después Separar el cálculo de la entrada y salida, Probar con
asserty Leer las advertencias.- Después de clase: Tipos:
int,double,char, Operadores y Decisiones y ciclos, según lo que cada uno necesite repasar. Antes del laboratorio, El entorno,makey Git y El laboratorio, paso a paso. Luego el Resumen y los Ejercicios. Para ir más allá: los últimos ejercicios del capítulo.
De qué trata este curso
Un programa de 30 líneas cabe en la cabeza. Se puede leer de una vez, y si falla, se mira todo hasta encontrar el error. Con los programas que van a escribir en este curso eso deja de funcionar. La próxima semana leerán un programa ajeno de unas 200 líneas, y al final del semestre tendrán un intérprete de un lenguaje pequeño. Nadie sostiene algo así completo en la cabeza, ni siquiera quien lo escribió.
Un programa grande no es uno pequeño con más líneas: pide otras herramientas.
| Problema de un programa grande | Lo que aprenderán |
|---|---|
| No se puede entender todo a la vez | Leer con método, esconder detalles detrás de una interfaz, dividir en módulos |
| No se sabe qué pasa en la memoria | El modelo de entornos, punteros, memoria dinámica, ASan y valgrind |
| Un cambio aquí rompe algo allá | Pruebas que se corren después de cada cambio |
| El error está lejos de donde se nota | Depurar con método, con gdb y con los sanitizers |
| El problema es demasiado difícil de frente | Descomponer: recursión, backtracking, funciones como valores |
El curso tiene cuatro partes: repaso y entornos, memoria y abstracción, recursión, y un intérprete. El calendario y las políticas están en el programa del curso.
Lo que cambia respecto al curso anterior es dónde se aprende. Cada semana hay 2 horas de teoría y 4 de laboratorio, en dos sesiones. El laboratorio es el centro del curso. Trae código que ustedes reciben, leen y extienden, y sus pruebas. No hay libro: estos apuntes son el texto.
Idea clave. Casi siempre se lee más código del que se escribe. Antes de cambiar un programa, hay que entenderlo. Por eso cada laboratorio empieza leyendo.
Cómo usar este repaso
Cada sección apunta a la semana de Introducción a la Computación donde se vio el tema. Si algo de aquí les resulta nuevo, no sigan de largo: vuelvan a esa semana. La prueba diagnóstica de la primera sesión de laboratorio les dirá lo mismo con más precisión.
| Tema | Semana de Introducción a la Computación |
|---|---|
Variables, tipos, operadores, printf, scanf |
2 |
| Bits, overflow, punto flotante, ASCII, Git | 3 |
if, else if, lógica, cortocircuito |
4 |
while, for, do while, salirse por uno |
5 |
| Ciclos anidados | 6 |
Funciones, paso por valor, assert, gdb |
7 |
Tipos: int, double, char
Usamos tres tipos casi todo el tiempo. Sus tamaños y límites dependen del sistema, y estos son los del entorno del curso:
$ build/types
int: 4 bytes, de -2147483648 a 2147483647
double: 8 bytes
char: 1 byte
7 tiene el código 55 y vale 7
0.30000000000000004
x no es igual a 0.3
Las tres últimas líneas son tres recordatorios.
char es un número pequeño. El carácter '7' no vale 7: vale 55, su código ASCII. Como
los dígitos están seguidos en la tabla, digit - '0' da el valor de la cifra.
char digit = '7';
printf("%c tiene el código %d y vale %d\n", digit, digit, digit - '0');
double es aproximado. La suma 0.1 + 0.2 no da exactamente 0.3, porque ninguno de esos
tres números tiene representación exacta en binario.
double x = 0.1 + 0.2;
printf("%.17f\n", x);
if (x == 0.3) {
Por eso nunca se comparan dos double con ==. Y por eso, cuando un programa maneja dinero,
conviene contar en céntimos con un int. Es lo que haremos en el ejemplo de este capítulo.
int tiene un límite. Pasarse del mayor int es overflow, y en C es comportamiento
indefinido (undefined behavior): el lenguaje no promete nada de lo que pase después. Los
programas del curso se compilan con el sanitizer, que avisa mientras el programa corre. La
primera línea es la que importa. La segunda es lo que salió en esta corrida, y C no promete
ese resultado:
$ build/overflow
overflow.c:7:9: runtime error: signed integer overflow: 2147483647 + 1 cannot be represented in type 'int'
-2147483648
En C.
INT_MAXeINT_MIN, enlimits.h, son el mayor y el menorint. Fíjense en que-INT_MINno cabe: hay un negativo más que positivos. Esto va a importar en el laboratorio.
La división depende de los operandos
Esta es la confusión más repetida de C. En division.c:
int a = 7, b = 2;
printf("%d %.1f\n", a / b, (double) a / b);
$ build/division
3 3.5
0.0 0.5
3La primera línea muestra las dos divisiones. Entre dos int, / es división entera:
7 / 2 da 3. El cast (double) a convierte a antes de dividir, porque el cast se aplica
primero que /. Así, la división es entre double y da 3.5.
La segunda línea es la trampa de siempre:
double half = 1 / 2;
double real_half = 1.0 / 2;
La variable half es double, pero 1 / 2 se calcula antes, entre dos enteros, y da 0. Lo
que manda es el tipo de los operandos, no el de la variable que recibe.
La tercera línea es la conversión contraria. Pasar de double a int descarta los decimales
y no redondea:
int truncated = 3.99;Operadores
Los operadores son los mismos de siempre. Vale la pena recordar tres detalles, y están todos
en operators.c:
printf("%d %d\n", 7 / 2, -7 / 2);
printf("%d %d\n", 7 % 3, -7 % 3);
printf("%d %d\n", 2 + 3 * 4, (2 + 3) * 4);
$ build/operators
3 -3
1 -1
14 20
Sin datos o promedio bajo- La división entera se acerca a 0.
-7 / 2da -3, no -4. - El resto lleva el signo del dividendo.
-7 % 3da -1, no 2. Sines negativo,n % 10es negativo o 0. Una cuenta que funciona con positivos puede fallar en silencio con negativos. - La multiplicación va antes que la suma, y los paréntesis lo cambian. Si dudan de una precedencia, pongan paréntesis.
La última línea sale del cortocircuito (short-circuit). && no calcula su lado derecho si
el izquierdo ya es falso, y || no lo calcula si el izquierdo ya es verdadero. Por eso, esto no
divide entre 0, aunque count valga 0:
if (count != 0 && total / count > 10) {El orden importa: con los dos lados al revés, primero se dividiría entre 0.
Error común.
=asigna y==compara.if (grade = 20)no pregunta nada: guarda 20 engrade, y como 20 no es 0, la condición es verdadera. Tampoco existe la comparación encadenada:0 <= grade <= 20no significa lo que parece. El compilador avisa de los dos, como veremos.
Decisiones y ciclos
Tres ciclos para tres situaciones
Los tres ciclos de C pueden hacer lo mismo, pero cada uno le dice algo distinto al lector.
En loops.c:
| Ciclo | Cuándo se usa | Ejemplo |
|---|---|---|
for |
Se sabe cuántas vueltas da | Recorrer de 1 a n |
while |
Depende de una condición, y quizá no corra ninguna vez | Dividir hasta llegar a 1 |
do while |
Corre al menos una vez | Contar cifras, porque el 0 tiene una |
int count_multiples(int n, int step) {
    int count = 0;
    for (int i = 1; i <= n; i++) {
        if (i % step == 0) {
            count = count + 1;
        }
    }
    return count;
}
int count_digits(int n) {
int count = 0;
do {
count = count + 1;
n = n / 10;
} while (n != 0);
return count;
}$ build/loops
3
6
4 1 2La tercera línea son count_digits(2026), count_digits(0) y count_digits(-42). La condición
n != 0 también sirve para los negativos, porque la división entera se acerca a 0. Con
n > 0, el -42 daría una sola vuelta.
Salirse por uno
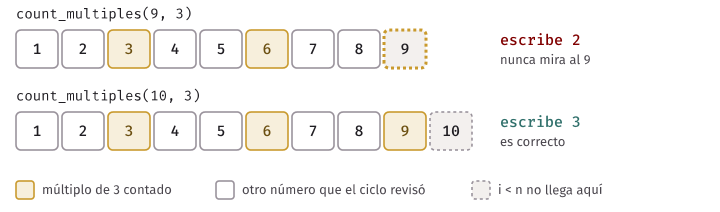
El error más típico en un ciclo es dar una vuelta de más o de menos. En off_by_one.c, la
condición dice i < n en lugar de i <= n:
for (int i = 1; i < n; i++) {$ build/off_by_one
2
3Entre 1 y 9 hay tres múltiplos de 3, y el programa escribe 2: nunca mira al propio 9. Con 10 da 3, y es correcto. El mismo bug acierta con un dato y falla con otro. Por eso un solo caso de prueba no demuestra nada, y por eso hay que probar justo en los bordes.
Idea clave. Al escribir un ciclo, revisen tres cosas: con qué valor empieza, con qué valor termina y qué pasa si no da ninguna vuelta.
Leer hasta el final de la entrada
scanf devuelve cuántos datos leyó. Toda lectura revisa ese número, y además sirve de condición
para un ciclo. En grades_average.c:
while (scanf("%d", &grade) == 1) {
    total = total + grade;
    count = count + 1;
}
$ echo 12 8 15 | build/grades_average
3 notas, promedio 11.67El ciclo termina cuando se acaba la entrada o cuando llega algo que no es un número. Si se corre sin datos, hay que revisarlo antes de dividir:
if (count == 0) {
    printf("No hay notas\n");
$ build/grades_average < /dev/null
No hay notasSi lo corren a mano, el programa se queda esperando, y Ctrl+D le dice que la entrada terminó.
Funciones
Una función tiene un tipo de retorno, un nombre, parámetros y un cuerpo. Definirla no la ejecuta: solo se ejecuta al llamarla. Si se llama antes de definirla, hace falta un prototipo, que la anuncia. Las siguientes cuatro reglas son las que más se olvidan.
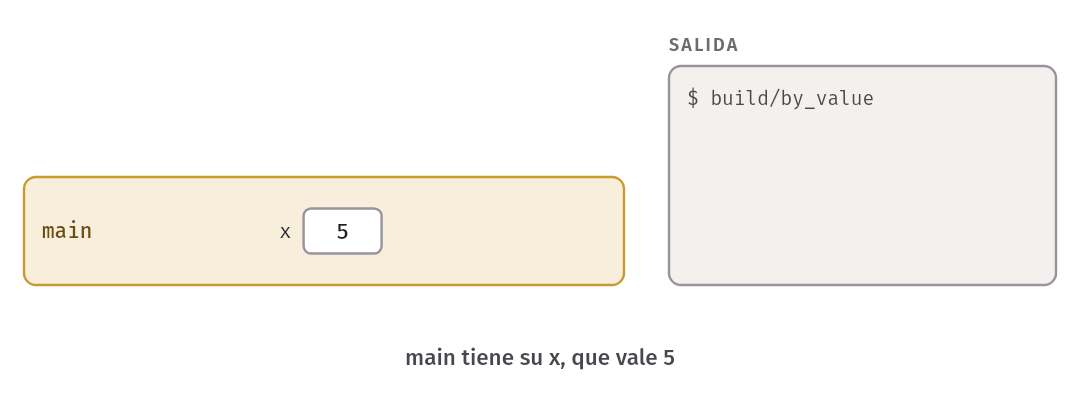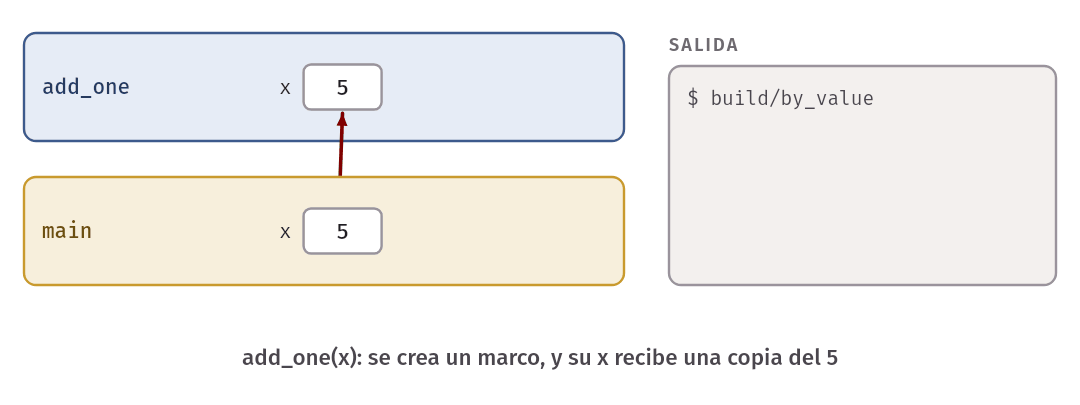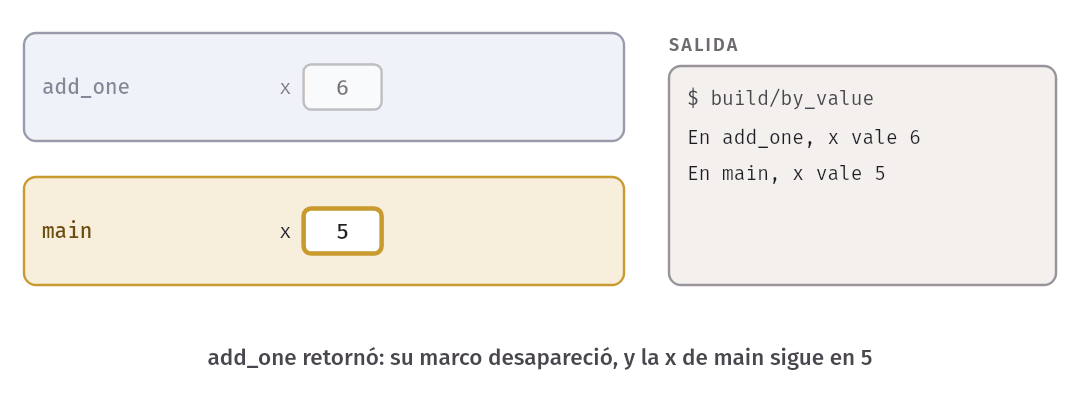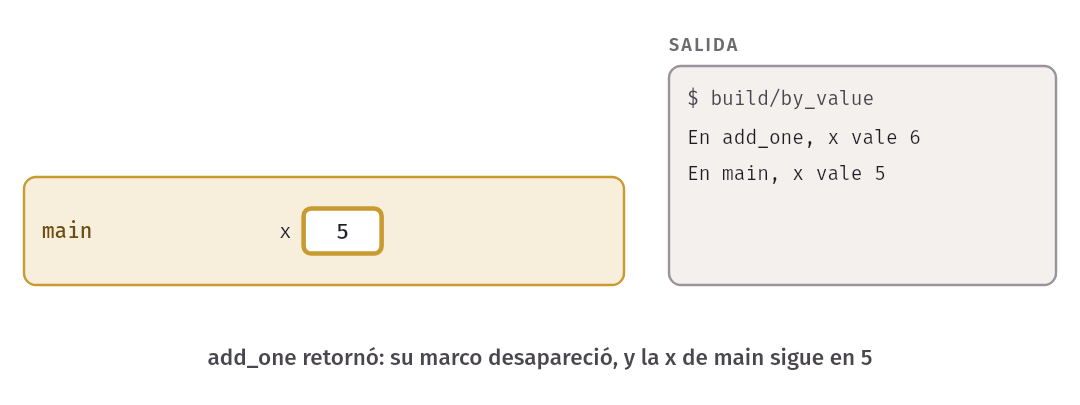
Un parámetro siempre recibe una copia. Se llama paso por valor (pass by value), y es la
idea más importante de esta sección. En by_value.c:
void add_one(int x);
void try_swap(int a, int b);
void add_one(int x) {
x = x + 1;
printf("En add_one, x vale %d\n", x);
}void try_swap(int a, int b) {
int saved = a;
a = b;
b = saved;
printf("En try_swap, a = %d y b = %d\n", a, b);
}$ build/by_value
En add_one, x vale 6
En main, x vale 5
En try_swap, a = 2 y b = 1
En main, first = 1 y second = 2add_one cambia su copia. La x de main sigue en 5, aunque se llamen igual: son dos variables
distintas. try_swap intercambia sus copias, y main no se entera.
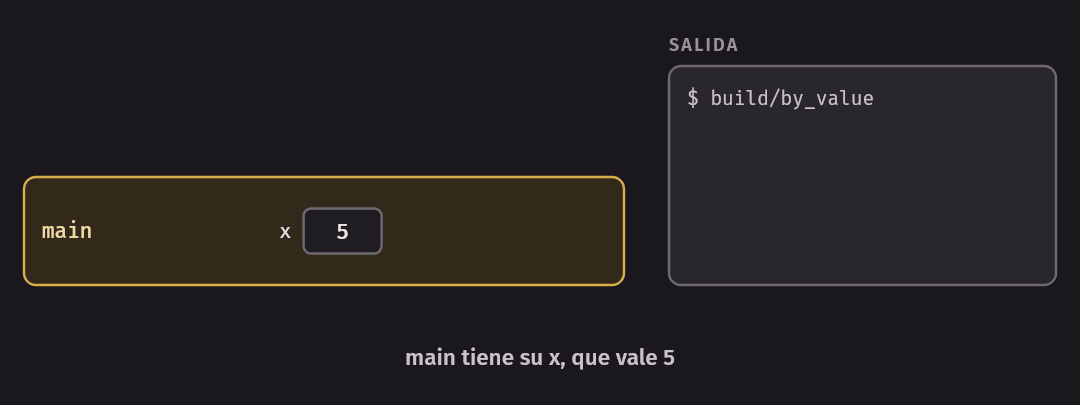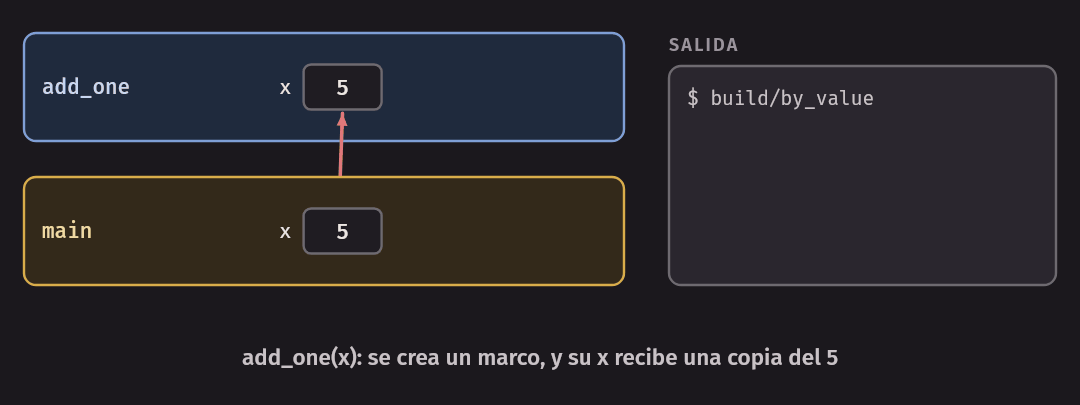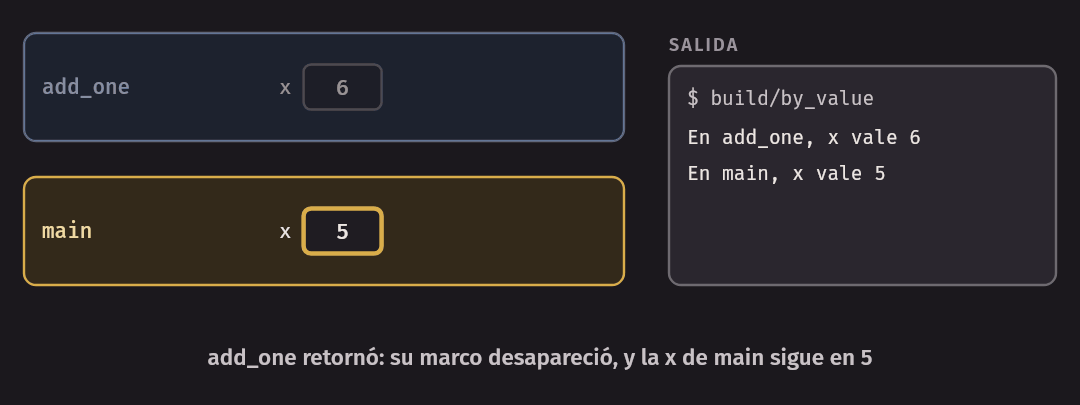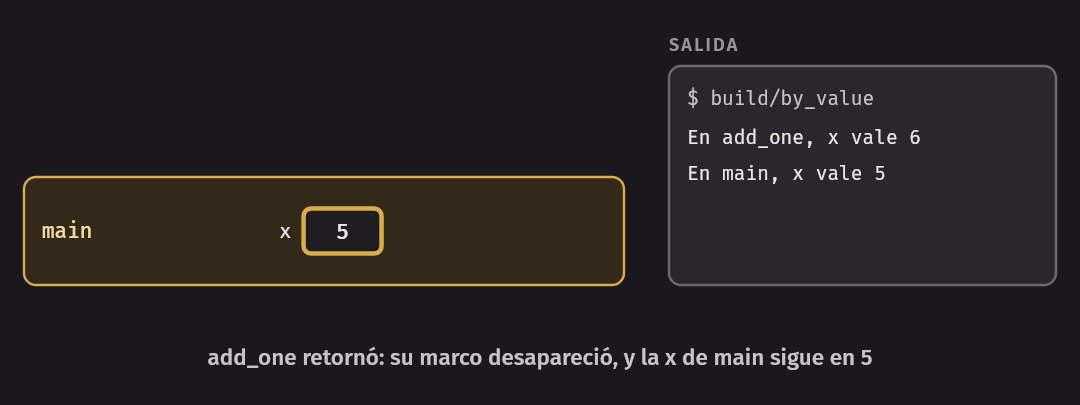
Una función devuelve un solo valor. Con paso por valor, return es el único camino de vuelta.
¿Y si hacen falta dos resultados, como en un intercambio? La respuesta correcta llega en la
semana 4, con los punteros. La semana 3 da el modelo que explica por qué try_swap no puede funcionar, y la semana 4 dibuja ese mismo intento.
Un return termina la función de inmediato, aunque esté dentro de un ciclo. Y una función que
no es void debe devolver algo en todos sus caminos. Esto lo veremos enseguida con
-Wreturn-type.
C convierte los argumentos sin avisar. Si la función recibe int y le pasan 2.5, recibe un 2.
Esto no lo detecta -Wall -Wextra:
printf("%d\n", square(2.5));$ gcc -Wall -Wextra -std=c17 errors/double_argument.c -o build/double_argument
$ build/double_argument
4Separar el cálculo de la entrada y salida
Este es el hábito más importante del capítulo. Lo veremos con un ejemplo: cuántas monedas hacen
falta para dar un vuelto. En Perú, las monedas son de 10, 20 y 50 céntimos y de 1, 2 y 5 soles.
Contamos en céntimos, con int, para no depender de double. La idea es dar siempre la moneda
más grande que no se pase del monto.
algoritmo monedas_necesarias(centimos)
    si centimos < 0 o centimos mod 10 ≠ 0 entonces
        devolver -1
    fin si
    monedas ← 0
    mientras centimos > 0 hacer
        centimos ← centimos - moneda_mayor(centimos)
        monedas ← monedas + 1
    fin mientras
    devolver monedas
fin algoritmo
Sigamos 380 céntimos, es decir, S/ 3.80.
| Vuelta | cents al empezar |
Moneda | cents al terminar |
coins |
|---|---|---|---|---|
| 1 | 380 | 200 | 180 | 1 |
| 2 | 180 | 100 | 80 | 2 |
| 3 | 80 | 50 | 30 | 3 |
| 4 | 30 | 20 | 10 | 4 |
| 5 | 10 | 10 | 0 | 5 |
Elegir siempre la más grande funciona con estas monedas, y make test lo compara con otra cuenta
hasta 20 soles. No funciona con cualquier conjunto: con monedas de 1, 3 y 4, para dar 6 elegiría
4, 1 y 1, cuando 3 y 3 alcanzan.
Primera versión: todo junto
change_print.c lo hace todo dentro de main: lee, calcula y escribe. Esta es la parte que
calcula:
int left = cents;
int coins = 0;
while (left > 0) {
    if (left >= 500) {
        left = left - 500;
    } else if (left >= 200) {
        left = left - 200;
$ echo 380 | build/change_print
Para 380 céntimos hacen falta 5 monedasFunciona. Ahora pregúntense: ¿cómo sabemos que da bien con 10, con 500, con 490 y con -10? Solo hay una forma: correrlo una vez por cada dato, escribir el número y leer la frase que sale. Es lento, nadie lo repite después de cada cambio, y el resultado es un texto en la pantalla, no un número que otro código pueda comparar. Además, ese cálculo no se puede reutilizar: está pegado a la lectura y a la frase.
Esa es la respuesta a por qué una función que calcula y además imprime es más difícil de probar. Lo que produce no vuelve a quien la llama: se va a la pantalla, y quien la llama no puede preguntar si el resultado fue el correcto.
Segunda versión: el cálculo en una función
change.c separa las piezas. Ninguna de estas dos funciones lee ni escribe:
int largest_coin(int cents) {
    if (cents >= 500) {
        return 500;
    } else if (cents >= 200) {
        return 200;
    } else if (cents >= 100) {
        return 100;
    } else if (cents >= 50) {
        return 50;
    } else if (cents >= 20) {
        return 20;
    }
    return 10;
}
int coins_needed(int cents) {
if (cents < 0 || cents % 10 != 0) {
return -1;
}
int coins = 0;
while (cents > 0) {
cents = cents - largest_coin(cents);
coins = coins + 1;
}
return coins;
}main queda solo con la entrada y la salida. Lee, llama a la función y decide qué escribir:
int coins = coins_needed(cents);
if (coins < 0) {
    printf("No se puede dar %d céntimos en monedas\n", cents);
    return 1;
}

printf("Para %d céntimos hacen falta %d monedas\n", cents, coins);
Desde afuera, se comporta igual:
$ echo 380 | build/change
Para 380 céntimos hacen falta 5 monedas
$ echo 15 | build/change
No se puede dar 15 céntimos en monedas
$ echo abc | build/change
Entrada inválida
Fíjense en que coins_needed modifica cents dentro de la función, y no hay problema: es su
copia. main puede seguir escribiendo el monto original.
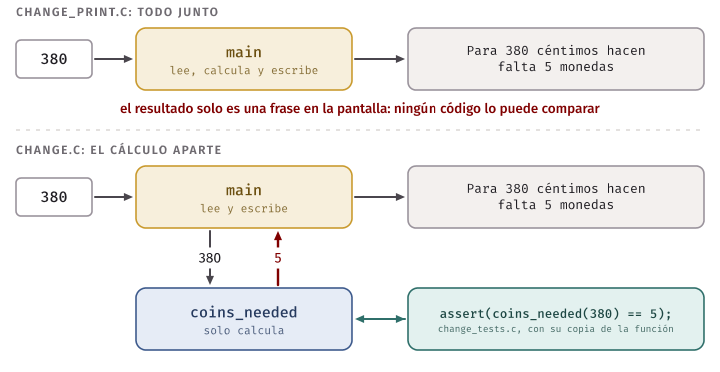
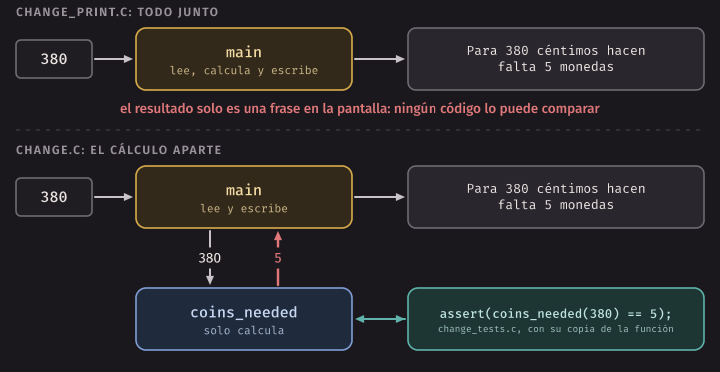
Idea clave. Dejen la lectura y la escritura en
main, y los cálculos en funciones que reciben parámetros y devuelven un resultado. Es lo que permite probarlos. Esta separación la van a usar todas las semanas.
Probar con assert
Una prueba (test) es un programa que comprueba otro. assert(condición);, de assert.h, no hace
nada si la condición es verdadera. Si es falsa, escribe qué falló y detiene el programa. Con el
cálculo separado, probarlo es llamar a la función con datos cuyo resultado ya conocemos. En change_tests.c:
assert(coins_needed(380) == 5);     // caso normal: 200, 100, 50, 20, 10
assert(coins_needed(0) == 0);       // el menor monto: no se da ninguna moneda
assert(coins_needed(10) == 1);      // la moneda más chica
assert(coins_needed(500) == 1);     // justo una moneda grande
assert(coins_needed(490) == 5);     // justo debajo de 500
assert(coins_needed(1000) == 2);    // más de una moneda grande
assert(coins_needed(15) == -1);     // no es múltiplo de 10
assert(coins_needed(-10) == -1);    // negativo

printf("Todas las pruebas pasaron\n");
$ build/change_tests
Todas las pruebas pasaronCada programa de esta semana está en un solo archivo, así que change_tests.c trae una copia de las
funciones. Repartir un programa en varios archivos es tema de la semana 6.
Una prueba que encuentra un bug
change_bug.c es igual, salvo por un carácter en largest_coin:
if (cents > 500) {La condición debía ser >=. Con 380 los montos nunca llegan a 500, así que > y >= dan lo mismo
y el caso normal pasa. La salida depende en parte del sistema. La primera línea la escribe assert.
Aborted y el 134 que da echo $? los da el shell de este entorno, porque el programa terminó de
forma abrupta.
$ build/change_bug
change_bug: change_bug.c:37: main: Assertion `coins_needed(500) == 1' failed.
Aborted
$ echo $?
134
El mensaje dice el archivo, la línea, la función y la condición que resultó falsa. Pasaron las pruebas de 380, 0 y 10, y falló la primera que miraba el borde. Con 500, la versión con el bug da 200, 200 y 100: tres monedas. Es un monto válido y una respuesta creíble, y sin esa prueba nadie lo habría notado.
Elegir los casos
Los errores se esconden en los bordes. Antes de escribir una función, piensen qué datos pueden romperla. Esta lista sirve casi siempre.
| Tipo de caso | Por ejemplo | Qué busca |
|---|---|---|
| Normal | Un dato común | Que la idea sea correcta |
| Cero | 0 | Un ciclo que no corre, una división entre 0 |
| Límite de una condición | 499, 500, 501 | < en lugar de <= |
| El menor o el mayor | 1, INT_MAX, INT_MIN |
Overflow |
| Negativos | -1, -7 | El resto y la división con signo |
| Datos que no valen | 15 céntimos | Que responda lo acordado, no cualquier cosa |
| Un caso por cada camino | Cada rama del if |
Una rama que nunca se probó |
Apliquemos la lista a is_prime, que escribirán en el laboratorio. Antes de programar, ya se
pueden elegir los casos:
n |
¿Primo? | Qué error descubre |
|---|---|---|
| 13 | sí | La idea general |
| 2 | sí | Un ciclo que empieza mal y descarta al menor primo |
| 1, 0 | no | Un ciclo que no corre y deja la respuesta en “primo” |
| -7 | no | Olvidar los negativos |
| 4, 49 | no | Parar antes de la raíz: en un cuadrado perfecto, el divisor es justo la raíz |
INT_MAX |
sí | Una condición i * i <= n, porque i * i no cabe en un int |
Un caso en el que nadie pensó no prueba nada. Las pruebas no demuestran que un programa esté bien: muestran que no falló con esos datos. Por eso hay que elegirlos con cuidado.
Error común. No validen la entrada del usuario con
assert. Que alguien escribaabcno es un error del programador: es algo que puede pasar, y se responde con un mensaje.assertse puede apagar, compilando con-DNDEBUG, y entonces desaparecen esas líneas enteras. Por eso, nunca pongan dentro de unassertalgo que deba ocurrir siempre, como unscanf.
Leer las advertencias
gcc puede avisar de código que compila, pero que casi seguro está mal. Solo lo hace si se lo piden:
-Wallactiva las advertencias más útiles. A pesar del nombre, no son todas.-Wextraagrega otras.-std=c17fija la versión del lenguaje.
Una advertencia (warning) no detiene el compilador: genera el ejecutable igual. Por eso es tan fácil no hacerle caso. Y por eso en este curso, una advertencia se trata como un error: se lee y se corrige. Veamos las que más van a encontrar.
Una función sin return
int is_passing(int grade) {
    if (grade >= 11) {
        return 1;
    }
}
Si la nota es menor que 11, la función llega al final sin devolver nada, y usar ese resultado es
comportamiento indefinido. El compilador avisa con -Wreturn-type, que viene dentro de -Wall. Esto
salió en esta corrida, y en otra computadora puede salir otra cosa:
$ gcc -Wall -Wextra -std=c17 errors/missing_return.c -o build/missing_return
errors/missing_return.c: In function ‘is_passing’:
errors/missing_return.c:8:1: warning: control reaches end of non-void function [-Wreturn-type]
    8 | }
      | ^
$ build/missing_return
5
La función debía dar 1 o 0, y salió 5. Lo que importa es que el programa corrió y escribió un número
creíble. No hubo ningún error en la pantalla. Sin la advertencia, solo quedaría buscar por qué el
resultado es raro. Y el sanitizer no vigila este caso en C. main es la única excepción: si llega al
final sin return, equivale a return 0.
Asignar en vez de comparar
if (grade = 20) {$ gcc -Wall -Wextra -std=c17 errors/assign_in_if.c -o build/assign_in_if
errors/assign_in_if.c: In function ‘main’:
errors/assign_in_if.c:7:9: warning: suggest parentheses around assignment used as truth value [-Wparentheses]
7 | if (grade = 20) {
| ^~~~~
$ build/assign_in_if
Nota perfecta: 20La nota era 12. El programa no solo tomó el camino equivocado: también cambió la variable.
Comparaciones encadenadas
if (0 <= grade <= 20) {$ gcc -Wall -Wextra -std=c17 errors/chained_compare.c -o build/chained_compare
errors/chained_compare.c: In function ‘main’:
errors/chained_compare.c:7:20: warning: comparison of constant ‘20’ with boolean expression is always true [-Wbool-compare]
7 | if (0 <= grade <= 20) {
| ^~
errors/chained_compare.c:7:11: warning: comparisons like ‘X<=Y<=Z’ do not have their mathematical meaning [-Wparentheses]
7 | if (0 <= grade <= 20) {
| ~~^~~~~~~~
$ build/chained_compare
Nota válidaSe calcula 0 <= grade, que da 0 o 1, y ese resultado se compara con 20. Siempre es verdadero, aunque la
nota sea 25. Se escribe 0 <= grade && grade <= 20.
Formato equivocado
printf("Promedio: %d\n", average);La segunda línea de la salida no significa nada, y cambia de una corrida a otra:
$ gcc -Wall -Wextra -std=c17 errors/wrong_format.c -o build/wrong_format
errors/wrong_format.c: In function ‘main’:
errors/wrong_format.c:7:24: warning: format ‘%d’ expects argument of type ‘int’, but argument 2 has type ‘double’ [-Wformat=]
    7 |     printf("Promedio: %d\n", average);
      |                       ~^     ~~~~~~~
      |                        |     |
      |                        int   double
      |                       %f
$ build/wrong_format
Promedio: -834603544
Fíjense en cuánta ayuda da este mensaje: dice qué esperaba, qué recibió, y hasta sugiere %f.
Por qué también -Wextra
-Wall solo no avisa de un parámetro que nadie usa, y casi siempre es señal de un olvido:
int next_value(int value, int step) {
    return value + 1;
}
$ gcc -Wall -std=c17 errors/unused_parameter.c -o build/unused_parameter
$ gcc -Wall -Wextra -std=c17 errors/unused_parameter.c -o build/unused_parameter
errors/unused_parameter.c: In function ‘next_value’:
errors/unused_parameter.c:4:31: warning: unused parameter ‘step’ [-Wunused-parameter]
4 | int next_value(int value, int step) {
| ~~~~^~~~Las advertencias no lo ven todo
Una variable sin valor inicial es comportamiento indefinido, y aquí gcc no avisa, ni con
-Wall -Wextra, aunque total se usa sin haber recibido un valor:
int total;for (int i = 1; i <= 3; i++) {
total = total + i;
}La suma de 1, 2 y 3 es 6, pero en esta corrida el programa escribió 8. En otra computadora puede
salir otra cosa. Si se le pide optimizar con -O2, el compilador analiza más el programa y ahí sí
lo nota:
$ gcc -Wall -Wextra -std=c17 errors/uninitialized.c -o build/uninitialized
$ build/uninitialized
8
$ gcc -Wall -Wextra -std=c17 -O2 errors/uninitialized.c -o build/uninitialized_o2
errors/uninitialized.c: In function ‘main’:
errors/uninitialized.c:8:15: warning: ‘total’ is used uninitialized [-Wuninitialized]
    8 |         total = total + i;
      |         ~~~~~~^~~~~~~~~~~
errors/uninitialized.c:4:9: note: ‘total’ was declared here
    4 |     int total;
      |         ^~~~~
Que no haya advertencias no significa que no haya errores. Por eso hacen falta varias herramientas.
| Herramienta | Cuándo actúa | Qué encuentra |
|---|---|---|
-Wall -Wextra |
Al compilar | Código sospechoso, sin correr nada |
Sanitizer (-fsanitize=address,undefined) |
Mientras corre | Overflow, accesos fuera de un arreglo (array), y más. Solo en lo que de verdad se ejecuta |
assert |
Mientras corre | Resultados distintos de los que ustedes esperaban |
gdb |
Cuando ustedes lo usan | Nada por sí solo: les deja mirar el programa por dentro |
En C. Con
-Werror, el compilador trata cada advertencia como un error y no genera el ejecutable. Es útil si les cuesta resistir la tentación de ignorarlas:$ gcc -Wall -Wextra -Werror -std=c17 errors/missing_return.c -o build/missing_return errors/missing_return.c: In function ‘is_passing’: errors/missing_return.c:8:1: error: control reaches end of non-void function [-Werror=return-type] 8 | } | ^ cc1: all warnings being treated as errors
Lean los mensajes desde el primero. Un error temprano suele provocar otros después, y al corregir el
primero, esos desaparecen. Cada mensaje trae archivo, línea y columna: errors/missing_return.c:8:1
quiere decir línea 8, columna 1.
El entorno, make y Git
El entorno
Todo el curso se trabaja en un mismo entorno, con Codespaces o con Docker. Las instrucciones para abrirlo
están en labs/README.md. Lo primero es comprobar que funciona. Desde la carpeta
del curso se corre env/check.sh, y desde la carpeta de esta semana:
$ ../../env/check.sh
ok    gcc compila C17 sin advertencias
ok    el programa en C se ejecuta
ok    el sanitizer compila
ok    el sanitizer detecta un error de memoria
ok    make
ok    gdb
ok    valgrind
ok    git
ok    Python 3.14 (corre las pruebas)
make
Cada semana trae un Makefile, un archivo que dice cómo compilar el código de esa carpeta. En vez de
escribir el comando de gcc cada vez, se escribe make, que además vuelve a compilar solo lo que
cambió.
| Comando | Qué hace |
|---|---|
make |
Compila los programas de la clase en build/ |
make test |
Corre los programas de la clase y comprueba lo que estos apuntes dicen de ellos |
make test-diagnostic |
Comprueba solo la prueba diagnóstica (lab/diagnostic.c). Solo existe esta semana |
make test-lab |
Prueba todo su laboratorio. Falla hasta que lo terminen |
make clean |
Borra lo generado |
Las pruebas corren con Python, pero Python solo es la herramienta que las ejecuta. No hace falta saberlo,
ni se enseña en este curso. Un make test que pasa termina así. El tiempo depende de la máquina, y las pruebas saltadas (skipped)
son las de la solución del laboratorio, que no está en su carpeta:
$ make test
...
----------------------------------------------------------------------
Ran 48 tests in 3.619s

OK (skipped=22)
Git
En la semana 3 de Introducción a la Computación vieron git init, git add, git commit y git log. Lo
nuevo es git clone, que copia un repositorio entero, con todo su historial, a una carpeta nueva. Es la
forma normal de empezar a trabajar con un repositorio que ya existe. Normalmente recibe una dirección de
GitHub, pero también acepta una carpeta, y así podemos probarlo sin internet:
$ cd /tmp
$ git config --global user.name "Ana Quispe"
$ git config --global user.email "ana@example.com"
$ git init -b main proyecto
Initialized empty Git repository in /tmp/proyecto/.git/
$ cd proyecto
$ echo 12 > notas.txt
$ git add notas.txt
$ git commit -m "Primera nota"
[main (root-commit) f81b155] Primera nota
 1 file changed, 1 insertion(+)
 create mode 100644 notas.txt
$ cd ..
$ git clone proyecto copia
Cloning into 'copia'...
done.
$ cd copia
$ ls
notas.txt
$ echo 15 >> notas.txt
$ git status --short
 M notas.txt
$ git add notas.txt
$ git commit -m "Agrega una nota"
[main a5079b5] Agrega una nota
 1 file changed, 1 insertion(+)
$ git log --oneline
a5079b5 Agrega una nota
f81b155 Primera nota
$ cd ../proyecto
$ git log --oneline
f81b155 Primera nota
Los identificadores como f81b155 serán otros en su máquina. Y la última línea es lo que hay que notar: el
commit nuevo está en copia, y proyecto no se enteró. Cada copia tiene su propio historial. Enviar commits
de una a otra se hace con git push, que por ahora no vamos a necesitar.
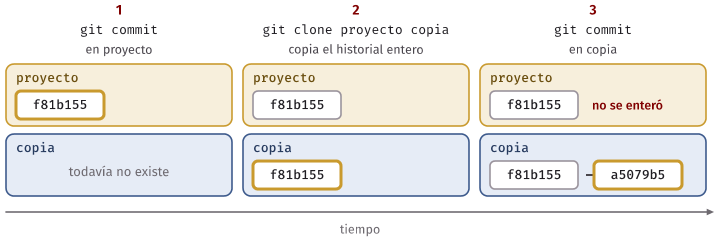
Los dos comandos de git config --global se hacen una sola vez por entorno. Sin ellos, Git no sabe quién firma
los commits y no deja crearlos. Usen su nombre y su correo.
Idea clave. Hagan un commit cada vez que algo funcione. Si un cambio posterior lo rompe, tienen a dónde volver.
El laboratorio, paso a paso
Son dos sesiones, con todo el código en code/week-01/lab/. Empiecen por leer el comentario al inicio de cada
archivo: es el enunciado, y dice exactamente qué debe hacer cada función. Las versiones que reciben compilan, pero
están mal a propósito: solo sirven para empezar.
Sesión 1: entorno y prueba diagnóstica
- Abran el entorno y corran
env/check.sh. Todas las líneas deben decirok. - Entren a
code/week-01y corranmakeymake test. - Repitan la sesión de Git de arriba en una carpeta de prueba.
- Hagan la prueba diagnóstica, en
lab/diagnostic.c. No tiene nota. Su único fin es que cada uno sepa qué debe repasar, así que háganla con honestidad.
| Función | Qué revisa | Si falla, repasen |
|---|---|---|
average_of_two |
División y conversión entre tipos | Semana 2 |
digit_value |
char como número, ASCII |
Semanas 2 y 3 |
clamp |
if y else if, bordes |
Semana 4 |
sum_to |
Ciclos, salirse por uno | Semana 5 |
dice_ways |
Ciclos anidados | Semana 6 |
Para comprobarla, corran make test-diagnostic. Así se ve una falla con las versiones que reciben:
$ make test-diagnostic
...
test_average_of_two (test_lab.DiagnosticTests.test_average_of_two) ... FAIL
test_clamp (test_lab.DiagnosticTests.test_clamp) ... FAIL
test_dice_ways (test_lab.DiagnosticTests.test_dice_ways) ... FAIL
test_digit_value (test_lab.DiagnosticTests.test_digit_value) ... FAIL
test_no_warnings (test_lab.DiagnosticTests.test_no_warnings) ... ok
test_sum_to (test_lab.DiagnosticTests.test_sum_to) ... FAIL
...
FAIL: test_sum_to (test_lab.DiagnosticTests.test_sum_to)
----------------------------------------------------------------------
AssertionError: Lists differ: [1, 2, 4, 10, 100, 1000, 0, -1, -50] != [1, 3, 10, 55, 5050, 500500, 0, 0, 0]

First differing element 1:
2
3

- [1, 2, 4, 10, 100, 1000, 0, -1, -50]
+ [1, 3, 10, 55, 5050, 500500, 0, 0, 0] : Datos: 1, 2, 4, 10, 100, 1000, 0, -1, -50. Conviene repasar: ciclos, y salirse por uno, semana 5.
La línea que empieza con - es lo que devolvió su función, y la que empieza con + es lo correcto, una lista con
un resultado por cada dato de prueba. Al final dice con qué datos se probó y qué conviene repasar. Si test_no_warnings falla, su código
tiene advertencias: léanlas y corríjanlas.
Sesión 2: funciones con sus pruebas
En lab/numbers.c van digit_sum, is_prime y gcd, y en su main, las pruebas con assert. Escriban primero las
pruebas, como hicimos con las monedas: al elegir los casos, ya están pensando en lo difícil.
digit_sum. La vieron en la semana 7, pero solo con números no negativos. Ahora el signo no cuenta: digit_sum(-407) es
11. Recuerden que en C el resto de un negativo es negativo. La salida fácil, cambiarle el signo a n al inicio, falla con
INT_MIN, porque su negativo no cabe en un int, y el sanitizer los va a avisar. Piensen en otra manera.
is_prime. Ya tienen los casos en la tabla de arriba. Recuerden: “es primo” solo se sabe después de terminar el ciclo.
Basta con buscar divisores hasta la raíz, y i <= n / i lo dice sin el overflow de i * i <= n.
gcd. Para el máximo común divisor, mientras b no sea 0, se reemplaza (a, b) por (b, a mod b), y al final el resultado es
a. Sigan gcd(48, 18):
a |
b |
a % b |
|---|---|---|
| 48 | 18 | 12 |
| 18 | 12 | 6 |
| 12 | 6 | 0 |
| 6 | 0 | termina: devuelve 6 |
Ahora los negativos. El máximo común divisor nunca es negativo, pero el algoritmo, tal cual, sí puede terminar en uno:
a |
b |
a % b |
|---|---|---|
| 12 | -18 | 12 |
| -18 | 12 | -6 |
| 12 | -6 | 0 |
| -6 | 0 | termina: devolvería -6 |
collatz_steps, en lab/collatz.c. La sucesión de Collatz, que vieron como ejercicio en la semana 5, empieza en un entero
n mayor o igual que 1. Mientras no sea 1: si es par, se divide entre 2; si es impar, se reemplaza por 3 * n + 1. Con 6, la
sucesión es:
6 → 3 → 10 → 5 → 16 → 8 → 4 → 2 → 1Son 8 pasos, y no 9: se cuentan las flechas, no los números. Con 1 son 0 pasos. Nadie ha demostrado que esta sucesión llegue a 1
para todo entero positivo, aunque se ha comprobado con números enormes. Por eso importa acotar: dentro de este laboratorio solo
la usamos con n menor que 10 000, donde todo cabe en un int.
Después, longest_collatz(limit) devuelve el número menor que limit con más pasos. Para esto no hace falta devolver dos valores.
La función devuelve el número, y main, que ya lo tiene, vuelve a llamar a collatz_steps para saber cuántos pasos da. ¿Cuál es el
número menor que 10 000 con más pasos? Corran build/lab/collatz y lo sabrán.
Error común. Una búsqueda necesita recordar dos cosas mientras recorre: el mejor número hasta ahora y sus pasos. Si guardan solo el número, tendrán que volver a calcular sus pasos en cada vuelta. Y empiecen con cuidado: el primer candidato es 1, que da 0 pasos.
Comprueben todo con make test-lab. Cada vez que algo pase, hagan un commit.
Resumen
- Este curso enseña a escribir programas que no caben en la cabeza. El laboratorio es el centro, y empieza siempre leyendo.
int,doubleychartienen límites. El overflow de unintes comportamiento indefinido,doublees aproximado ychares un número pequeño.- Lo que manda en una división es el tipo de los operandos. Entre dos
intes división entera, y se acerca a 0. El resto lleva el signo del dividendo. &&y||hacen cortocircuito.=asigna y==compara.forsi se sabe cuántas vueltas,whilesi depende de una condición,do whilesi corre al menos una vez. Revisen dónde empieza y dónde termina cada ciclo.- Toda lectura con
scanfrevisa su resultado. - Un parámetro es una copia, y
returnentrega un solo valor. - Separen el cálculo de la entrada y la salida. Una función que solo calcula se puede probar. Una que además imprime manda su resultado a la pantalla, donde el código ya no lo puede comprobar.
assertdetiene el programa si una condición es falsa. Prueben casos normales, cero, bordes, negativos, extremos y cada camino. No lo usen para validar lo que escribe el usuario.- Compilen con
-Wall -Wextray lean cada advertencia como si fuera un error. Un programa con una advertencia puede correr y dar un número creíble y equivocado. Y no toda falla da una advertencia. makecompila,make testcomprueba, ygit clonecopia un repositorio con su historial.
Ejercicios
Todo programa revisa su scanf, y compila sin advertencias.
-
Sin compilar, digan qué escribe cada línea. Luego compruébenlo.
a) printf("%d", 17 / 5);
b) printf("%d", 17 % 5);
c) printf("%d", -17 % 5);
d) printf("%.2f", 17 / 5);
e) printf("%.2f", (double) 17 / 5);
f) printf("%.2f", (double) (17 / 5));
g) printf("%d", 1 + 2 * 3 % 4);
h) printf("%d", 'C' - 'A');
Una de ellas da una advertencia. ¿Cuál, y por qué?
-
Sigan
coins_needed(490)en una tabla como la de 380. Luego expliquen por quéchange_tests.ctiene una prueba justo con ese monto. -
Encuentren el problema de cada fragmento. Con
-Wall -Wextra, ¿gccda un error, una advertencia o nada? Compruébenlo.a) int f(int x) { if (x > 0) { return 1; } } b) int f(int x) { return 1; } c) void f(int x) { return x + 1; } d) int n; scanf("%d", n); e) double h = 1 / 2; f) if (x = 0) { printf("cero"); }¿En cuál el compilador no ayuda, y qué prueba lo encontraría?
-
Copien
change_tests.cy, enlargest_coin, cambiencents >= 100porcents > 100. Corran las pruebas: todas pasan, y sin embargo la función está mal. Encuentren un monto con el que falla y agreguen elassertque falta. ¿Cuál es la lección sobre elegir los casos? -
Escriban
int count_multiples_between(int low, int high, int step), con los dos extremos incluidos, con ciclo. Pruébenla con al menos seisassert, entre ellos uno dondelowes múltiplo, otro donde lo eshigh, otro dondelowyhighson iguales y otro dondelowes mayor quehigh. -
En
grades_average.ctodo está enmain. Saquen el cálculo adouble average(int total, int count)y pruébenla conassert. ¿Qué debe hacer concounten 0? Decídanlo, y escríbanlo en un comentario. ¿Hay alguna parte de este programa que no se pueda separar? ¿Por qué? -
Escriban
int power(int base, int exponent)con un ciclo, para unexponentque no sea negativo. Pruébenla conpower(2, 10),power(7, 1),power(5, 0),power(0, 3)ypower(0, 0), para el que decidan un valor. Luego, sinassert, corranpower(2, 31)con el sanitizer. ¿Qué pasa, y por qué 31 y no 32? -
Escriban
int reverse_digits(int n), paranno negativo: con 1234 devuelve 4321. ¿Qué devuelve con 1200, y por qué no puede devolver 0021? ¿Qué pasa con 2147483647, y qué dice el sanitizer? Decidan qué debería hacer la función en ese caso. -
Hagan un
git clonede la carpetaproyectode la sesión de arriba en una tercera carpeta. ¿Está el commit que hicieron encopia? ¿Por qué? Hagan dos commits en la copia nueva y muestren congit log --onelineque los historiales ya son distintos. -
Corran su
collatz_stepscon 113383, usando el sanitizer. ¿Qué dice? ¿Por qué ese número da problemas y los menores que 10 000 no? Modifiquen la función para detectar el problema antes de que ocurra, y devolver -1 en ese caso, sin usar otro tipo de dato. -
Escriban
int collatz_peak(int n), que devuelve el mayor valor al que llega la sucesión den. Con 6 da 16. ¿Cuál es el número menor que 10 000 con el pico más alto? ¿Es el mismo que el de más pasos? Antes de correrlo, ¿qué esperarían?