Apuntes · Capítulo 2Repaso y entornos
Datos en C y cómo leer código ajeno
Datos en C y cómo leer código ajeno
La semana pasada repasamos lo esencial de C: tipos, decisiones, ciclos, funciones y assert.
Hoy terminamos el repaso con los datos: arreglos, cadenas, struct y archivos. Todo eso ya
lo vieron en Introducción a la Computación, así que iremos rápido y nos detendremos solo en los
errores que más se repiten. Si un tema se les olvidó del todo, vuelvan a esos apuntes: arreglos
en la semana 9, arreglos en funciones y cadenas en la semana 10, string.h en la semana 11, y
struct y archivos en la semana 12.
La segunda parte del capítulo es nueva: cómo leer un programa que no escribieron. Hasta ahora, casi todo el código que leyeron era suyo o cabía en una diapositiva. Eso se acaba aquí. El laboratorio de esta semana empieza con un programa de unas 200 líneas, y ustedes tienen que entenderlo antes de tocarlo. Veremos un método para hacerlo, cómo usar las pruebas como documentación, y cómo corregir y extender un programa cambiando poco.
Ruta de lectura.
- Antes de clase (15 a 20 minutos, obligatoria): la introducción, Leer código es una habilidad y Paso 1:
mainy las firmas.- En clase: el repaso de Arreglos: la longitud viaja aparte, Cadenas: arreglos de
charcon\0,struct: datos que van juntos y Archivos: abrir, leer, cerrar. Después el método de lectura, de Paso 2: ejecutarlo con un ejemplo a Paso 4: escribir lo que entendieron, Leer las pruebas como documentación y Corregir: cambiar poco.- Después de clase: Extender: cambiar poco, otra vez y El laboratorio, paso a paso. Luego el Resumen y los Ejercicios. Para ir más allá: el ejercicio 12, Un programa nuevo.
Código. El código de este capítulo está en
code/week-02. Dentro del entorno del curso, entren a esa carpeta y corranmakepara compilar los ejemplos ymake testpara comprobarlos. Los comandos de este capítulo se corren desde ahí. Los programas deerrors/tienen errores a propósito y se compilan a mano, como se muestra en cada caso. Los datos de los archivos de ejemplo son inventados.
Arreglos: la longitud viaja aparte
Un arreglo (array) guarda varios valores del mismo tipo, uno al lado del otro, y cada uno se alcanza con un índice (index) que empieza en 0. Su tamaño queda fijo al declararlo. Lo normal es reservar más casillas de las que se usan y llevar la cuenta en otra variable. Son dos números distintos:
- La capacidad: cuántos elementos caben. No cambia.
- La longitud: cuántos elementos tiene de verdad ahora.
#define CAPACITY 8int grades[CAPACITY] = {14, 9, 17, 11};
int n = 4;Las casillas que no aparecen entre las llaves quedan en 0. Una función que recibe un arreglo
también recibe su longitud, y lleva const si solo lo lee:
int sum(const int a[], int n) {
    int total = 0;
    for (int i = 0; i < n; i++) {
        total = total + a[i];
    }
    return total;
}
Si la función debe cambiar el arreglo, va sin const:
void add_bonus(int a[], int n, int bonus) {
    for (int i = 0; i < n; i++) {
        a[i] = a[i] + bonus;
    }
}
Esta es la corrida de array_review.c, que usa las dos. Los 32 bytes salen de 8 casillas de 4
bytes, el tamaño de int en este entorno:
$ build/array_review
sizeof(grades) = 32 bytes, capacidad 8, longitud 4
Suma: 51
Suma de las 2 primeras: 23
Con un punto más: 55
Dos cosas que conviene recordar de esa salida. Como la longitud es un parámetro, la misma función
puede sumar solo una parte del arreglo. Y add_bonus cambió el arreglo de main: un arreglo no
se copia al pasarlo a una función. Lo que viaja es la dirección donde empieza, como vieron en
la semana 10 de Introducción a la Computación. Las semanas 3 y 4 de este curso explican con
detalle qué significa eso.
Por qué hay que pasar el tamaño
Justamente porque viaja solo una dirección, la función no tiene cómo saber cuántos elementos hay.
sizeof no ayuda. gcc ya lo avisa al compilar errors/sizeof_param.c:
$ gcc -Wall -Wextra -std=c17 errors/sizeof_param.c -o build/sizeof_param
errors/sizeof_param.c: In function 'print_size':
errors/sizeof_param.c:5:48: warning: 'sizeof' on array function parameter 'a' will return size of 'int *' [-Wsizeof-array-argument]
    5 |     printf("en la función: %zu bytes\n", sizeof(a));
      |                                                ^
errors/sizeof_param.c:4:21: note: declared here
    4 | void print_size(int a[]) {
      |                 ~~~~^~~
$ build/sizeof_param
en main: 32 bytes
en la función: 8 bytes
Los 8 bytes son el tamaño de una dirección en este entorno, y no tienen nada que ver con el
arreglo. La notación int * significa “dirección de un int”, y la veremos en la semana 4.
Error común. Escribir
sizeof(a) / sizeof(a[0])dentro de una función que recibió el arreglo como parámetro. Esa cuenta solo sirve donde el arreglo fue declarado. En una función, la longitud se recibe en un parámetro.
Salirse del arreglo
C no revisa los índices. Este ciclo da una vuelta de más, porque usa <=:
for (int i = 0; i <= 4; i++) {
    total = total + grades[i];
}
Compila sin ninguna advertencia. Sin sanitizers, el programa termina como si nada. Leer fuera del arreglo es comportamiento indefinido (undefined behavior): el estándar de C no exige ningún resultado. En esta corrida sumó un 4 que encontró en esa memoria, y en otra máquina puede salir otra cosa:
$ gcc -Wall -Wextra -std=c17 errors/array_overflow.c -o build/array_overflow
$ build/array_overflow
Suma: 55
Con los sanitizers que usamos en el laboratorio, el error sale de inmediato. Esta salida está recortada, y las direcciones cambian de una corrida a otra:
$ gcc -Wall -Wextra -std=c17 -g -fsanitize=address,undefined errors/array_overflow.c -o build/array_overflow_san
$ build/array_overflow_san
errors/array_overflow.c:8:31: runtime error: index 4 out of bounds for type 'int [4]'
==262==ERROR: AddressSanitizer: stack-buffer-overflow on address 0xffffb3700030 at pc 0xaaaae7e71478 bp 0xffffec937e90 sp 0xffffec937ea8
READ of size 4 at 0xffffb3700030 thread T0
    #0 0xaaaae7e71474 in main errors/array_overflow.c:8
    [32, 48) 'grades' (line 5) <== Memory access at offset 48 overflows this variable
Lean primero el nombre del error, luego READ o WRITE, y luego la primera línea con un archivo
de ustedes: aquí, errors/array_overflow.c:8.
Idea clave. Siempre compilen sus laboratorios con
-g -fsanitize=address,undefined. Sin ellos, un programa con un error de memoria puede parecer correcto. Con ellos, ese mismo error les dice en qué línea está. Sin embargo, un sanitizer solo ve lo que de verdad se ejecuta, así que sigue haciendo falta probar los casos borde.
Cadenas: arreglos de char con \0
Una cadena (string) en C es un arreglo de char que termina en el carácter nulo, '\0', un
byte con el valor 0. No es un tipo aparte. Todo lo que funciona con cadenas busca ese byte para
saber dónde parar. Hay, entonces, dos tamaños que no se deben confundir:
char word[8] = "hola";
printf("sizeof = %zu, strlen = %zu\n", sizeof(word), strlen(word));
word[2] = '\0';
printf("Con un nulo en medio: \"%s\", strlen = %zu\n", word, strlen(word));
$ build/string_review
sizeof = 8, strlen = 4
Con un nulo en medio: "ho", strlen = 2
strcmp(a, b) = 0sizeof dice cuánto mide el arreglo. strlen, de string.h, cuenta los bytes hasta el primer
'\0', sin contarlo. El texto "hola" necesita, por lo tanto, 5 bytes: uno más que sus letras.
Si char s[5] recibe "hola!"
"hola!" tiene 5 letras, así que necesita 6 bytes. ¿Qué pasa si el arreglo tiene 5? Depende de
cómo llegue el texto. Hay dos casos, y los dos son un error.
Caso 1: al inicializar. En errors/no_terminator.c:
char s[5] = "hola!";
printf("%s\n", s);
C acepta esta inicialización: llena las 5 casillas y deja afuera el '\0'. Lo que queda ya no
es una cadena, solo un arreglo de char. La línea en sí no se sale de nada. El problema llega
cuando printf con %s busca un '\0' que no está, y sigue leyendo más allá del arreglo. Esta
versión de gcc no avisa nada. Y sin sanitizers, en esta corrida, parece funcionar:
$ gcc -Wall -Wextra -std=c17 errors/no_terminator.c -o build/no_terminator
$ build/no_terminator
hola!
Salió bien solo porque el byte siguiente, por casualidad, valía 0. Con los sanitizers (salida recortada; las direcciones cambian):
$ gcc -Wall -Wextra -std=c17 -g -fsanitize=address,undefined errors/no_terminator.c -o build/no_terminator_san
$ build/no_terminator_san
==275==ERROR: AddressSanitizer: stack-buffer-overflow on address 0xffff97b00025 at pc 0xffff9a7aa4dc bp 0xffffe7a077b0 sp 0xffffe7a077f0
READ of size 6 at 0xffff97b00025 thread T0
    #1 0xaaaac07b0d88 in main errors/no_terminator.c:6
    [32, 37) 's' (line 5) <== Memory access at offset 37 overflows this variable
READ of size 6: se quisieron leer 6 bytes de un arreglo de 5.
Caso 2: al copiar. En errors/copy_overflow.c, la copia ocurre mientras el programa corre:
char s[5];
char word[] = "hola!";
strcpy(s, word);
strcpy no sabe cuánto mide el destino: copia hasta el '\0' del origen, incluido. Escribe 6
bytes en un arreglo de 5. Esta vez el error no es leer de más sino escribir de más, lo que se
llama buffer overflow. gcc tampoco avisa aquí. Con sanitizers (salida recortada; las direcciones cambian):
$ gcc -Wall -Wextra -std=c17 -g -fsanitize=address,undefined errors/copy_overflow.c -o build/copy_overflow_san
$ build/copy_overflow_san
==288==ERROR: AddressSanitizer: stack-buffer-overflow on address 0xffff7d800025 at pc 0xffff803c5f6c bp 0xfffff7d08800 sp 0xfffff7d08840
WRITE of size 6 at 0xffff7d800025 thread T0
    #1 0xaaaaca960e94 in main errors/copy_overflow.c:8
    [32, 37) 's' (line 6) <== Memory access at offset 37 overflows this variable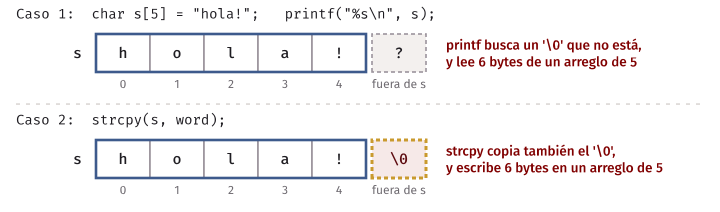
Lo mismo pasa con scanf("%s", s) sin límite. Por eso, en este curso, %s siempre lleva un
ancho, y ese ancho es uno menos que el tamaño del buffer: para 20 bytes, %19s.
Error común. Contar las letras y olvidar el
'\0'. Un texto dekbytes necesita un arreglo de por lo menosk + 1. Y recuerden questrlencuenta bytes, no letras:ñocupa dos.
Comparar cadenas
== no compara el texto de dos arreglos. gcc da un aviso en errors/compare_strings.c, y el
programa dice que dos textos iguales son distintos:
$ gcc -Wall -Wextra -std=c17 errors/compare_strings.c -o build/compare_strings
errors/compare_strings.c: In function 'main':
errors/compare_strings.c:7:11: warning: comparison between two arrays [-Warray-compare]
    7 |     if (a == b) {
      |           ^~
errors/compare_strings.c:7:11: note: use '&a[0] == &b[0]' to compare the addresses
$ build/compare_strings
Distintas
Para comparar texto se usa strcmp(a, b): da 0 si son iguales. Es lo que muestra la última línea
de string_review, arriba. Lo usaremos en un momento para buscar por nombre.
Leer texto
Para leer una línea entera se usa fgets, que recibe el tamaño del buffer y nunca se pasa. Hay que
recordar dos detalles: conserva el salto de línea, si cupo, y devuelve NULL cuando no hay más
que leer. Por eso casi todo programa que lee líneas lleva esta función:
int remove_newline(char s[]) {
    for (int i = 0; s[i] != '\0'; i++) {
        if (s[i] == '\n') {
            s[i] = '\0';
            return 1;
        }
    }
    return 0;
}struct: datos que van juntos
Un struct agrupa datos de distintos tipos bajo un solo nombre. Se evita así tener arreglos
paralelos, donde la fila 2 de uno y la fila 2 del otro son la misma persona.
struct student {
    char name[NAME_SIZE];
    int grades[N_GRADES];
};
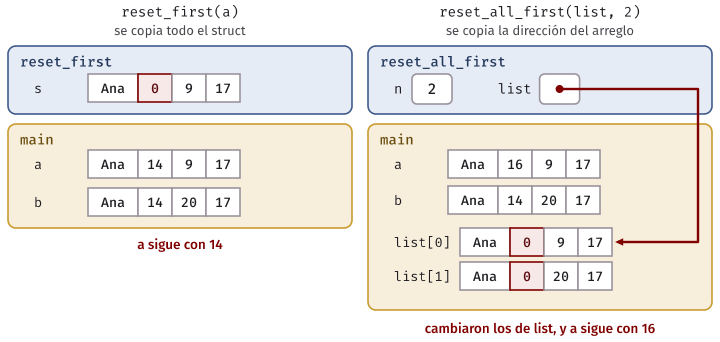
Lo que más se olvida es cómo se comporta al asignarlo y al pasarlo. Un struct se copia entero,
incluidos los arreglos que tiene adentro. El programa struct_review.c lo muestra en tres partes.
struct student a = {"Ana", {14, 9, 17}};
struct student b = a;
b.grades[1] = 20;
void reset_first(struct student s) {
s.grades[0] = 0;
printf("En la función: %d\n", s.grades[0]);
}struct student with_first(struct student s, int grade) {
s.grades[0] = grade;
return s;
}void reset_all_first(struct student list[], int n) {
for (int i = 0; i < n; i++) {
list[i].grades[0] = 0;
}
}$ build/struct_review
Ana: 14 9 17
Ana: 14 20 17
En la función: 0
Ana: 14 9 17
Ana: 16 9 17
Ana: 0 9 17
Ana: 0 20 17
Ana: 16 9 17Vayamos línea por línea:
| Salida | Por qué |
|---|---|
Ana: 14 9 17 y Ana: 14 20 17 |
b = a copió todo: cambiar b no toca a. |
En la función: 0 y luego Ana: 14 9 17 |
reset_first cambió su copia. El a de main sigue igual. |
Ana: 16 9 17 |
with_first devolvió la copia cambiada, y main la guardó en a. |
Ana: 0 9 17 y Ana: 0 20 17 |
reset_all_first recibe un arreglo: cambia los elementos de list. |
Ana: 16 9 17, la última |
list[0] era una copia de a, hecha al inicializar list. a no cambió. |
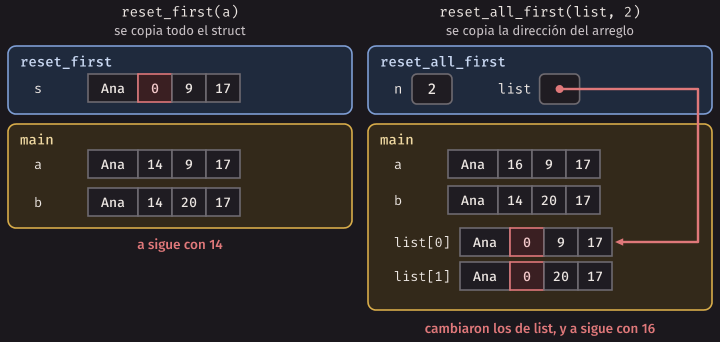
Idea clave. Un
structsuelto llega a una función como copia. Un arreglo destructllega como dirección. Si una función debe entregar un cambio, o recibe el arreglo, o devuelve elstructcambiado. Cuando lean una firma, esto les dice de inmediato qué puede tocar la función y qué no.
Para leer una expresión como list[1].grades[2], vayan de izquierda a derecha: el elemento 1 de
list, su campo grades, la casilla 2 de ese arreglo.
Archivos: abrir, leer, cerrar
Un archivo (file) es una secuencia de bytes con nombre. Un archivo de texto no tiene filas ni números: tiene caracteres y saltos de línea, y convertirlos es trabajo del programa. Usarlo tiene tres pasos, y el primero siempre se revisa.
FILE *file = fopen(path, "r");
if (file == NULL) {
    perror(path);
    return 1;
}
FILE * es el único puntero que declararemos antes de la semana 4, y lo usamos como en
Introducción a la Computación: se guarda lo que entrega fopen, se compara con NULL y se pasa a
otras funciones. perror escribe en stderr la razón que dio el sistema, cuyo texto puede cambiar
según el sistema o su idioma.
El programa file_review.c junta el resto del repaso. Lee el nombre del archivo de la entrada y
suma la gente de cada paradero. Una línea de paraderos.txt está mal a propósito:
$ cat paraderos.txt
Tacna 42
Grau 17
Abancay 8
Wilson x
Bolivia 25
El ciclo de lectura tiene como condición el resultado de la lectura, y no feof. Dentro, cada
línea se separa en campos con sscanf:
while (fgets(line, LINE_SIZE, file) != NULL) {
    number++;
    char name[NAME_SIZE];
    int people;
    char extra[2];
    int fields = sscanf(line, "%19s %d %1s", name, &people, extra);
    if (fields == 2) {
        total = total + people;
    } else {
        fprintf(stderr, "Línea %d: mal formada, se omite\n", number);
    }
}
fclose(file);
sscanf devuelve cuántos campos pudo convertir. Se pide un campo de más, %1s, para detectar
lo que sobre en la línea: una línea correcta da exactamente 2. El nombre lleva su límite, %19s, y
no lleva &, a diferencia de people.
$ echo paraderos.txt | build/file_review
Línea 4: mal formada, se omite
Personas: 92
$ echo no_hay.txt | build/file_review; echo "estado: $?"
no_hay.txt: No such file or directory
estado: 1
Comprobemos a mano: 42 + 17 + 8 + 25 = 92. El aviso va a stderr y el resultado a stdout, y
cuando algo sale mal, el programa lo dice y devuelve un estado distinto de 0.
Error común. No mirar lo que devuelven
fopen,fgetsosscanf. Sisscanfno convirtió un campo, la variable se queda como estaba, y leerla sin valor es comportamiento indefinido. En este curso, toda lectura revisa su resultado.
Con esto termina el repaso de lenguaje. Vamos a lo nuevo.
Leer código es una habilidad
En un trabajo real, casi nunca se empieza de una hoja en blanco. Se llega a un programa que ya existe, que otros escribieron, y se le corrige un error o se le agrega algo. Por cada línea que se escribe, se leen muchas. Y leer también aplica a su propio código: el de hace tres meses les parecerá de otra persona.
Leer código no es como leer un libro. Un programa no se entiende de la primera línea a la última, porque no se ejecuta en ese orden. Si empiezan por el principio de un archivo, se encuentran con detalles de los que aún no saben para qué sirven: se cansan antes de llegar a lo importante.
Como cualquier habilidad, esta tiene un método. Tiene cuatro pasos:
- Empezar por
mainy las firmas: ver las piezas y cómo se conectan, sin leer cuerpos. - Ejecutarlo con un ejemplo: ver qué hace por fuera, antes de ver cómo lo hace por dentro.
- Seguir un dato de principio a fin: elegir un dato y acompañarlo por el programa.
- Escribir lo que se entendió: lo que no se puede escribir, no se entendió.
Lo aplicaremos a trips.c, un programa de 128 líneas. Una empresa de combis anota cada viaje en un
archivo, con la ruta y los pasajeros, y el programa resume cada ruta. Es más corto que el del
laboratorio, pero tiene su misma forma. Hagan como si no lo conocieran: es de otra persona, y
nadie está disponible para explicarlo.
Paso 1: main y las firmas
Antes de leer nada, midan el programa y vean sus piezas. wc -l cuenta líneas. grep es un
comando que escribe las líneas de un archivo que contienen un patrón. El patrón ^[a-z].*) {$
significa, sin entrar en detalles, “línea que empieza con una minúscula y termina en ) {”. En
nuestro estilo, eso encuentra las definiciones de función. -n agrega el número de línea:
$ wc -l trips.c
128 trips.c
$ grep -n '^[a-z].*) {$' trips.c
20:int remove_newline(char s[]) {
31:int find_route(const struct route routes[], int n, const char name[]) {
41:int add_trip(struct route routes[], int n, const char name[], int passengers) {
60:int read_trips(const char path[], struct route routes[]) {
84:double average_passengers(struct route r) {
89:int busiest_route(const struct route routes[], int n) {
102:void print_routes(const struct route routes[], int n) {
109:int main(void) {
Son ocho funciones. Esta lista ya es un mapa. Una firma es la línea que da el nombre de una función, sus parámetros y lo que devuelve, y dice mucho sin mirar el cuerpo:
| Firma | Qué se puede deducir |
|---|---|
find_route(const struct route routes[], ...) |
Busca, y solo lee: lleva const. |
add_trip(struct route routes[], ...) |
Cambia el arreglo. Devuelve un int: ¿quizás la nueva longitud? |
read_trips(const char path[], struct route routes[]) |
Llena el arreglo con lo que hay en un archivo. |
average_passengers(struct route r) |
Recibe una copia, y no puede cambiar nada. |
print_routes(const struct route routes[], int n) |
Escribe, y solo lee los datos. |
Hay deducciones con signo de interrogación. Está bien: son hipótesis que van a comprobar después. Antes de las funciones, el archivo define los datos. El tipo principal de un programa es lo más importante que pueden leer, porque las funciones giran alrededor de él:
struct route {
    char name[NAME_SIZE];
    int trips;
    int passengers;
};
Ahora sí, lean main. Es corto, y dice el orden de todo:
int main(void) {
    char path[PATH_SIZE];
    if (fgets(path, PATH_SIZE, stdin) == NULL) {
        fprintf(stderr, "Falta el nombre del archivo\n");
        return 1;
    }
    remove_newline(path);
    struct route routes[MAX_ROUTES];
    int n = read_trips(path, routes);
    if (n < 0) {
        return 1;
    }
    if (n == 0) {
        printf("No hay viajes\n");
        return 0;
    }
    print_routes(routes, n);
    printf("Más pasajeros: %s\n", routes[busiest_route(routes, n)].name);
    return 0;
}
Lean las líneas que manejan errores una sola vez, y luego quítenlas con la vista. Lo que queda es
la historia del programa: leer el nombre del archivo, llenar routes, escribir las rutas, escribir
la de más pasajeros. Tres llamadas, y n conecta todo.
Para ver quién llama a una función, grep también sirve. Da la definición y cada llamada, con su
número de línea:
$ grep -n 'add_trip' trips.c
41:int add_trip(struct route routes[], int n, const char name[], int passengers) {
75:            n = add_trip(routes, n, name, passengers);
La línea 75 está dentro de read_trips, que empieza en la 60. Así se arma, de a pocos, el árbol
de llamadas: quién llama a quién.
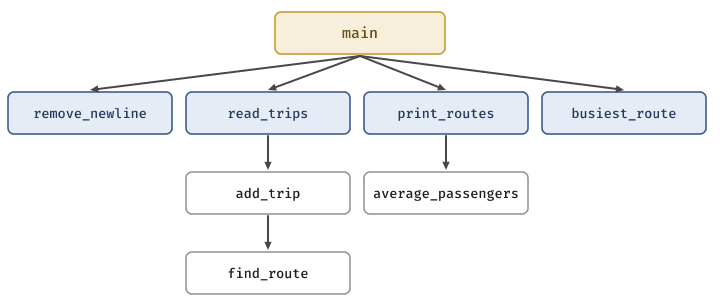
Idea clave. Si les toca un programa de 2 000 líneas, no lo lean de corrido. Empiecen por
mainy sus tipos principales, y bajen solo por la rama que les importa. Aprender qué función no necesitan leer es parte del método. Nadie tiene en la cabeza 2 000 líneas a la vez.
Paso 2: ejecutarlo con un ejemplo
Antes de bajar a los cuerpos, vean qué hace el programa por fuera. Una ejecución real corrige muchas ideas equivocadas, y les da algo concreto que explicar. Miren los datos y después la salida:
$ cat viajes.txt
Chosica 18
Callao 25
Chosica 22
Ate 9
Callao 31
Chosica mucho
Ate 14
Callao 20
$ echo viajes.txt | build/trips
Línea 6: mal formada, se omite
Chosica  2 viajes   40 pasajeros  20.00 por viaje
Callao   3 viajes   76 pasajeros  25.33 por viaje
Ate      2 viajes   23 pasajeros  11.50 por viaje
Más pasajeros: Callao
¿Qué aprendimos sin leer una línea de código?
- Agrupa por ruta: 8 líneas de datos se vuelven 3 filas.
- Las filas salen en el orden en que cada ruta apareció por primera vez, no ordenadas.
- Una línea mala no detiene el programa: la avisa con su número y sigue.
- “Más pasajeros” se refiere al total, no al promedio por viaje. Callao gana en los dos, así que este ejemplo no alcanza para estar seguros. Es una pregunta que anotamos para después.
También conviene probar con entradas que le cuesten: un archivo que no existe, uno vacío. Sale lo
que main prometía:
$ echo no_hay.txt | build/trips; echo "estado: $?"
no_hay.txt: No such file or directory
estado: 1
Paso 3: seguir un dato de principio a fin
Elijan un dato y acompáñenlo. No traten de entender todo el programa a la vez: un dato los lleva
justo por el camino que importa, y deja de lado lo demás. Sigamos la línea Callao 31, la quinta del
archivo. Es mejor que la primera línea de Callao, porque esa ruta ya existe, y pasa por más código.
En read_trips. La línea llega a line como cadena, y sscanf la parte en dos:
if (sscanf(line, "%19s %d %1s", name, &passengers, extra) == 2 && passengers >= 0) {
    n = add_trip(routes, n, name, passengers);
En add_trip. Es la pieza central. Ahora sí vale la pena leer el cuerpo:
int add_trip(struct route routes[], int n, const char name[], int passengers) {
    int pos = find_route(routes, n, name);
    if (pos == -1) {
        if (n == MAX_ROUTES) {
            fprintf(stderr, "Demasiadas rutas: se omite %s\n", name);
            return n;
        }
        pos = n;
        strcpy(routes[pos].name, name);
        routes[pos].trips = 0;
        routes[pos].passengers = 0;
        n = n + 1;
    }
    routes[pos].trips = routes[pos].trips + 1;
    routes[pos].passengers = routes[pos].passengers + passengers;
    return n;
}
En find_route. Es una búsqueda lineal, y compara con strcmp:
int find_route(const struct route routes[], int n, const char name[]) {
    for (int i = 0; i < n; i++) {
        if (strcmp(routes[i].name, name) == 0) {
            return i;
        }
    }
    return -1;
}
Esta es la forma que tiene nuestro dato en cada punto:
| Dónde | Variable | Valor |
|---|---|---|
| El archivo | quinta línea | los bytes de Callao 31 y un salto de línea |
read_trips, después de fgets |
line |
"Callao 31\n" |
read_trips, después de sscanf |
name, passengers |
"Callao", 31 |
find_route, al terminar |
lo que devuelve | 1, la posición de Callao |
add_trip, al terminar |
routes[1] |
{"Callao", 2, 56} |
average_passengers, más tarde |
r, una copia de routes[1] |
{"Callao", 3, 76}, con un viaje más |
print_routes |
texto en la pantalla | Callao 3 viajes 76 pasajeros 25.33 por viaje |
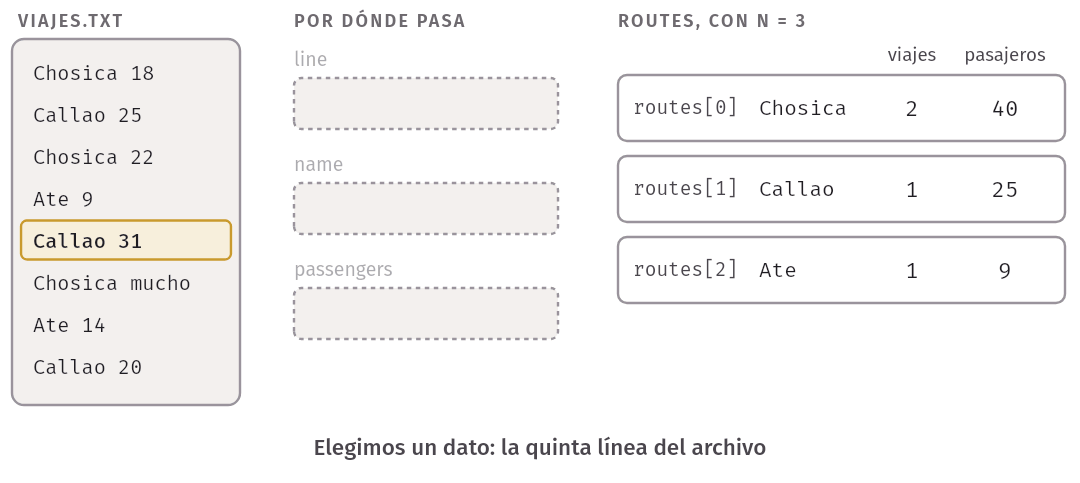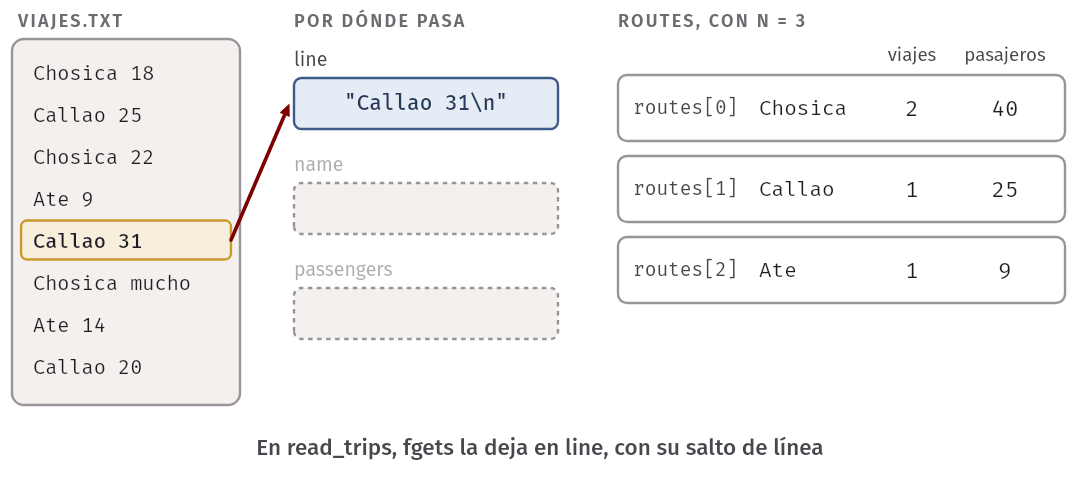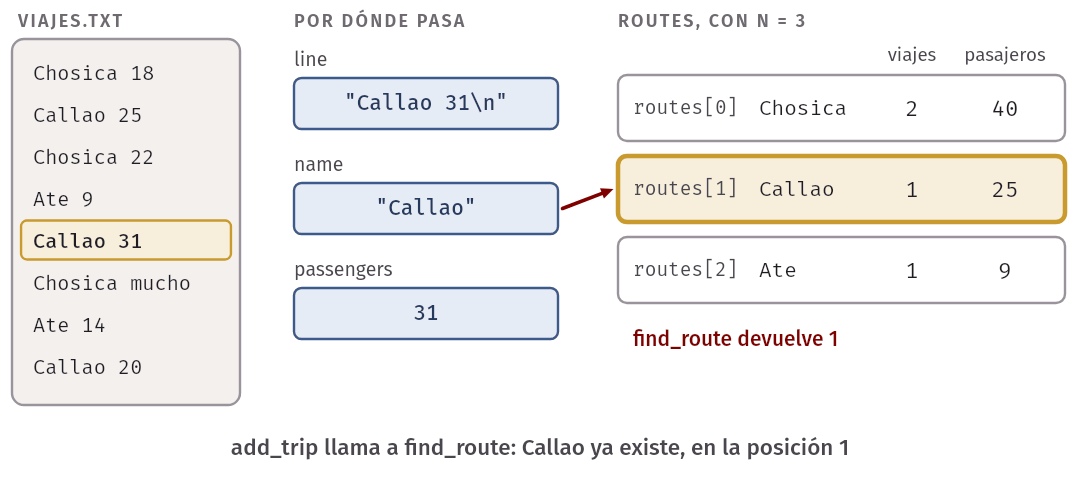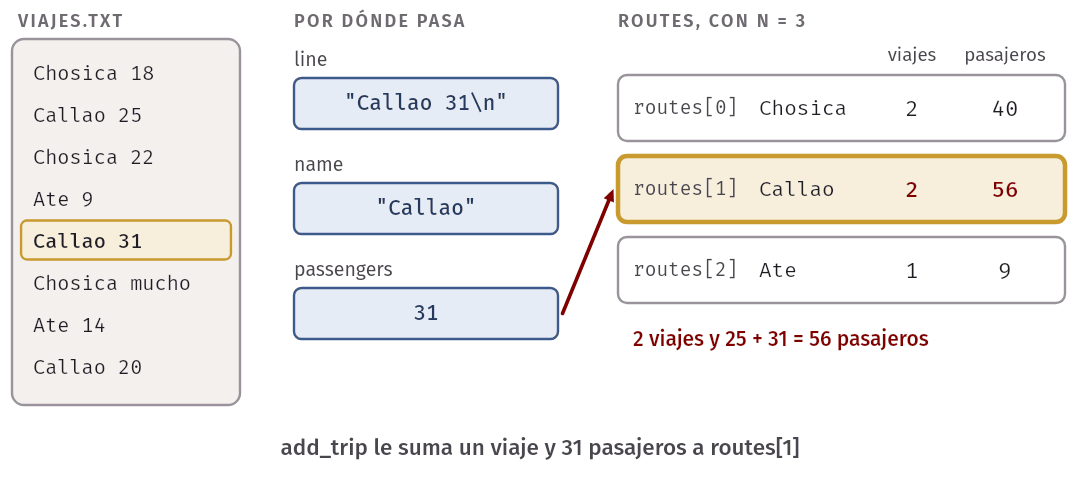
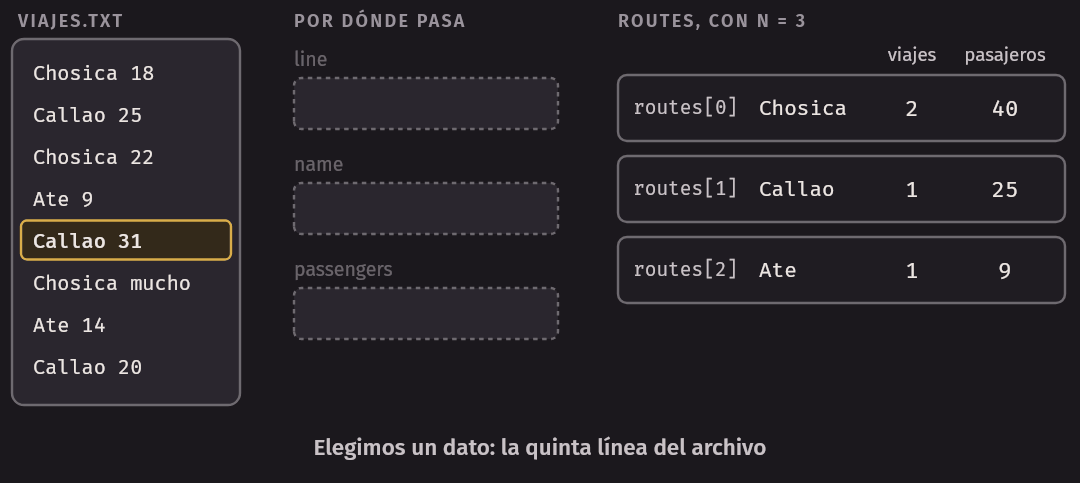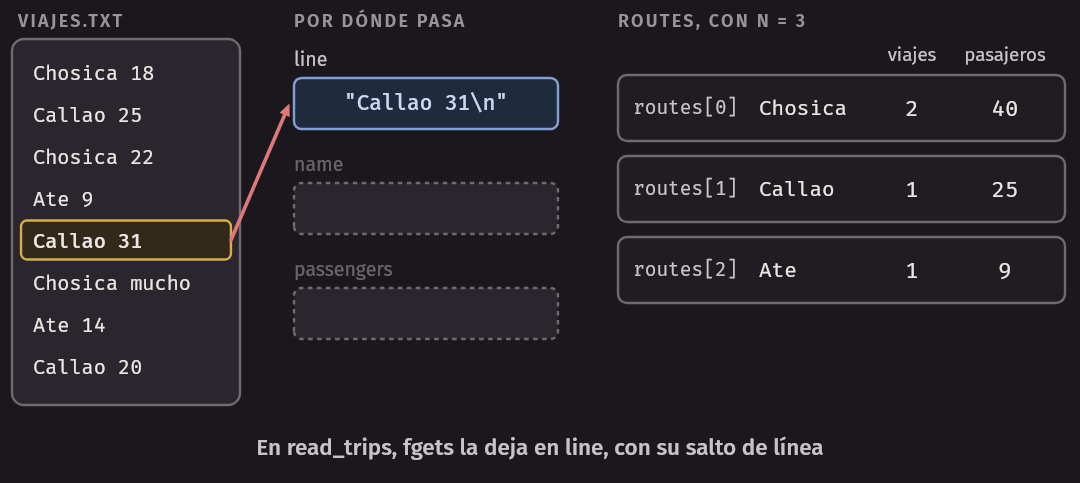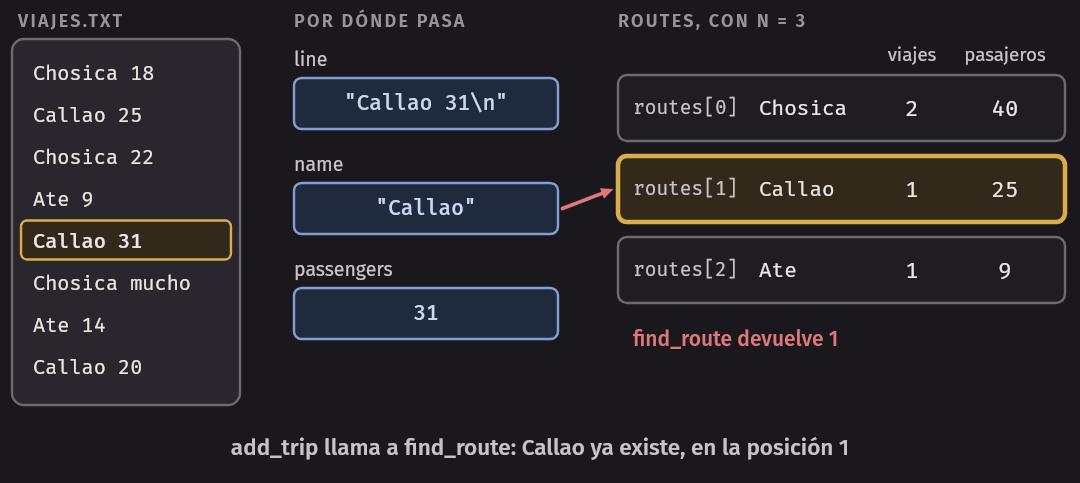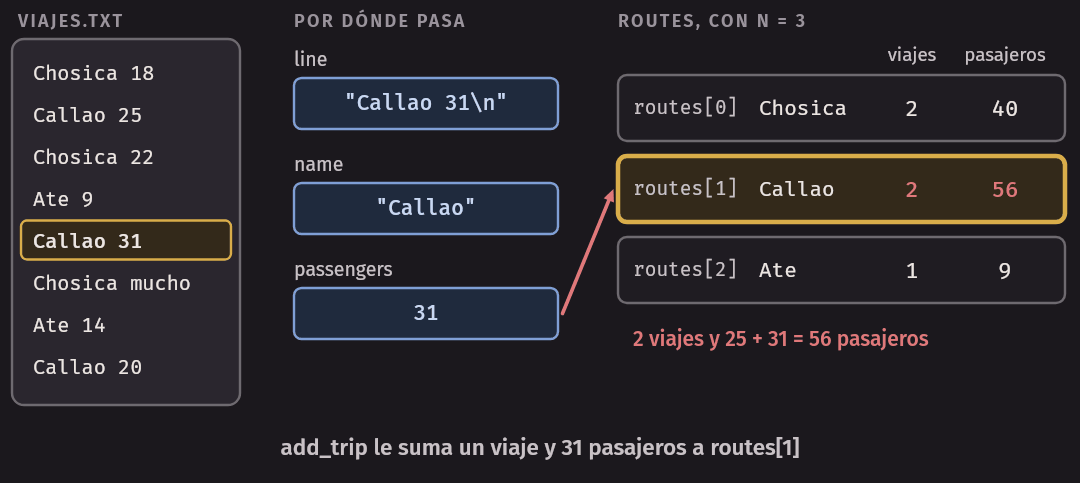
Si siguen todas las líneas, pueden ver cómo crece el arreglo. Esta tabla da el valor de routes
después de cada línea, como nombre viajes pasajeros, y de n:
| Línea | routes[0] |
routes[1] |
routes[2] |
n |
|---|---|---|---|---|
Chosica 18 |
Chosica 1 18 | 1 | ||
Callao 25 |
Chosica 1 18 | Callao 1 25 | 2 | |
Chosica 22 |
Chosica 2 40 | Callao 1 25 | 2 | |
Ate 9 |
Chosica 2 40 | Callao 1 25 | Ate 1 9 | 3 |
Callao 31 |
Chosica 2 40 | Callao 2 56 | Ate 1 9 | 3 |
Chosica mucho |
no se llama a add_trip |
3 | ||
Ate 14 |
Chosica 2 40 | Callao 2 56 | Ate 2 23 | 3 |
Callao 20 |
Chosica 2 40 | Callao 3 76 | Ate 2 23 | 3 |
La última fila coincide con la salida del paso 2. Cuando la mano y la máquina coinciden, entienden el
programa. Además, seguir el dato respondió la hipótesis del paso 1: add_trip devuelve la nueva
longitud, y por eso read_trips escribe n = add_trip(...).
Y sale una pregunta que no se ve en los comentarios: average_passengers divide entre r.trips.
¿Puede ser 0? Mirando add_trip, una ruta nace con 0 viajes y dos líneas después ya tiene 1. Nunca
queda en 0, así que esa división es segura por cómo se llenan los datos.
double average_passengers(struct route r) {
    return (double) r.passengers / r.trips;
}
Idea clave. Hay reglas que un programa cumple sin escribirlas en ninguna parte, como que “toda ruta guardada tiene por lo menos un viaje”. Encontrarlas es una de las ganancias de leer. Romper una sin darse cuenta es la forma más común de malograr un programa al cambiarlo.
Paso 4: escribir lo que entendieron
Mientras uno lee, todo parece claro. Al escribirlo se descubren los huecos: la frase no sale, porque la idea no estaba. No hace falta un documento largo. Basta con tres cosas, y una función por línea:
trips.c: resume por ruta los viajes de un archivo.

Datos
  route: nombre, cantidad de viajes y total de pasajeros de una ruta.
  routes[MAX_ROUTES], con longitud n. Cada ruta aparece una sola vez.
  Regla: toda ruta guardada tiene por lo menos un viaje.

Funciones
  remove_newline       quita el salto de línea de una cadena
  find_route           busca una ruta por nombre; -1 si no está
  add_trip             cuenta un viaje; agrega la ruta si es nueva; devuelve la nueva n
  read_trips           llena routes desde un archivo; -1 si no pudo abrirlo
  average_passengers   pasajeros por viaje de una ruta
  busiest_route        posición de la ruta con más pasajeros en total; -1 si no hay
  print_routes         escribe una fila por ruta
  main                 lee el nombre del archivo y llama a las anteriores

Dudas
  ¿Qué pasa con una línea más larga que LINE_SIZE?
  ¿Qué pasa con la novena ruta?
Las dudas son parte de la nota, no una falla. Son justo lo que hay que mirar cuando toque cambiar el programa. Y la nota no copia los comentarios: si solo los repiten, no saben si los entendieron.
Leer las pruebas como documentación
Un programa con pruebas (tests) trae un segundo texto que explica lo que hace. test_trips.c llama a las
funciones de trips.c con entradas fijas y dice qué debe salir.
En C. Las pruebas necesitan las funciones de
trips.csin sumain, porque un programa solo puede tener unmain. Estas tres líneas al inicio detest_trips.ccambian el nombre delmaindetrips.cmientras lo incluyen. Tómenlas como una receta por ahora. En la semana 6 veremos cómo se separa bien un programa en varios archivos.#define main trips_main #include "trips.c" #undef main
Lean cada prueba como una frase que dice cómo se comporta el programa. Esta contesta qué hace
add_trip, sin necesidad de abrir su cuerpo:
void test_add_trip(void) {
    struct route routes[MAX_ROUTES];
    int n = 0;
    n = add_trip(routes, n, "Ate", 9);
    assert(n == 1);
    assert(routes[0].trips == 1);
    assert(routes[0].passengers == 9);
    n = add_trip(routes, n, "Ate", 14);
    assert(n == 1);
    assert(routes[0].trips == 2);
    assert(routes[0].passengers == 23);
    n = add_trip(routes, n, "Callao", 25);
    assert(n == 2);
}
Se entiende el uso: n empieza en 0, y cada llamada devuelve la nueva longitud. Se ve que una ruta
repetida no aumenta n y acumula pasajeros. Con una lectura de 14 líneas, esto es lo mismo que nos
tomó todo el paso 3 descubrir. Por eso, en un programa que no conocen, conviene leer las pruebas
antes que los cuerpos.
Las pruebas también responden lo que el ejemplo no alcanzó a decir. ¿Se acuerdan de la duda del paso 2, si “más pasajeros” se refiere al total o al promedio? Aquí está la respuesta:
// Una ruta con muchos viajes cortos puede ganarle a una con pocos viajes largos.
void test_busiest_counts_all_trips(void) {
    struct route routes[MAX_ROUTES];
    int n = add_trip(routes, 0, "Callao", 25);
    n = add_trip(routes, n, "Ate", 10);
    n = add_trip(routes, n, "Ate", 10);
    n = add_trip(routes, n, "Ate", 10);
    assert(busiest_route(routes, n) == 1);
}
Ate tiene 30 pasajeros en 3 viajes, con 10 por viaje. Callao tiene 25 en uno. Gana Ate, así que se compara el total. Y también aclaran los casos borde, que casi nunca salen en un ejemplo:
assert(find_route(routes, n, "Callao") == -1);assert(busiest_route(routes, 0) == -1);Qué da una prueba que no da un comentario
Un comentario es una afirmación que nadie comprueba. Si alguien cambia la función y olvida el comentario, el comentario sigue ahí, equivocado y con cara de cierto. Una prueba, en cambio, se ejecuta: si deja de ser verdad, falla.
| Comentario | Prueba | |
|---|---|---|
| ¿Quién lo comprueba? | Nadie | La máquina, en cada corrida |
| ¿Puede quedar desactualizado? | Sí, y sin aviso | No sin que algo falle |
| ¿Qué tan preciso es? | “Busca la ruta” | Esta entrada da exactamente esta salida |
| ¿Dice por qué? | Sí, y es para lo que mejor sirve | Casi nunca |
No se reemplazan entre sí. El comentario de arriba de test_busiest_counts_all_trips dice la
intención, y la prueba comprueba que se cumple. Pero si un comentario y una prueba que pasa se
contradicen, créanle a la prueba.
Error común. Creer que, como todas las pruebas pasan, el programa no tiene errores. Las pruebas solo dicen algo de los casos que prueban. En
test_trips.c, ninguna prueba mira qué pasa con una novena ruta. Eso no quiere decir que funcione, sino que nadie lo ha comprobado.
Corregir: cambiar poco
Veamos ahora qué se hace cuando algo falla. errors/trips_bug.c es una versión de trips.c con un
bug, y errors/test_trips_bug.c tiene las mismas pruebas sobre ella. Hagamos como si nos tocara
arreglarlo. Primero, el síntoma:
$ gcc -Wall -Wextra -std=c17 -g -fsanitize=address,undefined errors/trips_bug.c -o build/trips_bug
$ echo viajes.txt | build/trips_bug
Línea 6: mal formada, se omite
Chosica  2 viajes   22 pasajeros  11.00 por viaje
Callao   3 viajes   20 pasajeros   6.67 por viaje
Ate      2 viajes   14 pasajeros   7.00 por viaje
Más pasajeros: Chosica
Hay varias cosas mal: los pasajeros, el promedio por viaje y la ruta ganadora. Parecen varios problemas. No se apuren a corregir la última línea, que es la que más se ve.
1. Correr las pruebas y leer lo que dicen.
$ gcc -Wall -Wextra -std=c17 -g -fsanitize=address,undefined errors/test_trips_bug.c -o build/test_trips_bug
$ build/test_trips_bug
test_trips_bug: errors/test_trips_bug.c:19: test_add_trip: Assertion `routes[0].passengers == 23' failed.
Eso ya es casi todo. Una ruta recibe 9 y luego 14 pasajeros, y debería tener 23. La prueba da una entrada pequeña, que se puede seguir a mano, y mucho mejor que el archivo completo.
2. Formular una hipótesis antes de tocar nada. Los números de la corrida ayudan: Callao tiene 20
pasajeros, que son los del último viaje de Callao en el archivo. Ate tiene 14, también los del
último. Hipótesis: add_trip reemplaza los pasajeros en lugar de sumarlos. Y eso, de paso,
explicaría el promedio y la ruta ganadora: los dos usan ese mismo campo.
3. Comprobar en el código. Vamos directo a add_trip, sin leer lo demás, y la hipótesis se
confirma:
routes[pos].passengers = passengers;4. Cambiar lo mínimo y volver a correr todo. Se corrige esa sola línea. diff compara dos archivos
y muestra solo lo que cambia. Con el comentario de la primera línea, son solo estas dos diferencias:
$ diff errors/trips_bug.c trips.c
1c1
< // A propósito: esta versión de trips.c tiene un bug.
---
> // Viajes de una empresa de combis: cuántos viajes y cuántos pasajeros tuvo cada ruta.
55c55
<     routes[pos].passengers = passengers;
---
>     routes[pos].passengers = routes[pos].passengers + passengers;
$ build/test_trips
Todas las pruebas pasan
Tres síntomas en la pantalla, y una sola causa. Si hubieran parchado cada síntoma por separado, ahora habría tres arreglos encima de un bug que sigue ahí. Lo mismo pasa con las pruebas: la cantidad de pruebas que fallan no es la cantidad de bugs. Un bug en una función pequeña hace fallar a todas las que dependen de ella. Empiecen por la prueba de la función más pequeña, porque ahí la causa está más cerca.
Y assert detiene el programa en la primera falla, así que no muestra las otras. Por eso, las pruebas
del laboratorio usan otra forma: dos funciones check_int y check_double que escriben un aviso y
siguen, y al final dicen cuántas fallaron.
Error común. Cambiar varias cosas a la vez “para ver si con eso funciona”. Si funciona, no saben cuál arregló el problema, y las otras quizás rompieron algo. Si no funciona, ya no saben en qué estado está el programa. Un solo cambio, y volver a correr las pruebas.
Extender: cambiar poco, otra vez
Ahora el pedido es nuevo: la empresa quiere ver también el total de pasajeros del día. Antes de escribir, hay que seguir tres reglas.
Partir de un programa que pasa las pruebas. Si algo ya fallaba antes, no van a saber si lo rompieron ustedes.
Escribir la prueba primero. Obliga a decidir qué debe hacer la función antes de cómo hacerlo, y a pensar en los bordes. Aquí, sin rutas, el total es 0:
void test_total_passengers(void) {
    struct route routes[MAX_ROUTES];
    int n = add_trip(routes, 0, "Ate", 9);
    assert(total_passengers(routes, 0) == 0);
    n = add_trip(routes, n, "Callao", 25);
    n = add_trip(routes, n, "Ate", 14);
    assert(total_passengers(routes, n) == 48);
}
Tocar lo menos posible. Pregúntense cuántas funciones existentes hay que cambiar. Si la respuesta es “muchas”, paren y busquen otro lugar: quizás hay un punto por donde pasan todos los datos, y una sola función nueva resuelve el problema ahí. Cada función que cambian es una que pueden romper, y cada parámetro que agregan obliga a cambiar todas sus llamadas y sus pruebas.
En este caso, ninguna función existente se entera. trips_total.c es trips.c con una función nueva y
una línea en main:
$ diff trips.c trips_total.c
101a102,109
> int total_passengers(const struct route routes[], int n) {
>     int total = 0;
>     for (int i = 0; i < n; i++) {
>         total = total + routes[i].passengers;
>     }
>     return total;
> }
>
126a135
>     printf("Total de pasajeros: %d\n", total_passengers(routes, n));
$ build/test_trips_total
Todas las pruebas pasan
$ echo viajes.txt | build/trips_total
Línea 6: mal formada, se omite
Chosica  2 viajes   40 pasajeros  20.00 por viaje
Callao   3 viajes   76 pasajeros  25.33 por viaje
Ate      2 viajes   23 pasajeros  11.50 por viaje
Más pasajeros: Callao
Total de pasajeros: 139
En la salida de diff, las líneas con > son las que se agregaron, y ninguna tiene <: no se quitó
ni se cambió nada de lo que había. Comprobemos: 40 + 76 + 23 = 139.
Y además, siguen corriendo las pruebas antiguas de test_trips_total.c, que son las mismas de
test_trips.c y una más. Son las que dicen que lo anterior sigue funcionando. Por eso se conservan,
y por eso se corren todas, no solo la nueva.
Idea clave. Las pruebas son lo que les permite cambiar sin miedo un programa que no escribieron. Se corren antes de cambiar, para saber que parten de algo sano, y después de cada cambio, para saber que no rompieron nada. Si tienen que cambiar una prueba antigua para que pase, deténganse: están cambiando lo que el programa promete.
El laboratorio, paso a paso
El laboratorio está en code/week-02/lab, y su README.md tiene
los detalles. Es un programa de unas 200 líneas, grades.c, que lee un archivo de notas y escribe un
reporte y un resumen. Pueden correrlo así, desde esa carpeta:
cd lab
printf 'notas.txt\n' | ../build/lab/grades
Sesión 1. Lo leen sin cambiar nada, con el método de hoy, y responden por escrito las preguntas
del README.md: qué hace cada función, quién llama a quién y qué forma tienen los datos. Después
corren make test-grades, que da varias comprobaciones rojas. Hay exactamente dos bugs, y las
comprobaciones rojas son más que eso. Vayan de la más pequeña a la más grande, con una hipótesis
antes de cada cambio.
Sesión 2. Agregan dos cosas, con pruebas: el promedio de cada estudiante sin su nota más baja, y una opción para filtrar por sección. Para la segunda, el reto es tocar la menor cantidad posible de código. Vuelvan a la pregunta de “Extender”: ¿por dónde pasan todos los datos?
Las pruebas de make test-grades están en C, en test_grades.c, y ustedes las van a leer y a
extender. make test-lab corre además otras pruebas, que son las que dicen si el laboratorio está
terminado: falla hasta que hagan las dos sesiones.
El código de la semana
| Archivo | Qué muestra |
|---|---|
array_review.c |
Capacidad y longitud, y arreglos en funciones |
string_review.c |
sizeof y strlen, y strcmp |
struct_review.c |
Un struct se copia, y un arreglo de struct no |
file_review.c, paraderos.txt |
Abrir, leer, separar campos y cerrar |
trips.c, viajes.txt |
El programa que leímos |
test_trips.c |
Sus pruebas |
trips_total.c, test_trips_total.c |
La misma cosa, con una función más y sus pruebas |
errors/ |
sizeof_param, array_overflow, no_terminator, copy_overflow, compare_strings, y trips_bug con sus pruebas |
lab/ |
El laboratorio |
Dentro del entorno, make compila los ejemplos y make test corre todo lo que se puede comprobar. Eso
incluye los comandos de este capítulo: las pruebas de test_notes.py los vuelven a ejecutar y comparan
las salidas, salvo las direcciones y otros datos que cambian de una corrida a otra.
$ build/test_trips
Todas las pruebas pasan
Resumen
- Un arreglo tiene capacidad y longitud. Al pasarlo a una función, viaja su dirección: la longitud va
aparte y
sizeofno la da. Salirse es comportamiento indefinido, y los sanitizers lo muestran. - Una cadena es un arreglo de
charque termina en'\0', así que un texto dekbytes necesitak + 1.char s[5] = "hola!"deja un arreglo sin'\0', y copiar"hola!"asescribe de más. Se compara constrcmp, y%ssiempre lleva un límite. - Un
structse copia entero al asignarlo y al pasarlo. Un arreglo destructno se copia. - Se revisa lo que devuelven
fopen,fgetsysscanf. El ciclo de lectura tiene como condición el resultado de la lectura, ysscanfdebe convertir justo los campos esperados. - Un programa no se lee de la primera línea a la última. Método: empezar por
mainy las firmas, ejecutarlo con un ejemplo, seguir un dato de principio a fin y escribir lo que se entendió. - Las pruebas son documentación que se ejecuta: dicen cómo se usa una función y qué hace en los bordes, y a diferencia de un comentario, fallan si dejan de ser ciertas.
- Para corregir: leer la prueba que falla, formular una hipótesis, cambiar lo mínimo y correr todo. Un bug puede hacer fallar muchas pruebas.
- Para extender: partir de pruebas que pasan, escribir la prueba primero, tocar lo menos posible y conservar las pruebas antiguas.
Ejercicios
Los primeros repasan los datos. Los demás usan trips.c y el método. Compilen siempre con
-Wall -Wextra -std=c17 -g -fsanitize=address,undefined.
-
Sin correrlo, digan qué escribe este fragmento y por qué. Después compruébenlo.
char s[10] = "lima"; printf("%zu %zu\n", sizeof(s), strlen(s)); s[1] = '\0'; printf("%zu %zu %s\n", sizeof(s), strlen(s), s); -
Escriban
int count_above(const int a[], int n, int limit), que cuenta cuántos elementos son mayores quelimit, con pruebasassertpara un arreglo vacío y para el bordea[i] == limit. -
¿Cuántos bytes necesita un arreglo para guardar
"Begoña"? Compruébenlo constrleny expliquen la diferencia con la cantidad de letras. -
Sin correrlo, digan qué escribe el programa si
mainhacestruct student c = with_first(a, 5);y después escribeayc. Luego digan qué cambia siwith_firstno tiene elreturn sy su tipo esvoid. Usen las definiciones destruct_review.c. -
Agreguen a
file_review.cun aviso más: si un número es negativo, la línea se trata como mal formada. Prueben con un archivo que tenga esa línea y otro que esté vacío. -
Leer. En
trips.c, sin correr nada, respondan: ¿qué funciones pueden cambiarroutes? ¿Cómo lo saben solo con mirar las firmas? -
Leer las pruebas. Escriban una versión de
busiest_routeque compare el promedio por viaje. ¿Qué prueba detest_trips.cfalla, y cuáles siguen pasando? ¿Qué nos dice esto de la pruebatest_busiest_route? -
Investigar una duda. Agreguen a una copia de
viajes.txtuna línea con 100 letras seguidas y un número. Antes de corrertrips, decidan cuántos avisos debería dar. Corran y expliquen lo que sale, incluyendo los números de línea de los avisos siguientes. -
Investigar otra. ¿Qué hace
tripscon un archivo de 9 rutas distintas, siMAX_ROUTESes 8? ¿Pierde datos en silencio? Agreguen a una copia detest_trips.cuna prueba que documente lo que hace, y compruébenla. -
Regla escondida.
busiest_routedevuelve -1 sin <= 0. Enmain, la línea que lo usa escriberoutes[busiest_route(routes, n)].namesin revisar si es -1. ¿Es un error? Respondan siguiendo los caminos demainque llegan a esa línea. -
Extender. Agreguen a una copia de
trips.cla funciónquietest_route, la ruta con menos pasajeros, con la prueba primero. ¿Qué devuelve con un empate y por qué? Condiff, comprueben que no cambiaron nada de lo que ya estaba. -
Un programa nuevo. Escríbanle a alguien la nota del paso 4 para
struct_review.c, y luego para uno de sus programas del laboratorio de la semana 1. ¿Cuál fue más difícil? ¿Por qué?