Apuntes · Capítulo 6Memoria y abstracción
Programas en varios archivos
Programas en varios archivos
Desde la semana 3 usan un módulo de imágenes sin haber visto cómo se arma. Dijimos “basta con
#include "image.h", y el Makefile se encarga de lo demás”. En la semana 2 pedimos otra cosa
parecida: tomar como receta tres líneas raras al inicio de las pruebas, con #define main. Y en la
semana 3 quedaron dos promesas: explicar qué hace static delante de una función y para qué sirven
las líneas #ifndef de un encabezado.
Hoy pagamos esas deudas. Un programa de verdad no cabe en un solo archivo, y no es solo por el
tamaño. Dividirlo obliga a contestar una pregunta de diseño: ¿qué necesita saber cada parte sobre
las demás? La respuesta que buscamos es “lo menos posible”. Veremos cómo se escribe eso en C, qué
errores aparecen cuando se hace mal, y cómo make recompila solo lo necesario. Al final llegaremos
a los tipos opacos, con los que el compilador mismo impide que el resto del programa dependa de
cómo está hecho un módulo. Con ellos se puede cambiar por completo una implementación y correr las
mismas pruebas, sin tocarlas y sin volver a compilarlas.
Ruta de lectura.
- Antes de clase (15 a 20 minutos, obligatoria): la introducción, Abstracción: saber qué, sin saber cómo y De un archivo a varios.
- En clase: Los errores de trabajar con varios archivos, Guardas de inclusión,
staticen una función: lo privado,make: recompilar solo lo necesario, Documentar un módulo y Tipos opacos.- Después de clase: Pruebas por la interfaz, Bloques enlazados, El módulo de imágenes, ahora opaco y El laboratorio, paso a paso. Luego el Resumen y los Ejercicios. Para ir más allá: los últimos ejercicios del capítulo.
Código. Los programas de este capítulo están en
code/week-06. Dentro del entorno del curso, entren a esa carpeta y corranmakepara compilar los ejemplos ymake testpara comprobarlos. Cada bloque de terminal de este capítulo empieza en esa carpeta. Si el bloque tiene uncd, esecdvale para las líneas que siguen. Los programas deerrors/tienen errores a propósito.
Abstracción: saber qué, sin saber cómo
Cuando usan printf, saben qué hace: escribe texto con formato. No saben cómo lo hace, y no
les hace falta. Esa es la idea de abstracción: usar algo sabiendo qué hace, sin saber cómo.
Un módulo tiene entonces dos caras, que ya nombramos en la semana 3:
| Cara | Qué contesta | A quién le importa | En C |
|---|---|---|---|
| Interfaz (interface) | Qué ofrece y qué promete | A quien usa el módulo | Archivo .h, el encabezado (header) |
| Implementación (implementation) | Cómo lo cumple | A quien escribe el módulo | Archivo .c |
Esta separación da dos ventajas concretas. La primera es para leer: para usar el módulo basta con leer su encabezado, que es mucho más corto que el código. La segunda es para cambiar: si el resto del programa solo depende de la interfaz, la implementación se puede arreglar o reescribir sin tocar nada más.
Idea clave. Una interfaz es una promesa. Todo lo que quien usa el módulo puede ver, tarde o temprano alguien lo va a usar, y ya no lo podrán cambiar. Por eso se muestra lo menos posible.
De un archivo a varios
Nuestro primer ejemplo escribe el ticket de una compra. Está en la carpeta receipt, repartido en
tres módulos y un main:
| Archivos | Qué hace |
|---|---|
money.h, money.c |
Montos en céntimos de sol: descuentos y escribirlos |
item.h, item.c |
Un artículo comprado y lo que cuesta |
ticket.h, ticket.c |
Escribe la compra completa, y usa los otros dos |
receipt.c |
El main: arma una compra y pide el ticket |
Este es el encabezado del módulo más simple, money.h:
#ifndef MONEY_H
#define MONEY_H

// Devuelve el monto menos percent por ciento. Los céntimos que sobran de la división no
// se descuentan. Exige: cents >= 0 y 0 <= percent <= 100.
int money_discount(int cents, int percent);

// Escribe el monto en la forma S/ 12.50, sin salto de línea. Exige: cents >= 0.
void money_print(int cents);

#endif
Tiene solo prototipos, que vieron en Introducción a la Computación: el tipo, el nombre y los
parámetros de la función, sin su cuerpo. Las líneas #ifndef las explicamos en un momento. Los
cuerpos están en money.c:
#include "money.h"

#include <stdio.h>

#define CENTS_PER_SOL 100

// Privada: solo este archivo la puede llamar.
static int percent_of(int cents, int percent) {
    return cents * percent / 100;
}

int money_discount(int cents, int percent) {
    return cents - percent_of(cents, percent);
}

void money_print(int cents) {
    printf("S/ %d.%02d", cents / CENTS_PER_SOL, cents % CENTS_PER_SOL);
}
Quien quiera usar el módulo incluye su encabezado. Fíjense en las comillas: #include "money.h"
busca primero en la carpeta del archivo, y #include <stdio.h> busca en las carpetas del sistema.
Y este es todo el programa principal, receipt.c. Como la compra usa struct item y el ticket lo
escribe ticket_print, incluye los dos encabezados. No sabe que existe el módulo de dinero:
#include "item.h"
#include "ticket.h"

int main(void) {
    const struct item items[] = {
        {"Arroz", 2, 450},
        {"Aceite", 1, 1290},
        {"Huevos", 12, 60},
    };
    int n = (int) (sizeof(items) / sizeof(items[0]));

    ticket_print(items, n, 10);
    return 0;
}
Compilar por separado y enlazar
En la semana 1 vieron que gcc hace cuatro pasos, y que el último es el del enlazador (linker).
Hasta ahora los hacían todos de un golpe. Con varios archivos conviene separarlos en dos etapas:
- Compilar cada
.cpor su cuenta, con la opción-c. Eso produce un archivo objeto (object file), un.o, con el código máquina de ese archivo. - Enlazar todos los
.oen un ejecutable.
$ cd receipt
$ make clean
rm -rf build
$ mkdir build
$ gcc -Wall -Wextra -std=c17 -c money.c -o build/money.o
$ gcc -Wall -Wextra -std=c17 -c item.c -o build/item.o
$ gcc -Wall -Wextra -std=c17 -c ticket.c -o build/ticket.o
$ gcc -Wall -Wextra -std=c17 -c receipt.c -o build/receipt.o
$ gcc build/receipt.o build/ticket.o build/item.o build/money.o -o build/receipt
$ build/receipt
Arroz      2  S/ 9.00
Aceite     1  S/ 12.90
Huevos    12  S/ 7.20
Total:         S/ 29.10
Con 10%:       S/ 26.19
Lo importante es lo que no pasa en el primer paso. Cuando el compilador trabaja en receipt.c, no
abre ticket.c. Ni siquiera sabe si existe. Solo ve el prototipo de ticket_print, le basta para
comprobar que la llamada está bien escrita, y deja anotado “aquí hace falta ticket_print”. Esa nota
la resuelve después el enlazador.
Esas notas se pueden ver. El comando nm lista los nombres que hay en un objeto:
$ cd receipt
$ nm build/receipt.o
0000000000000000 T main
                 U ticket_print
$ nm build/money.o
000000000000003c T money_discount
000000000000006c T money_print
0000000000000000 t percent_of
U printf| Letra | Qué significa |
|---|---|
T |
Este objeto define esa función, y la ofrece a los demás |
t |
Este objeto la define, pero es privada: no la ofrece |
U |
Este objeto la usa, y otro debe definirla (undefined) |
El trabajo del enlazador es juntar cada U con un T. printf no está en ningún objeto nuestro: la
trae la biblioteca de C, que también se enlaza. Las direcciones de la primera columna cambian según la
máquina. Este es el proceso completo, con lo que entra en cada compilación:
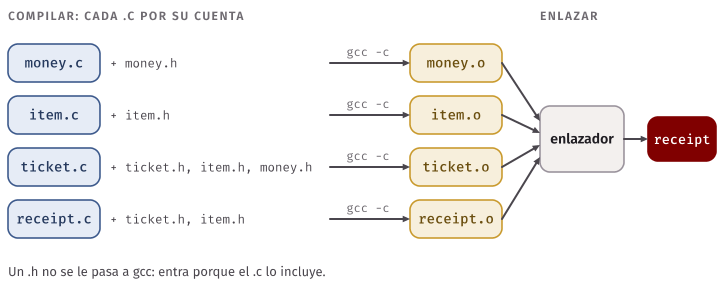
En C. Un
.hno se compila por sí solo y nunca se le pasa agccen la línea de comandos. Entra en la compilación porque un.clo incluye.
#include copia texto
No hay nada mágico en #include. El preprocesador, el primer paso de gcc, reemplaza esa línea por
el contenido del archivo, tal cual. Se puede ver con gcc -E, que se detiene después de ese paso. La
opción -P quita unas anotaciones que aquí solo estorban:
$ gcc -E -P receipt/receipt.c
struct item {
    const char *name;
    int quantity;
    int unit_cents;
};
int item_total(const struct item *item);
int items_total(const struct item items[], int n);
void ticket_print(const struct item items[], int n, int percent);
int main(void) {
    const struct item items[] = {
        {"Arroz", 2, 450},
        {"Aceite", 1, 1290},
        {"Huevos", 12, 60},
    };
    int n = (int) (sizeof(items) / sizeof(items[0]));
    ticket_print(items, n, 10);
    return 0;
}
Esto es exactamente lo que ve el compilador: un solo texto, sin encabezados. Con esto ya se entiende casi todo lo que sigue. También los comentarios desaparecen en este paso.
Los errores de trabajar con varios archivos
Cada error de esta sección sale de una etapa distinta. Saber de cuál viene es la mitad de la solución:
si el mensaje empieza con el nombre de un .c y tiene número de línea, es del compilador. Si viene de
/usr/bin/ld, es del enlazador, y el código de cada archivo está bien por separado.
Olvidar el prototipo
errors/no_prototype.c llama a money_print sin incluir money.h:
$ gcc -Wall -Wextra -std=c17 -c errors/no_prototype.c
errors/no_prototype.c: In function ‘main’:
errors/no_prototype.c:3:5: error: implicit declaration of function ‘money_print’ [-Wimplicit-function-declaration]
    3 |     money_print(1250);
      |     ^~~~~~~~~~~
Es un error del compilador, en la etapa 1: no sabe qué es money_print, porque solo ve este archivo y
lo
que incluye. Es el mismo mensaje de Introducción a la Computación. La solución es incluir el encabezado.
En C. En versiones antiguas de
gccesto era solo una advertencia, y el programa compilaba suponiendo que la función devolvíaint. Si leen material viejo, lo verán así. Con elgccde nuestro entorno es un error, y eso ayuda.
Olvidar un módulo al enlazar
Ahora todo compila, pero no le damos al enlazador el módulo de tickets:
$ cd receipt
$ gcc receipt.c item.c money.c -o build/incomplete
/usr/bin/ld: /tmp/ccDx09yb.o: in function `main':
receipt.c:(.text+0x40): undefined reference to `ticket_print'
collect2: error: ld returned 1 exit status
Quedó un U sin su T. Este mensaje ya lo vieron en la semana 2, con sqrt. El nombre
/tmp/cc....o es
un objeto temporal de gcc, y cambia en cada corrida. El número de (.text+0x40) es un lugar dentro del
código, y cambia según la máquina. Lo que hay que leer es undefined reference to: el
código de receipt.c está bien, y falta enlazar el archivo que define esa función.
Definir la misma función en dos archivos
errors/money_twin.c define su propia money_print. Por separado, cada archivo compila sin problema.
El
problema aparece al juntarlos:
$ cd receipt
$ make
make: 'build/receipt' is up to date.
$ gcc -c ../errors/money_twin.c -o build/money_twin.o
$ gcc build/receipt.o build/ticket.o build/item.o build/money.o build/money_twin.o -o build/twin
/usr/bin/ld: build/money_twin.o: in function `money_print':
money_twin.c:(.text+0x0): multiple definition of `money_print'; build/money.o:money.c:(.text+0x6c): first defined here
collect2: error: ld returned 1 exit status
Hay dos T con el mismo nombre, y el enlazador no elige. Un programa tiene un solo namespace
para las funciones que no son static, y por eso los nombres de un módulo suelen llevar su nombre
delante:
money_print, item_total, ticket_print. C no tiene otra forma de evitar choques.
Poner el cuerpo de una función en un encabezado
Este error parece otro, y es el mismo. errors/header_body/twice.h trae el cuerpo de twice, no solo
su
prototipo. Dos archivos lo incluyen:
$ cd errors/header_body
$ gcc first.c second.c -o program
/usr/bin/ld: /tmp/ccJrsYvW.o: in function `twice':
second.c:(.text+0x0): multiple definition of `twice'; /tmp/ccN6PXnB.o:first.c:(.text+0x0): first defined here
collect2: error: ld returned 1 exit status
Como #include copia texto, es como si hubieran escrito la función en los dos .c. Por eso:
Va en el .h |
Va en el .c |
|---|---|
| Prototipos de lo que el módulo ofrece | Cuerpos de las funciones |
struct que quien usa el módulo debe conocer |
Funciones static y struct privados |
#define que hacen falta para usar el módulo |
#define que solo usa ese archivo |
| Comentarios con lo que se promete | Comentarios sobre cómo se hace |
Definir un struct en un encabezado no causa este problema. Un struct no genera código ni ocupa
memoria
por sí solo: es una descripción que el compilador usa mientras compila cada archivo.
Por qué cada .c incluye su propio encabezado
Fíjense que money.c empieza con #include "money.h", aunque parezca innecesario. errors/drift.c
muestra
para qué sirve. Alguien cambió el tipo que devuelve area, y olvidó cambiar el encabezado:
$ gcc -Wall -Wextra -std=c17 -c errors/drift.c
errors/drift.c:5:8: error: conflicting types for ‘area’; have ‘double(int,  int)’
    5 | double area(int width, int height) {
      |        ^~~~
In file included from errors/drift.c:3:
errors/drift.h:5:5: note: previous declaration of ‘area’ with type ‘int(int,  int)’
    5 | int area(int width, int height);
      |     ^~~~
Como el .c incluye su encabezado, el compilador ve la promesa y el cuerpo en un mismo texto, y los
compara.
Si no lo incluyera, este archivo compilaría sin queja. Los demás seguirían llamando a la función según
el
prototipo viejo, el enlazador solo compara nombres, no tipos, y el programa tendría comportamiento
indefinido.
Idea clave. El enlazador solo mira nombres. Quien comprueba los tipos es el compilador, y solo ve los prototipos que cada archivo incluye. Por eso todos, también el propio
.c, incluyen el mismo encabezado.
Guardas de inclusión
ticket.h necesita a struct item, así que incluye item.h. Y receipt.c incluye item.h y también
ticket.h. Entonces item.h entra dos veces en el mismo texto. Quien escribe receipt.c no tiene
por qué
saber lo que incluye cada encabezado. Eso debería funcionar.
La carpeta errors/no_guard tiene la misma forma, pero sus encabezados no se protegen. segment.h
incluye
point.h, y main.c incluye los dos. Lo que le llega al compilador es esto:
$ gcc -E -P errors/no_guard/main.c
struct point {
    int x;
    int y;
};
int point_sum(struct point p);
struct point {
    int x;
    int y;
};
int point_sum(struct point p);
struct segment {
    struct point from;
    struct point to;
};
int main(void) {
    struct segment segment = {{0, 0}, {3, 4}};
    struct point end = segment.to;
    return end.x - 3;
}
Está struct point definido dos veces, y C no lo permite, aunque las dos definiciones sean iguales:
$ gcc -Wall -Wextra -std=c17 -c errors/no_guard/main.c
In file included from errors/no_guard/segment.h:2,
                 from errors/no_guard/main.c:3:
errors/no_guard/point.h:2:8: error: redefinition of ‘struct point’
    2 | struct point {
      |        ^~~~~
In file included from errors/no_guard/main.c:2:
errors/no_guard/point.h:2:8: note: originally defined here
    2 | struct point {
      |        ^~~~~
errors/no_guard/point.h:7:5: error: conflicting types for ‘point_sum’; have ‘int(struct point)’
    7 | int point_sum(struct point p);
      |     ^~~~~~~~~
errors/no_guard/point.h:7:5: note: previous declaration of ‘point_sum’ with type ‘int(struct point)’
    7 | int point_sum(struct point p);
      |     ^~~~~~~~~
Lean solo el primer error: el segundo es consecuencia de él. La solución es una guarda de inclusión (include guard), tres líneas del preprocesador que rodean todo el encabezado:
#ifndef ITEM_H
#define ITEM_H
...
#endif
#ifndef ITEM_H significa “si ITEM_H todavía no está definido, sigue; si no, sáltate todo hasta
#endif”. Sigamos
el preprocesador sobre receipt.c:
| Paso | Dónde está | ITEM_H definido |
Qué pasa |
|---|---|---|---|
| 1 | #include "item.h", primera vez |
No | Entra, define ITEM_H y copia el struct |
| 2 | #include "ticket.h" |
Sí | Empieza a copiar ticket.h |
| 3 | #include "item.h", dentro de ticket.h |
Sí | Se salta todo hasta #endif: no copia nada |
Por eso, en la salida de gcc -E de la sección anterior, struct item aparece una sola vez. El
nombre de la
guarda es una convención: el nombre del archivo en mayúsculas, único en el programa. Todo encabezado
lleva guarda.
Error común. Creer que la guarda arregla el
multiple definition. No lo hace, y lo vieron arriba:twice.htiene guarda, y aun así falló. La guarda evita repetir un encabezado dentro de un mismo.c. Cada.cse compila por su lado y empieza sin nada definido, así que cada uno recibe su copia. Elmultiple definitionviene del enlazador, que ve los dos objetos.
static en una función: lo privado
En la semana 3, static dentro de una función cambiaba el tiempo de vida de una variable local.
Delante de una
función la palabra significa otra cosa, y no tiene que ver con el tiempo de vida: esa función solo
se puede usar en
este archivo.
static int percent_of(int cents, int percent) {Ya vieron su efecto en nm: percent_of aparece con t minúscula, y por eso el enlazador no la
ofrece a nadie. Ni
siquiera sirve declararla a mano. errors/call_private.c escribe un prototipo correcto:
$ cd receipt
$ gcc ../errors/call_private.c money.c -o build/private
/usr/bin/ld: /tmp/ccFFa81z.o: in function `main':
call_private.c:(.text+0x10): undefined reference to `percent_of'
collect2: error: ld returned 1 exit status
Marcar lo privado da tres ventajas:
- Se puede cambiar. Como nadie afuera la usa,
percent_ofse puede renombrar o borrar con solo mirarmoney.c. - No choca. Dos archivos pueden tener cada uno su propia función
staticllamadaprint_line, sin conflicto. - Comunica. Quien lee sabe que esa función es un detalle.
La regla práctica: toda función de un módulo que no está en su encabezado lleva static. Y el
mismo razonamiento vale
para los #define: CENTS_PER_SOL está en money.c porque nadie más necesita saberlo.
make: recompilar solo lo necesario
Escribir cinco comandos cada vez cansa, y recompilar todo es un desperdicio. Pero el verdadero
problema es otro: si
recompilan a mano, tarde o temprano olvidarán algún archivo, y correrán un programa viejo. Hasta ahora
usaron los Makefile que
les dimos. Hoy los leemos y aprendemos a escribirlos.
Un Makefile es una lista de reglas. Cada una dice cómo fabricar un archivo y de qué depende:
$(BUILD)/money.o: money.c money.h | $(BUILD)
$(CC) $(CFLAGS) -c $< -o $@| Parte | En el ejemplo | Qué es |
|---|---|---|
| Objetivo (target) | $(BUILD)/money.o |
Lo que se fabrica |
| Dependencias (prerequisites) | money.c money.h |
De qué depende. Si alguno es más nuevo que el objetivo, hay que volver a fabricarlo |
| Receta (recipe) | $(CC) $(CFLAGS) -c $< -o $@ |
El comando. Va con un tabulador al inicio |
| Variables | $(BUILD), $(CC), $(CFLAGS) |
Se definen arriba y evitan repetir |
$@ |
build/money.o |
El objetivo de esta regla |
$< |
money.c |
La primera dependencia |
$^ |
Todas las dependencias. Lo usa el Makefile de tally |
Lo que va después de | es una dependencia especial: build debe existir antes, pero no importa la
hora de la carpeta.
Sin esa barra, cada archivo que se crea dentro de build cambiaría la hora de la carpeta, y make
volvería a compilar todo.
Este es el comienzo de receipt/Makefile:
CC = gcc
CFLAGS = -Wall -Wextra -std=c17
BUILD = build
OBJECTS = $(BUILD)/receipt.o $(BUILD)/ticket.o $(BUILD)/item.o $(BUILD)/money.o

$(BUILD)/receipt: $(OBJECTS)
	$(CC) $(OBJECTS) -o $@

$(BUILD)/receipt.o: receipt.c ticket.h item.h | $(BUILD)
	$(CC) $(CFLAGS) -c $< -o $@

$(BUILD)/ticket.o: ticket.c ticket.h item.h money.h | $(BUILD)
	$(CC) $(CFLAGS) -c $< -o $@

$(BUILD)/item.o: item.c item.h | $(BUILD)
	$(CC) $(CFLAGS) -c $< -o $@
Cuando corren make sin más, fabrica el primer objetivo del archivo, aquí build/receipt. Antes
revisa sus dependencias,
y las dependencias de esas dependencias. make no entiende C: solo compara las horas de modificación
de los archivos.
$ cd receipt
$ make clean
rm -rf build
$ make
mkdir -p build
gcc -Wall -Wextra -std=c17 -c receipt.c -o build/receipt.o
gcc -Wall -Wextra -std=c17 -c ticket.c -o build/ticket.o
gcc -Wall -Wextra -std=c17 -c item.c -o build/item.o
gcc -Wall -Wextra -std=c17 -c money.c -o build/money.o
gcc build/receipt.o build/ticket.o build/item.o build/money.o -o build/receipt
$ make
make: 'build/receipt' is up to date.
El comando touch cambia la hora de un archivo sin cambiar su contenido, como si lo hubieran editado.
Toquemos un .c:
$ cd receipt
$ touch money.c
$ make
gcc -Wall -Wextra -std=c17 -c money.c -o build/money.o
gcc build/receipt.o build/ticket.o build/item.o build/money.o -o build/receipt
Se recompiló un archivo y se volvió a enlazar. Ahora, un encabezado:
$ cd receipt
$ touch money.h
$ make
gcc -Wall -Wextra -std=c17 -c ticket.c -o build/ticket.o
gcc -Wall -Wextra -std=c17 -c money.c -o build/money.o
gcc build/receipt.o build/ticket.o build/item.o build/money.o -o build/receipt
$ touch item.h
$ make
gcc -Wall -Wextra -std=c17 -c receipt.c -o build/receipt.o
gcc -Wall -Wextra -std=c17 -c ticket.c -o build/ticket.o
gcc -Wall -Wextra -std=c17 -c item.c -o build/item.o
gcc build/receipt.o build/ticket.o build/item.o build/money.o -o build/receipt
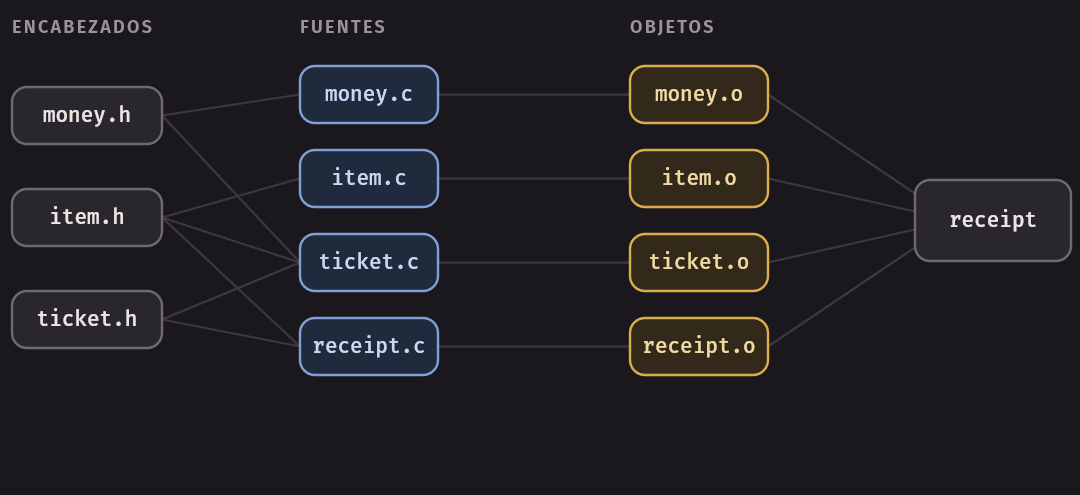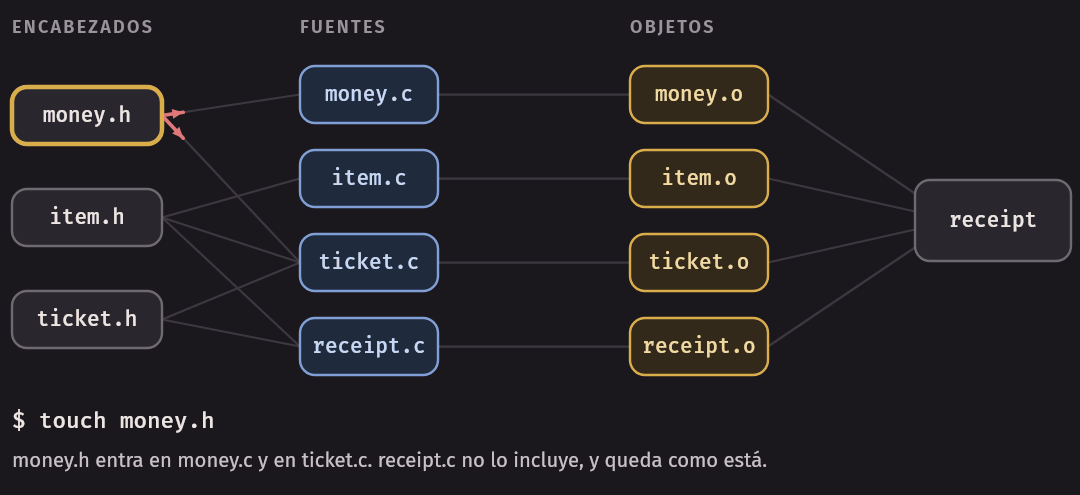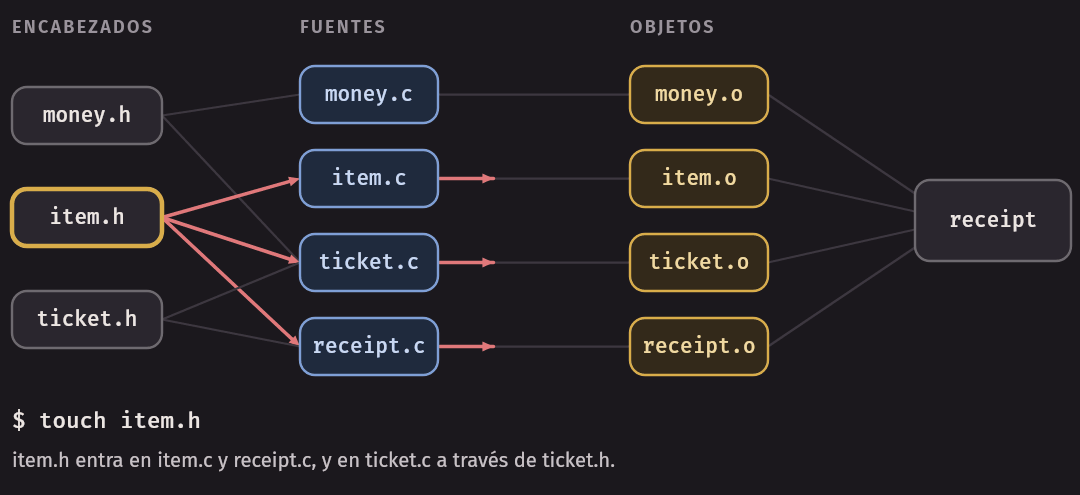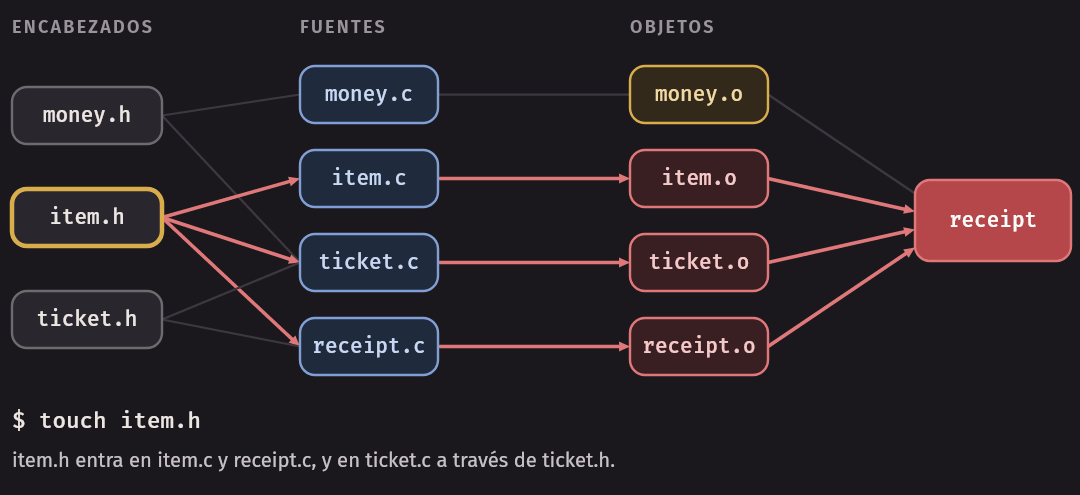
Tiene sentido. money.h lo incluyen money.c y ticket.c, y por eso se recompilan esos dos.
receipt.c no lo incluye, y queda
como está. item.h entra en receipt.c y en ticket.c a través de ticket.h, además de en item.c.
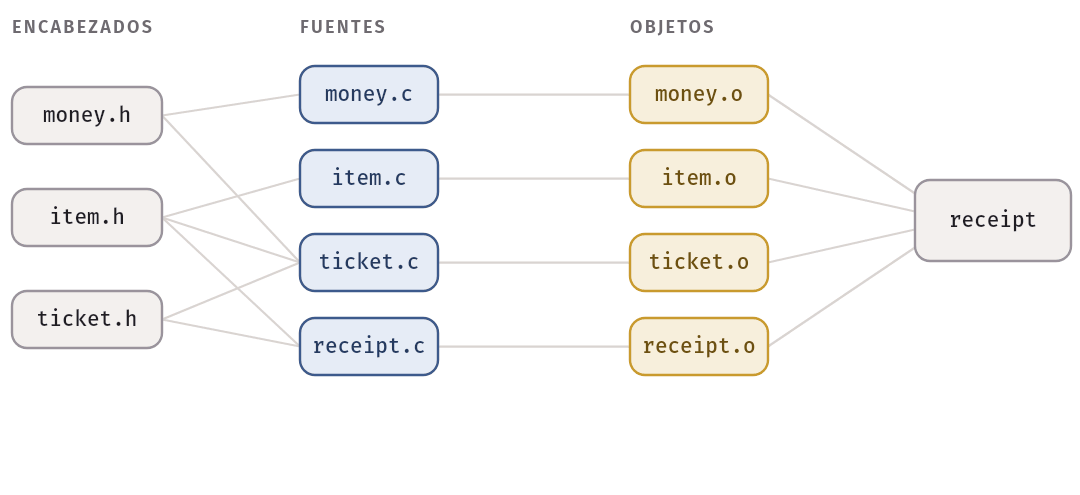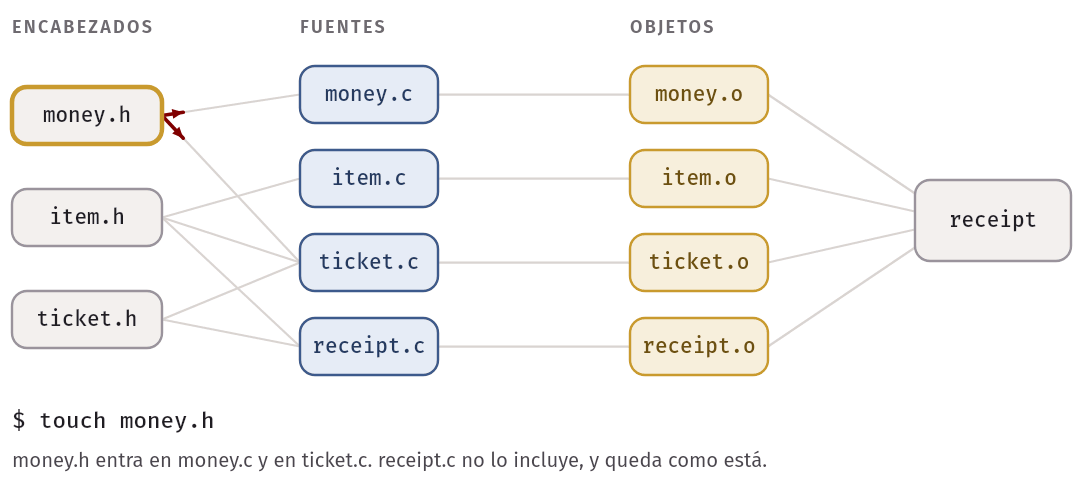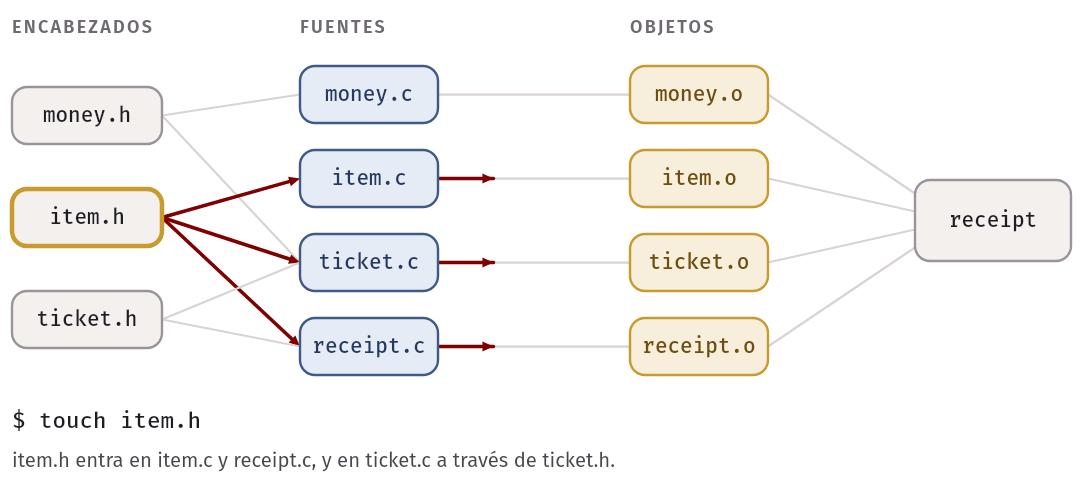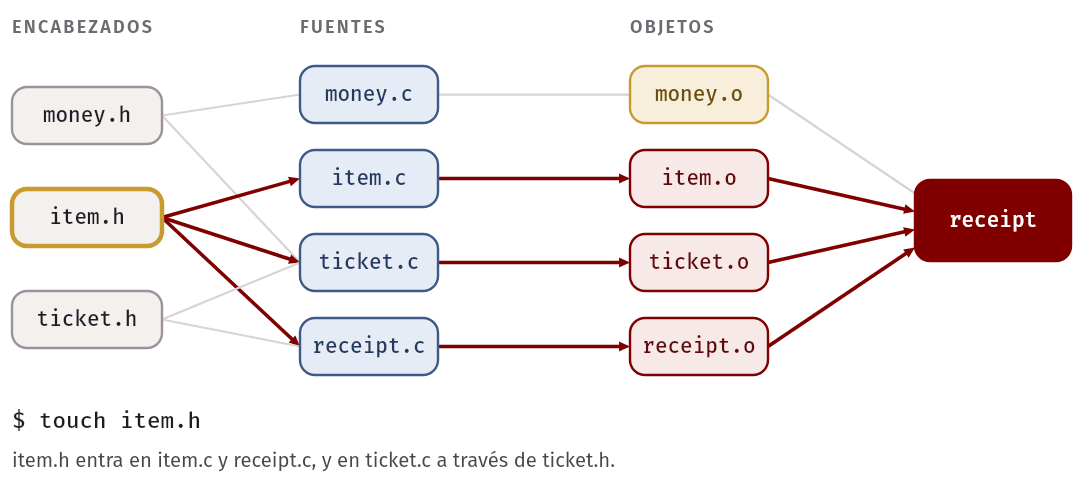
Idea clave. Si cambia un
.h, hay que recompilar todo.cque lo incluya, directa o indirectamente. Si cambia un.c, solo ese. En los dos casos se vuelve a enlazar.
Error común. Usar espacios en lugar del tabulador en la receta.
errors/no_tab.mklo tiene:$ make -f errors/no_tab.mk errors/no_tab.mk:2: *** missing separator. Stop.
Un Makefile que miente
Las dependencias las escriben ustedes, y make les cree. ¿Qué pasa si faltan? La carpeta stale trae
un Makefile mal hecho a
propósito. Su regla dice que cada .o depende solo de su .c:
$(BUILD)/%.o: %.c | $(BUILD)El % es un comodín: esta regla sirve para cualquier .o que tenga su .c. Compilemos, y luego
simulemos un cambio en el encabezado
copiando otra versión: rectangle_v2.h agrega un campo id al inicio del struct.
$ cd stale
$ make clean
rm -rf build
$ make
mkdir -p build
gcc -Wall -Wextra -std=c17 -c main.c -o build/main.o
gcc -Wall -Wextra -std=c17 -c rectangle.c -o build/rectangle.o
gcc build/main.o build/rectangle.o -o build/show
$ build/show
3 x 5
$ cp rectangle_v2.h rectangle.h
$ make
make: 'build/show' is up to date.
Ya está mal: el encabezado cambió, y make dice que todo está al día. El programa viejo todavía
funciona, así que nadie lo nota. Después,
alguien edita main.c, por cualquier otra razón:
$ cd stale
$ touch main.c
$ make
gcc -Wall -Wextra -std=c17 -c main.c -o build/main.o
gcc build/main.o build/rectangle.o -o build/show
$ build/show
0 x 3
Compiló sin ninguna advertencia, y escribe 0 x 3. Para seguirlo, hace falta esta línea de main.c:
struct rectangle rectangle = {.width = 3, .height = 5};Esta forma de inicializar es nueva para ustedes: llena los campos por su nombre, y deja en 0 los que no
menciona. Con el struct nuevo, id queda en 0. Dibújenlo: main.o se compiló con ese struct,
donde el primer int es id, que vale 0, y width es el segundo. rectangle.o sigue con el struct viejo, y cree que el primer int es
width. Los dos archivos leen la misma memoria con
dos planos distintos.
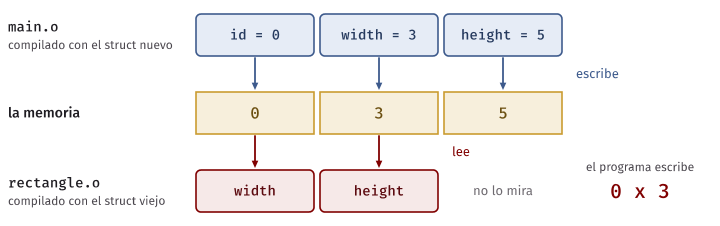
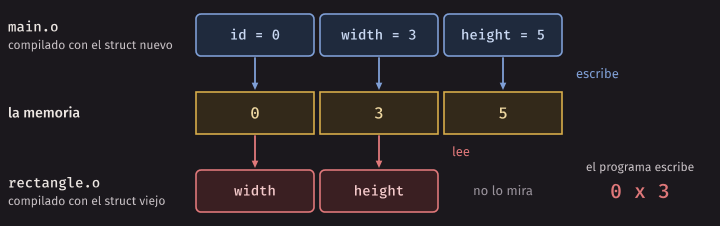
Nada en rectangle.c ni en main.c tiene un bug. Y el error desaparece solo
con recompilar todo:
$ cd stale
$ make clean
rm -rf build
$ make
mkdir -p build
gcc -Wall -Wextra -std=c17 -c main.c -o build/main.o
gcc -Wall -Wextra -std=c17 -c rectangle.c -o build/rectangle.o
gcc build/main.o build/rectangle.o -o build/show
$ build/show
3 x 5
$ cp rectangle_v1.h rectangle.h
La última línea deja la carpeta como estaba. Si alguna vez un programa hace algo imposible justo
después de cambiar un .h, prueben make clean y make.
Si eso lo arregla, su Makefile tiene una dependencia de menos.
Para no adivinar la lista, gcc -MM la calcula. Sale una regla casi lista para copiar:
$ cd receipt
$ gcc -MM ticket.c
ticket.o: ticket.c ticket.h item.h money.h
Documentar un módulo
El encabezado es el único texto que muchos van a leer, así que sus comentarios son parte de la interfaz. Por cada función deben contestar tres preguntas:
| Pregunta | Ejemplo en tally.h |
|---|---|
| Qué promete: qué hace y qué devuelve, también al fallar | “Devuelve 1 si pudo y 0 si no hay memoria; en ese caso, no cambia nada” |
| Qué exige: qué debe cumplir quien la llama | “Exige: tally_count(tally) > 0” |
| Quién es owner de la memoria | “Owner: quien llama, que debe liberarlo con tally_free” |
Lo que se exige es un contrato. Si quien llama no lo cumple, la función no debe nada. No hace falta
contar cómo funciona por dentro: un comentario que
menciona un campo o un realloc está haciendo pública una decisión que debería ser privada.
Error común. Comentar lo que ya dice el nombre:
// Devuelve el conteoencima detally_countno agrega casi nada. Lo que el nombre no dice es lo que vale la pena escribir: qué pasa con cero valores, con NULL, o si hay que liberar algo.
Tipos opacos
Las guardas y static ocultan funciones. Pero en item.h el struct está a la vista, y cualquiera
que lo incluya puede leer item->quantity. Si mañana cambiamos ese
campo, se rompe todo el que lo haya usado. Y en la sección de stale vimos que basta tocar un
struct en un encabezado para tener que recompilar a todos. ¿Se puede
mostrar el tipo sin mostrar sus campos? Sí.
Nuestro ejemplo es un acumulador (Tally): se le agregan enteros, y responde cuántos son, cuánto
suman y cuál es el mayor. Este es el corazón de tally/tally.h:
typedef struct tally Tally;

// Crea un acumulador vacío. Devuelve NULL si no hay memoria.
// Owner: quien llama, que debe liberarlo con tally_free.
Tally *tally_new(void);

// Libera el acumulador. Acepta NULL. Después de esto, tally ya no se puede usar.
void tally_free(Tally *tally);

// Agrega un valor. Devuelve 1 si pudo y 0 si no hay memoria; en ese caso, no cambia nada.
// Exige: la suma de todos los valores cabe en un int.
int tally_add(Tally *tally, int value);

// Devuelve cuántos valores se agregaron.
int tally_count(const Tally *tally);

// Devuelve la suma de los valores. Con cero valores, es 0.
int tally_sum(const Tally *tally);

// Devuelve el mayor valor. Exige: tally_count(tally) > 0.
int tally_max(const Tally *tally);
La primera línea hace dos cosas. struct tally anuncia que existe un struct con ese nombre, sin
decir qué tiene adentro. Y typedef le da otro nombre a un tipo, para escribir
Tally en lugar de struct tally. typedef lo veremos con calma la próxima semana. Hoy basta con
esa lectura. Los campos aparecen recién en el .c, y nadie más los ve. Eso es un
tipo opaco (opaque type): un tipo declarado en el encabezado cuyos campos solo conoce su .c.
¿Qué se puede hacer con él afuera? Lean este programa, errors/peek_tally.c, que quiere saber más de
lo que dice el encabezado:
Tally local;
Tally *tally = tally_new();
printf("%d\n", tally->count);
printf("%zu\n", sizeof(Tally));
tally_free(tally);
$ gcc -Wall -Wextra -std=c17 -Itally -c errors/peek_tally.c
errors/peek_tally.c: In function ‘main’:
errors/peek_tally.c:7:11: error: storage size of ‘local’ isn’t known
7 | Tally local;
| ^~~~~
errors/peek_tally.c:9:25: error: invalid use of incomplete typedef ‘Tally’ {aka ‘struct tally’}
9 | printf("%d\n", tally->count);
| ^~
errors/peek_tally.c:10:28: error: invalid application of ‘sizeof’ to incomplete type ‘Tally’ {aka ‘struct tally’}
10 | printf("%zu\n", sizeof(Tally));
| ^~~~~
errors/peek_tally.c:7:11: warning: unused variable ‘local’ [-Wunused-variable]
7 | Tally local;
| ^~~~~La opción -Itally le dice a gcc que busque encabezados también en esa carpeta. Y fíjense que la
línea 8, Tally *tally = tally_new();, no da error. La razón está en lo que
el compilador necesita saber para cada cosa:
| Código | Qué necesita saber el compilador | ¿Lo sabe? |
|---|---|---|
Tally local; |
Cuántos bytes reservar en el marco | No: no conoce los campos |
sizeof(Tally) |
Lo mismo | No |
tally->count |
En qué parte del struct está ese campo |
No |
Tally *tally; |
Cuántos bytes ocupa un puntero | Sí: todos los punteros a struct tienen el mismo tamaño |
tally_add(tally, 3) |
El prototipo, y copiar el puntero y el int |
Sí |
Idea clave. Quien usa un tipo opaco solo puede tener punteros a él, y solo puede hacer lo que permiten las funciones del módulo. Ya no es una regla de buena conducta: lo impone el compilador.
Esto tiene un costo, y conviene decirlo. Como nadie afuera puede reservar un Tally, el módulo debe
crearlo con malloc y entregar un puntero. Y por eso hace falta tally_free: quien llamó a
tally_new es el owner, como en la semana 5.
Dos implementaciones de una interfaz
Ahora aprovechémoslo. tally_array.c guarda todos los valores en un arreglo que crece, y hace las
cuentas cuando se las piden:
struct tally {
    int *values;
    int count;
    int capacity;
};
tally_summary.c no guarda ningún valor. Lleva solo el resumen, y lo actualiza con cada valor nuevo:
struct tally {
    int count;
    int sum;
    int max;
};
Son representaciones muy distintas: una usa dos bloques de memoria y otra uno, y una recuerda los
valores y la otra no. Ambas cumplen tally.h. Quien use el módulo no puede notar la diferencia, y
eso se puede comprobar: la prueba es test_tally.c, que solo incluye tally.h.
static void test_some_values(void) {
    Tally *tally = tally_new();
    assert(tally != NULL);
    assert(tally_add(tally, 3));
    assert(tally_add(tally, 9));
    assert(tally_add(tally, 4));
    assert(tally_count(tally) == 3);
    assert(tally_sum(tally) == 16);
    assert(tally_max(tally) == 9);
    tally_free(tally);
}
Miren lo que hace el Makefile. La prueba se compila una vez, y su objeto se enlaza dos, una
vez con cada implementación:
$(BUILD)/test_array: $(BUILD)/test_tally.o $(BUILD)/tally_array.o
	$(CC) $^ -o $@

$(BUILD)/test_summary: $(BUILD)/test_tally.o $(BUILD)/tally_summary.o
	$(CC) $^ -o $@
$ cd tally
$ make clean
rm -rf build
$ make
mkdir -p build
gcc -Wall -Wextra -std=c17 -c test_tally.c -o build/test_tally.o
gcc -Wall -Wextra -std=c17 -c tally_array.c -o build/tally_array.o
gcc build/test_tally.o build/tally_array.o -o build/test_array
gcc -Wall -Wextra -std=c17 -c tally_summary.c -o build/tally_summary.o
gcc build/test_tally.o build/tally_summary.o -o build/test_summary
$ build/test_array
Todas las pruebas pasaron
$ build/test_summary
Todas las pruebas pasarontest_tally.c aparece una sola vez en esa salida. El mismo código máquina de la prueba corrió contra
las dos implementaciones.
Y ahora, compárenlo con stale. Allá, cambiar un struct obligaba a recompilar a todos los que
incluían el encabezado. Aquí el struct está en el .c. Si cambian los campos de tally_summary.c,
solo se
recompila ese archivo:
$ cd tally
$ touch tally_summary.c
$ make
gcc -Wall -Wextra -std=c17 -c tally_summary.c -o build/tally_summary.o
gcc build/test_tally.o build/tally_summary.o -o build/test_summary
Por eso el error de stale no le puede pasar a quien usa un tipo opaco: nadie afuera conoce el plano
de la memoria.
Elegir una interfaz es elegir qué se podrá cambiar
La interfaz también limita. Supongan que piden tally_median, la mediana. tally_array.c tiene todos
los valores y la puede calcular. tally_summary.c no puede, porque ya los olvidó. Si agregan esa
función al
encabezado, acaban de prohibir para siempre la segunda representación. Por eso se agrega a una
interfaz con más cuidado que a una implementación.
Pruebas por la interfaz
Una prueba por la interfaz solo usa lo que el encabezado promete. Tiene dos ventajas que ya vieron en acción: sobrevive a cualquier cambio de implementación, y sirve para comprobar que dos implementaciones cumplen lo mismo. Con un tipo opaco, además, no hay otra forma de escribirla: el compilador no deja mirar los campos.
Eso obliga a pensar qué se prueba. test_negative_values, en test_tally.c, existe porque un error
probable en tally_summary.c es empezar max en 0. Con valores negativos, ese máximo saldría mal.
Elegir casos
sigue siendo igual que en las semanas 1 y 2: lo que importa son los bordes. test_two_at_once
comprueba que dos acumuladores no se mezclan. Se escribió pensando en quien guarde su estado en una
variable static, y la
prueba no necesita saber si alguien lo hizo.
Se acabó #include "algo.c"
En la semana 2 les pedimos tomar esto como receta:
#define main trips_main
#include "trips.c"
#undef main
Ahora ya pueden ver qué hacía y por qué no conviene. Incluir un .c copia su texto en el archivo de
pruebas, así que la prueba se compila con todo lo que ese archivo tiene, incluso sus funciones
static. Y como también
copia su main, hacía falta cambiarle el nombre. La prueba quedaba pegada a la implementación, y nada
comprobaba que cumpliera la interfaz. Era lo que se podía hacer cuando todo estaba en un solo archivo.
Desde esta semana, las pruebas ya no hacen #include de un .c. Una prueba incluye el
encabezado, se compila aparte y se enlaza con los objetos del módulo. ¿Y el main que estorbaba? Se
saca a un archivo propio, muy
corto, y lo demás pasa a un módulo. receipt.c es así, y es lo que van a hacer en la primera parte
del laboratorio. Un main tan corto casi no necesita pruebas, y todo lo demás ya se puede probar.
Bloques enlazados
La sesión 2 del laboratorio les pide dos implementaciones de una pila (stack): valores que entran
y salen por el mismo extremo, de modo que el último en entrar es el primero en salir. Es la misma idea
de la pila de marcos de la semana 3,
pero con enteros. Su interfaz es pequeña, y ya viene dada en lab/stack/stack.h:
typedef struct stack Stack;Con esa línea y seis funciones basta: stack_new, stack_free, stack_push, stack_pop,
stack_peek y stack_size. Lo que nos interesa de esta pila no es la pila. Es que sirve para
comprobar, una vez más, que una interfaz esconde la representación. Comparar con cuidado
representaciones como estas le toca al curso siguiente.
La primera representación ya la conocen: un arreglo que crece con realloc, de la semana 5. La
segunda es nueva. En lugar de un solo bloque de memoria que se agranda, usa muchos bloques pequeños, y
cada uno recuerda dónde está el siguiente. Esta es la definición, en lab/stack/stack_blocks.c:
#define BLOCK_SIZE 4

struct block {
    int values[BLOCK_SIZE];
    int used;
    struct block *next;
};

struct stack {
    struct block *top;
    int size;
};
Miren el campo next: dentro de struct block hay un puntero a struct block. No es un struct
dentro de sí mismo, lo que sería imposible. Se puede por la misma razón de los tipos opacos: para
reservar un puntero, el compilador no necesita conocer lo que hay al otro lado.
Sigámoslo a mano. Con los valores 1, 2, 3, 4 y 5, en ese orden, cada stack_push escribe en el bloque
de arriba. Cuando ya está lleno, primero crea uno nuevo y lo pone encima:
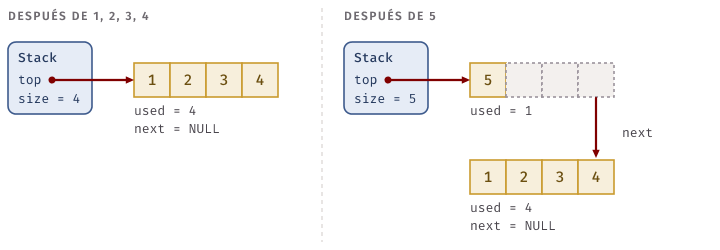
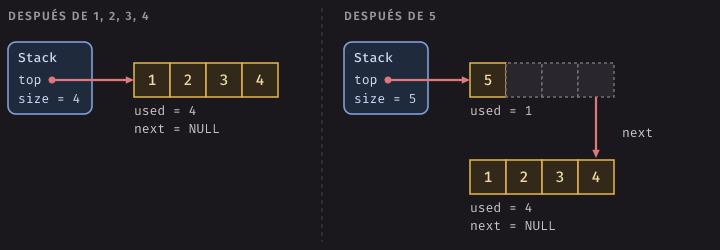
Sacar es lo contrario. stack_pop lee el último valor usado del bloque de arriba. Si ese bloque queda
vacío, se libera, y top pasa al de abajo. Así top nunca apunta a un bloque vacío, y stack_peek
solo tiene que mirar ahí. Y para liberar la pila entera hay que recorrer
los bloques uno por uno. Guarden next antes de liberar cada bloque: después de free, leer ese
campo es usar memoria liberada, y ASan lo reporta.
Error común. Probar solo con pocos valores. Con menos de 5, nunca se crea el segundo bloque, y la mitad del código no corre. Por eso
test_up_and_down, enlab/stack/test_stack.c, sube y baja varias veces cruzando los límites entre bloques en los dos sentidos.
El módulo de imágenes, ahora opaco
En la semana 3, struct image estaba en el encabezado, y la semana 5 cambió su arreglo por int *pixels. Cada uno de esos cambios obligó a tocar todos los filtros, porque miraban los campos. La
sesión 2 termina con ese problema, y deja este tipo en el encabezado:
typedef struct image Image;Los filtros ya no podrán escribir img->pixels[y * img->width + x], sino que le pedirán el píxel al
módulo con image_get(img, x, y), y lo cambiarán con image_set(img, x, y, value). Las funciones
como image_width, que solo devuelven un campo, se llaman de acceso (accessors). Esta es la
interfaz que tendrá:
| Función | Qué hace |
|---|---|
image_new(width, height, max_value, value) |
Crea una imagen con todos sus píxeles en value. Devuelve NULL si algún dato está mal |
image_load(name) |
Lee un archivo PGM. Devuelve NULL si falla |
image_free(img) |
Libera la imagen. Acepta NULL |
image_save(img, name) |
Escribe la imagen. Devuelve 1 si pudo y 0 si no |
image_width(img), image_height(img), image_max_value(img) |
Devuelven esos datos |
image_get(img, x, y) |
Devuelve el píxel. Exige que x e y estén dentro de la imagen |
image_set(img, x, y, value) |
Cambia el píxel. Exige además que value esté entre 0 y el valor máximo |
Tres cosas para pensar mientras la hacen:
- Hay que decidir qué se muestra.
invertnecesita el valor máximo, así queimage_max_valuedebe estar en la interfaz. Con elstructa la vista esa decisión ni existía. Un tipo opaco los obliga a tomarla. - Las funciones de acceso son un lugar donde revisar. Con píxeles en una sola fila larga,
xigual awidthno se sale del bloque: cae en la fila siguiente, y ni ASan lo nota. Dentro deimage_getse puede comprobar conassertlo que la función exige, y ese error se vería de inmediato. - Tiene un costo. Cada píxel ahora es una llamada a función, en lugar de un acceso directo. A cambio, la representación ya se puede cambiar sin tocar los filtros.
El laboratorio, paso a paso
Los archivos de partida están en code/week-06/lab, y su README.md tiene lo que pide cada parte,
los nombres exactos de los archivos y lo que puede quedar para antes de la siguiente sesión. make test-lab comprueba las cuatro partes, y falla hasta que terminen. Aquí están
las ideas, no el código.
Sesión 1: dividir y ocultar
lab/split. market.c funciona, y todo está en un solo archivo. Léanlo como aprendieron en la
semana 2: primero qué llama a qué. La pregunta que decide la división es quién escribe en la terminal
y quién no. Después sepárenlo en sales, report y main. Háganlo por pasos, y
compilen en cada uno: los mensajes de esta semana les dirán qué falta. Noten que report.h necesitará
a struct sale, y que main.c usa los dos módulos: es la misma forma de errors/no_guard, y por eso
la guarda importa de verdad. Escriban el Makefile con receipt/Makefile
al lado, y compruébenlo con touch. Las pruebas hacen justo eso.
lab/fraction. El tipo opaco se escribe por primera vez. Cuiden en fraction_new el signo y el
0: 2 / -4 queda como -1 / 2, y 0 / 5 queda como 0 / 1. Las pruebas de ustedes deben liberar cada
fracción que creen, también los resultados intermedios, o ASan avisará de una fuga.
Sesión 2: la misma interfaz, otra representación
lab/stack. Empiecen por el arreglo, que es casi lo que hicieron en la semana 5. Con los bloques,
dibujen primero. Corran test_stack después de cada función que terminen: si stack_push no
funciona, las demás no se pueden probar.
lab/image. Mover el struct al .c y compilar es el paso más instructivo de la semana. Los
errores son la lista de todo lo que dependía de la representación. Cuando esa lista esté vacía, ya
terminaron.
El código de la semana y make test
| Carpeta o archivo | Qué es |
|---|---|
receipt/ |
El ticket: tres módulos, un main y un Makefile con todas sus dependencias |
tally/ |
El tipo opaco, con dos implementaciones y una prueba |
stale/ |
Un Makefile mal hecho a propósito |
errors/ |
Los errores de este capítulo |
lab/ |
El laboratorio: split, fraction, stack e image |
test_examples.py, test_notes.py, test_lab.py |
Las pruebas de la semana, en Python, que solo las ejecuta |
make test compila los ejemplos y comprueba tres cosas: que los ejemplos escriben lo que dice este
capítulo, que cada error a propósito da su mensaje, y que los comandos de los bloques de terminal
siguen dando esa salida. También compila tally con sanitizers, para comprobar que no quedan
fugas. make test-lab revisa su trabajo. Cada prueba copia la parte a una carpeta temporal, compila
un main propio con su código y compara el resultado. Comprueba también lo que no se ve en la salida:
que el tipo sea opaco de verdad, y que tocar un .h recompile lo que debe.
Resumen
- Abstracción es usar algo sabiendo qué hace, sin saber cómo. Un módulo separa su interfaz, en
el
.h, de su implementación, en el.c. gcc -ccompila cada.cpor separado a un archivo objeto. El enlazador junta los objetos, y resuelve cada nombre usado con su definición.nmmuestra esos nombres.#includecopia texto. El compilador ve un solo texto por cada.c, y solo el enlazador ve todos los objetos.- Sin prototipo:
implicit declaration, del compilador. Falta enlazar un archivo:undefined reference. La misma función en dos.c, o un cuerpo en un.h:multiple definition, del enlazador. - Cada
.cincluye su propio encabezado, para que el compilador compare la promesa con el cuerpo. El enlazador no compara tipos. - Una guarda de inclusión evita repetir un encabezado dentro de un mismo
.c. No arregla unmultiple definition. staticdelante de una función la hace privada del archivo. Toda función que no esté en el encabezado llevastatic.- Una regla de
maketiene objetivo, dependencias y receta, y esta empieza con un tabulador. Si cambia un.c, se recompila ese. Si cambia un.h, se recompila todo.cque lo incluya, directa o indirectamente. En los dos casos se vuelve a enlazar. - Una dependencia que falta en el
Makefilepuede producir un programa que compila sin advertencias y hace algo imposible.make cleanlo descubre, ygcc -MMda la lista correcta. - El encabezado dice qué promete cada función, qué exige y quién es owner de la memoria.
- Un tipo opaco se declara en el
.hcontypedef struct x X;, y sus campos están en el.c. Afuera solo se pueden tener punteros, porque el compilador no conoce su tamaño. - Una prueba por la interfaz solo usa el encabezado. Su objeto se puede enlazar con cualquier
implementación. Desde esta semana, ninguna prueba hace
#includede un.c.
Ejercicios
Todo programa revisa sus lecturas y sus malloc, compila sin advertencias y termina sin fugas. Antes
de ejecutar cada comando, digan qué creen que va a pasar.
-
Sin compilar, digan si cada caso da error del compilador, error del enlazador o ningún error. Luego compruébenlo.
a) Un .c llama a una función sin haber incluido su encabezado. b) Dos .c definen una función static con el mismo nombre. c) Dos .c definen una función con el mismo nombre, sin static. d) Un .c incluye dos veces un encabezado con guarda. e) Un encabezado tiene el prototipo de una función, y nadie la define, ni nadie la llama. f) Igual que e), pero alguien la llama. -
Sin correrlo, digan qué archivos recompila
makeenreceiptsi hacentouch ticket.h. Compruébenlo. Luego contesten: ¿por quéitem.cnunca se recompila cuando cambiaticket.h, y sí se recompilaticket.ccuando cambiaitem.h? -
Corran
nmsobrereceipt/build/ticket.o. ¿Cuáles nombres ofrece, cuáles usa y cuál es privado? ¿Por qué apareceputchar, siticket.cno la escribe en ningún lado? Revisen lo que vieron en la semana 1 sobreprintfyputs. -
Quiten la guarda de
item.h, en una copia dereceipt. ¿Qué error da, y al compilar cuál archivo? ¿Cuáles de los cuatro.csiguen compilando, y por qué? -
Escriban un módulo
temperature, contemperature.hytemperature.c, que convierta entre grados Celsius y Fahrenheit, con su prueba en otro archivo y suMakefile. La función que hace la cuenta común debe ser privada. Comprueben connmque lo es. -
Agreguen al
Makefiledestalelas dependencias que le faltan, y repitan la sesión de esa sección. ¿Qué dice ahoramakedespués delcp? ¿Cambió lo que escribe el programa? -
Agreguen a
Tallyuna funcióntally_min, en el encabezado, en las dos implementaciones y en las pruebas. ¿Cuántos archivos tuvieron que cambiar? ¿Cuántos habrían cambiado si solo arreglaran un bug dentro detally_summary.c? -
Escriban una tercera implementación de
Tally,tally_blocks.c, que guarde los valores en bloques enlazados. Agréguenla alMakefilesin tocartest_tally.c. ¿Cuántas veces se compilatest_tally.cen unmakedesde cero? -
Escriban una implementación de
Tallyque guarde su estado en variablesstaticfuera de las funciones, sinmalloc. Esto rompe la regla del curso de no usar globales, y por eso es un ejercicio. ¿Cuál prueba detest_tally.cla descubre? Escriban en el encabezado la frase que haría falta para que esa implementación cumpliera la interfaz, y digan por qué es una mala promesa. -
¿Por qué
sizeof(*tally)sí compila dentro detally_array.c, ysizeof(Tally)no compila enerrors/peek_tally.c, si los dos incluyen el mismo encabezado? Respondan pensando en el texto que ve el compilador en cada caso. -
Escriban un programa con
int *pixels = malloc(width * height * sizeof(int));, y leanpixels[y * width + x]conxigual awidth. ¿Qué dice ASan siyno es la última fila? ¿Y si es la última? Después de terminar el laboratorio, agreguen en suimage_getunassertcon lo que la función exige, y repitan la prueba con ella. -
Cambien la representación de su
Image, para que cada fila sea un bloque propio, con un arreglo de punteros a las filas. Sin tocarfilters.cnitest_image.c, todo debe seguir pasando. ¿Qué archivos cambiaron? ¿Cuántosmallochace ahoraimage_new, y en qué orden debe liberarlosimage_free? Compárenlo con lo que habría costado este cambio en la semana 3.