Apuntes · Capítulo 7Memoria y abstracción
Tipos
Tipos
Las últimas tres semanas fueron sobre dónde viven los datos. Con los punteros aprendimos a llegar a un dato de otro marco. Con la memoria dinámica, a pedir el espacio que haga falta y a decidir quién es su owner. Con los módulos, a esconder la representación detrás de una interfaz. Hoy hacemos otra pregunta: ¿qué es un dato?
Un int que vale 2 puede ser una nota, un número de pasajeros o el estado “terminado” de un viaje. El
compilador no ve ninguna diferencia, así que tampoco puede avisarnos cuando los confundimos. Elegir bien un
tipo es la forma más barata de evitar un bug: lo que el tipo no permite escribir, no hay que probarlo.
Veremos cuatro herramientas de C para decir qué es un dato: typedef, enum, union y la unión
etiquetada (tagged union), que representa un valor que puede tener varias formas. En el laboratorio
construirán con ella una tabla cuyas celdas pueden ser un entero, un decimal, una cadena o nada. La misma
idea volverá en la semana 13, porque un nodo de un árbol de expresión es justamente eso.
La segunda parte del capítulo es sobre lo que C no revisa: las conversiones que hace solo y el comportamiento indefinido. Ahí aprenderán por qué la frase “a mí me funcionó” no prueba nada.
Ruta de lectura.
- Antes de clase (15 a 20 minutos, obligatoria): la introducción, Un tipo dice qué existe y qué se puede hacer,
typedef: otro nombre, no otro tipo yunion: varios tipos en el mismo lugar.- En clase:
enum: valores con nombre, La unión etiquetada, Una variante que posee memoria y Comportamiento indefinido. Conversiones (✂️) entra si alcanza el tiempo.- Después de clase: El laboratorio, paso a paso. Luego el Resumen y los Ejercicios. Si Conversiones no se vio en clase, queda como lectura. Para ir más allá: los últimos ejercicios del capítulo.
Código. Los programas de este capítulo están en
code/week-07. Dentro del entorno del curso, entren a esa carpeta y corranmakepara compilar los ejemplos ymake testpara comprobarlos. Los comandos de este capítulo se corren desde ahí. Los programas deerrors/tienen errores a propósito y se compilan a mano, como se muestra en cada caso.
Un tipo dice qué existe y qué se puede hacer
Un tipo responde dos preguntas: qué valores existen y qué operaciones tienen sentido. Para int,
los valores son los enteros de cierto rango, y se pueden sumar. Para un estado de viaje, los valores son
tres, “esperando”, “en ruta” y “terminado”, y sumarlos no significa nada.
Si guardamos un estado en un int, el programa puede contener cosas que no significan nada: el estado 7, o
el estado 1 más el estado 2. Son estados inválidos: el tipo los permite, aunque el problema no. Cada uno
obliga a escribir una revisión, o a confiar en que nunca ocurra.
Por eso la pregunta de diseño de esta semana es:
Idea clave. Antes de escribir un tipo, pregúntense qué valores no deberían existir. Mientras menos valores inválidos se puedan representar, menos casos hay que revisar y menos pruebas hay que escribir.
C no nos deja llegar muy lejos con esa idea, como veremos. Pero incluso lo poco que permite cambia mucho un programa.
typedef: otro nombre, no otro tipo
typedef le da un nombre nuevo a un tipo que ya existe. Lo usaron en la semana 6, con typedef struct image Image;. También sirve para decir qué significa un número. En typedef_units.c:
typedef int Meters;
typedef int Seconds;

double speed(Meters distance, Seconds time) {
    return (double) distance / time;
}
La firma de speed ahora se explica sola, y eso ya vale. Pero veamos qué pasa si alguien pasa los
argumentos al revés:
printf("bien: %.2f m/s\n", speed(distance, time));
printf("al revés: %.2f m/s\n", speed(time, distance));
$ build/typedef_units
bien: 20.00 m/s
al revés: 0.05 m/sEl programa compila sin ninguna advertencia. Para el compilador, Meters, Seconds e int son el mismo
tipo, con tres nombres. typedef documenta, pero no protege.
Si de verdad queremos que el compilador los distinga, necesitamos tipos distintos, y en C eso se consigue
con un struct. Dos struct son tipos diferentes aunque tengan los mismos campos. En
errors/struct_units.c:
typedef struct { int value; } Meters;
typedef struct { int value; } Seconds;
$ gcc -Wall -Wextra -std=c17 errors/struct_units.c -o build/struct_units
errors/struct_units.c: In function 'main':
errors/struct_units.c:15:28: error: incompatible type for argument 1 of 'speed'
15 | printf("%.2f\n", speed(time, distance));
| ^~~~
| |
| Seconds
errors/struct_units.c:7:21: note: expected 'Meters' but argument is of type 'Seconds'
7 | double speed(Meters distance, Seconds time) {
| ~~~~~~~^~~~~~~~Ahora el error es de compilación. El precio es escribir distance.value en todas partes y perder la suma
directa. Pocas veces vale la pena para unos metros, pero conviene saber que esa puerta existe.
Error común. Creer que
typedefcrea un tipo nuevo y por eso “el compilador me va a avisar”. No lo hará.typedefes un nombre más para el mismo tipo.
enum: valores con nombre
Un viaje puede estar esperando, en ruta o terminado. La primera solución que uno escribe usa números con
nombre, en trip_defines.c:
#define TRIP_WAITING 0
#define TRIP_ON_ROUTE 1
#define TRIP_FINISHED 2
const char *state_name(int state) {
if (state == TRIP_WAITING) {
return "esperando";
}
if (state == TRIP_ON_ROUTE) {
return "en ruta";
}
return "terminado";
}$ build/trip_defines
1: en ruta
7: terminadoEs mucho mejor que escribir 0, 1 y 2 sueltos, que se conocen como números mágicos: números cuyo
significado no se puede saber leyéndolos. Pero hay un problema, visible en la segunda línea. El estado 7 no
existe, y la función dijo “terminado”, porque el tipo del parámetro es int y todo lo que no es 0 ni 1 cae
en el último caso. Además, #define solo reemplaza texto: el compilador nunca llega a ver un
TRIP_ON_ROUTE, solo ve un 1.
Un enum (enumeración) define un tipo con una lista de valores con nombre. En trip_enum.c:
enum trip_state { TRIP_WAITING, TRIP_ON_ROUTE, TRIP_FINISHED };const char *state_name(enum trip_state state) {
switch (state) {
case TRIP_WAITING:
return "esperando";
case TRIP_ON_ROUTE:
return "en ruta";
case TRIP_FINISHED:
return "terminado";
}
return "desconocido";
}$ build/trip_enum
esperando
en ruta
terminadoSe numeran solos desde 0. También se les puede dar un valor, y los siguientes continúan desde ahí. En
enum_values.c:
enum fare { FARE_STUDENT = 100, FARE_ADULT = 250, FARE_NIGHT };$ build/enum_values
0 1 2
100 250 251
sizeof(enum trip_state) = 4
state = 7
total = 252Las dos últimas líneas de esa salida son importantes, y volveremos a ellas en un momento.
Qué se gana frente a #define
Un gdb que habla. El depurador conoce los nombres, porque son parte del tipo. En trip_defines.c,
print state responde 1 y whatis state responde int, porque el nombre desapareció antes de compilar.
Miren lo que responde con el enum. También aquí recortamos la ruta de la línea Starting program y
quitamos las líneas de libthread_db. Las direcciones y los números de proceso dependen del entorno.
$ gcc -Wall -Wextra -std=c17 -g -O0 trip_enum.c -o build/trip_enum_gdb$ gdb -q build/trip_enum_gdb
Reading symbols from build/trip_enum_gdb...
(gdb) break state_name
Breakpoint 1 at 0x7b0: file trip_enum.c, line 7.
(gdb) run
Starting program: .../build/trip_enum_gdb
Breakpoint 1, state_name (state=TRIP_WAITING) at trip_enum.c:7
7 switch (state) {
(gdb) print state
$1 = TRIP_WAITING
(gdb) print/d state
$2 = 0
(gdb) whatis state
type = enum trip_state
(gdb) delete 1
(gdb) continue
Continuing.
esperando
en ruta
terminado
[Inferior 1 (process 133) exited normally]
(gdb) quitUn switch revisado. Supongamos que agregan un estado nuevo, TRIP_CANCELLED. Con #define, nadie les
dice en qué lugares del programa hay que atenderlo. Con un enum, -Wall revisa cada switch sobre ese
tipo:
$ gcc -Wall -Wextra -std=c17 errors/missing_case.c -o build/missing_case
errors/missing_case.c: In function 'state_name':
errors/missing_case.c:7:5: warning: enumeration value 'TRIP_CANCELLED' not handled in switch [-Wswitch]
    7 |     switch (state) {
      |     ^~~~~~
Esta advertencia es la razón principal para preferir un enum. En un programa de varios archivos, agregar
un caso se vuelve una tarea guiada: se compila, y gcc hace la lista de lugares por cambiar. Lo pueden
comprobar al final del laboratorio.
La advertencia desaparece si el switch tiene default. En errors/default_hides.c, con el mismo estado
sin atender, gcc no dice nada:
default:
    return "desconocido";
$ gcc -Wall -Wextra -std=c17 errors/default_hides.c -o build/default_hides
$ build/default_hides
desconocidoError común. Poner
defaultpor costumbre en unswitchsobre unenum. Le quita al compilador la lista de casos por revisar. Si atienden todas las etiquetas, no lo pongan.
Una mezcla detectada. Si se pasa un enum donde se espera otro, -Wextra lo avisa. En
errors/enum_mix.c:
void show(enum trip_state state, int passengers) {show(SEAT_AISLE, 20);
show(20, TRIP_ON_ROUTE);$ gcc -Wall -Wextra -std=c17 errors/enum_mix.c -o build/enum_mix
errors/enum_mix.c: In function 'main':
errors/enum_mix.c:12:10: warning: implicit conversion from 'enum seat' to 'enum trip_state' [-Wenum-conversion]
12 | show(SEAT_AISLE, 20);
| ^~~~~~~~~~
$ build/enum_mix
estado 1, 20 pasajeros
estado 20, 1 pasajerosFíjense bien: hay dos errores en main, y gcc avisa de uno. La segunda llamada pasa los
argumentos al revés, y no hubo ninguna advertencia. Es la limitación de la que hablamos a continuación.
Lo que un enum no garantiza
Por dentro, un enum de C es un entero. Las etiquetas son de tipo int, y un entero cualquiera se
convierte a un enum sin aviso, aunque no corresponda a ninguna etiqueta. Por eso compilan estas líneas de
enum_values.c, y por eso salieron state = 7 y total = 252 en la salida de arriba:
enum trip_state state = 7;int total = TRIP_FINISHED + FARE_ADULT;Y por eso state_name tiene un return después del switch, aunque atiende todas las etiquetas. Si lo
quitan, gcc lo reclama, y tiene razón: state podría valer 7, y la función llegaría al final sin retornar
nada.
$ gcc -Wall -Wextra -std=c17 errors/no_final_return.c -o build/no_final_return
errors/no_final_return.c: In function 'state_name':
errors/no_final_return.c:15:1: warning: control reaches end of non-void function [-Wreturn-type]
   15 | }
      | ^
Resumamos cuánto protege cada herramienta:
| Situación | #define con int |
typedef int |
enum |
struct con un campo |
|---|---|---|---|---|
Nombre en gdb |
No | No | Sí | Muestra el campo |
Avisa si falta un caso en switch |
No | No | Sí | No aplica |
| Avisa si se mezclan dos tipos así | No | No | Sí | Error |
Avisa si se usa un int en su lugar |
No | No | No | Error |
En C.
const intes otra opción que ya vieron, pero sirve para una constante suelta, no para una lista de valores relacionados. Usenenumsi los valores forman un conjunto y#defineoconstsi es un número suelto, como un tamaño máximo.
union: varios tipos en el mismo lugar
Una union se escribe como un struct, pero con una diferencia enorme: sus campos no van uno después
del otro, sino uno encima del otro. Todos empiezan en el mismo byte. En union_bytes.c:
struct both {
    int integer;
    double decimal;
};

union either {
    int integer;
    double decimal;
};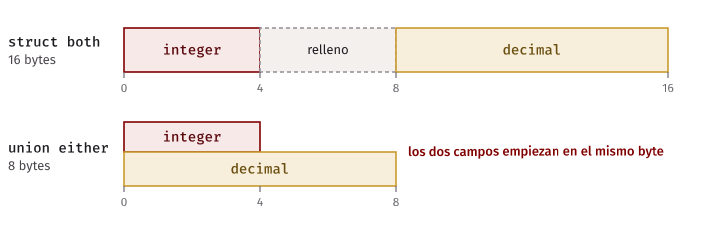
El struct tiene los dos datos a la vez. La union tiene espacio para uno, el más grande. En este
entorno, un int ocupa 4 bytes y un double 8, y el double debe empezar en un múltiplo de 8, así que el
struct deja 4 bytes de relleno (padding) sin usar. Esos tamaños dependen de la máquina. La regla no:
una union ocupa al menos lo que su campo más grande.
Escribir en un campo pisa a los demás:
union either u;
u.integer = 7;
printf("guardé un int: %d\n", u.integer);

u.decimal = 3.14;
printf("guardé un double: %.2f\n", u.decimal);
printf("leído como int: %d\n", u.integer);
$ build/union_bytes
sizeof(struct both) = 16
sizeof(union either) = 8
guardé un int: 7
guardé un double: 3.14
leído como int: 1374389535El 7 ya no existe. Y ese 1374389535 no es un error de memoria: son cuatro de los ocho bytes del double
3.14, leídos como si fueran un int. El número exacto depende de cómo la máquina guarda los bytes. Lo
importante es que no significa nada.
Una union no recuerda cuál fue el último campo que se escribió. Esa información no está en ninguna parte:
si la necesitamos, hay que guardarla nosotros.
La unión etiquetada
Queremos representar el pago de un pasaje, que puede ser en efectivo (cuántos soles recibió el cobrador), con tarjeta (sus últimos cuatro dígitos) o con una billetera del celular (el número). Un pago tiene una de esas formas.
La primera idea es un struct con todos los campos, como en payment_sizes.c:
struct loose_payment {
    int kind;
    double cash;
    int card_end;
    char *phone;
};
Funciona, y es lo que muchos programas hacen. Pero este tipo permite estados que el problema no tiene:
struct loose_payment bad = {0, 2.5, 4821, NULL};Este valor dice que el pago es en efectivo (kind 0, si es que alguien recuerda qué significa) y además
tiene una tarjeta. ¿Cuál vale? Quien lea el código no lo sabe, y el tipo no lo aclara. Cada función tendría
que decidir qué hacer con esa mezcla, y cada prueba tendría que considerarla.
Una unión etiquetada junta las tres herramientas de hoy: un enum dice cuál forma tiene el dato, una
union guarda el dato, y un struct mantiene los dos juntos. En payment.h:
typedef enum { PAY_CASH, PAY_CARD, PAY_WALLET } PaymentKind;

typedef struct {
    PaymentKind kind;
    union {
        double cash;   // PAY_CASH: soles recibidos
        int card_end;  // PAY_CARD: últimos cuatro dígitos
        char *phone;   // PAY_WALLET: número del celular; lo posee el Payment
    } as;
} Payment;
El campo kind es la etiqueta, y cada campo de la union es una variante. La variante activa
es la que la etiqueta indica. El nombre as es una costumbre que se lee bien: p.as.cash se lee “p, como
efectivo”.
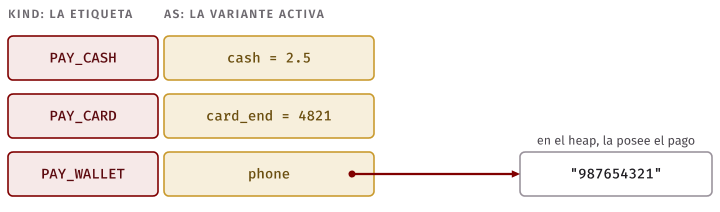
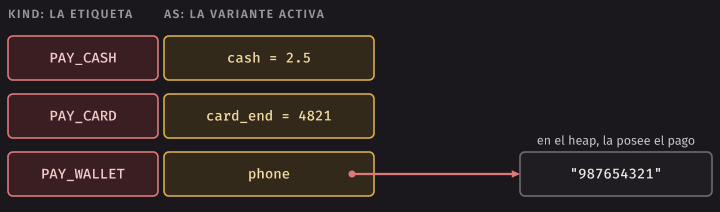
Ahora, la mezcla de arriba ya no se puede escribir: un pago tiene espacio para una sola variante. Y de paso, ocupa menos:
$ build/payment_sizes
sizeof(struct loose_payment) = 32
sizeof(Payment) = 16
kind = 0, cash = 2.50, card_end = 4821
Esos tamaños dependen del entorno. El ahorro no es la razón principal para usar una union: la razón
principal es que el tipo dice la verdad sobre el problema.
Las dos reglas de uso
La disciplina es simple, y es la misma en todos los programas que usen esta técnica.
Regla 1: se crea con un constructor. Un constructor es una función que devuelve un valor bien
formado, con la etiqueta y la variante de acuerdo. Así, esa concordancia se escribe en un solo lugar. En
payment.c:
Payment payment_cash(double soles) {
    Payment p;
    p.kind = PAY_CASH;
    p.as.cash = soles;
    return p;
}
Regla 2: se lee después de mirar la etiqueta. Lo natural es un switch, sin default, para que -Wall
revise que están todos los casos:
void payment_print(const Payment *p) {
    switch (p->kind) {
    case PAY_CASH:
        printf("efectivo: S/ %.2f\n", p->as.cash);
        break;
    case PAY_CARD:
        printf("tarjeta terminada en %04d\n", p->as.card_end);
        break;
    case PAY_WALLET:
        printf("billetera del %s\n", p->as.phone);
        break;
    }
}
Lo que se gana se ve en payment_demo.c: un solo arreglo, de un solo tipo, con pagos de formas distintas.
Esto no se podía escribir con un arreglo de int o de double.
Payment payments[PAYMENTS] = {
    payment_cash(2.5),
    payment_card(4821),
    payment_wallet("987654321"),
};
$ build/payment_demo
efectivo: S/ 2.50
tarjeta terminada en 4821
billetera del 987654321Esta es la forma de la union dentro de cada pago, según gdb. Compilen los dos archivos con -g -O0:
$ gcc -Wall -Wextra -std=c17 -g -O0 payment_demo.c payment.c -o build/payment_demo_gdb$ gdb -q build/payment_demo_gdb
Reading symbols from build/payment_demo_gdb...
(gdb) break payment_print
Breakpoint 1 at 0xa3c: file payment.c, line 35.
(gdb) run
Starting program: .../build/payment_demo_gdb
Breakpoint 1, payment_print (p=0xfffffffff9f8) at payment.c:35
35 switch (p->kind) {
(gdb) print *p
$1 = {kind = PAY_CASH, as = {cash = 2.5, card_end = 0,
phone = 0x4004000000000000 <error: Cannot access memory at address 0x4004000000000000>}}
(gdb) continue
Continuing.
efectivo: S/ 2.50
Breakpoint 1, payment_print (p=0xfffffffffa08) at payment.c:35
35 switch (p->kind) {
(gdb) print *p
$2 = {kind = PAY_CARD, as = {cash = 2.500000000002141, card_end = 4821,
phone = 0x40040000000012d5 <error: Cannot access memory at address 0x40040000000012d5>}}
(gdb) continue
Continuing.
tarjeta terminada en 4821
Breakpoint 1, payment_print (p=0xfffffffffa18) at payment.c:35
35 switch (p->kind) {
(gdb) print *p
$3 = {kind = PAY_WALLET, as = {cash = 9.2711410816661211e-310,
card_end = -1431563616, phone = 0xaaaaaaac12a0 "987654321"}}
(gdb) delete 1
(gdb) continue
Continuing.
billetera del 987654321
[Inferior 1 (process 151) exited normally]
(gdb) quitLean esto con calma, porque gdb no sabe de etiquetas: muestra las tres variantes siempre, aunque solo
una tenga sentido. En el primer pago, cash = 2.5 es correcto. Los otros dos son esos mismos bytes leídos
de otra forma, y el phone ni siquiera es una dirección válida. En el segundo pago, card_end = 4821 es
correcto, y lo que muestra como cash es lo que tocó en esa memoria: 4 bytes nuevos y 4 que ya estaban ahí.
Solo la etiqueta dice cuál mirar. Los números de las variantes inactivas dependen del entorno.
Leer la variante equivocada
¿Qué pasa si alguien no mira la etiqueta? En errors/wrong_variant.c, la etiqueta dice que hay una cadena,
y se lee un decimal:
v.kind = VALUE_TEXT;
v.as.text = "Callao";printf("v.as.number = %g\n", v.as.number);$ gcc -Wall -Wextra -std=c17 -g -fsanitize=address,undefined errors/wrong_variant.c -o build/wrong_variant
$ build/wrong_variant
texto: Callao
v.as.number = 9.27115e-310Ni gcc, ni ASan, ni UBSan dijeron nada. Lo que se imprime es la dirección de la cadena, leída como si sus
8 bytes fueran un double. Cambia de una corrida a otra, porque la dirección cambia, y no significa nada.
Conviene ser precisos, porque aquí es fácil decir algo falso. En C, leer de una union un campo distinto
del último que se escribió no es, por sí solo, comportamiento indefinido: el estándar dice que esos
bytes se interpretan según el tipo del campo leído. Es un bug, y por eso mismo es peligroso, porque ninguna
herramienta lo ve. Se vuelve comportamiento indefinido cuando esos bytes se usan como lo que no son. En
errors/wrong_text.c pasa al revés: la etiqueta dice decimal, y los bytes de 2.5 se usan como la dirección
de una cadena.
$ gcc -Wall -Wextra -std=c17 -g -fsanitize=address,undefined errors/wrong_text.c -o build/wrong_text
$ build/wrong_text
==141==ERROR: AddressSanitizer: SEGV on unknown address 0x4000000000000 (pc 0xffff9bc43b68 bp 0xffffe41cc3e0 sp 0xffffe41cc3e0 T0)
==141==The signal is caused by a READ memory access.
...
    #4 0xaaaad4c70c48 in main errors/wrong_text.c:19
Idea clave. La etiqueta es una promesa que ustedes deben cumplir. C no la revisa. Por eso se crea siempre con un constructor y se lee siempre con un
switch, y por eso ambas cosas van en un solo módulo.
Hasta dónde llega la protección
Dijimos que los estados inválidos ya no se pueden representar. Seamos honestos: es verdad a medias. La
mezcla efectivo-y-tarjeta desapareció, pero nada impide escribir p.kind = PAY_WALLET; sobre un pago en
efectivo.
Un tipo opaco, como los de la semana 6, cerraría esa puerta: nadie fuera del módulo podría tocar kind.
Pero en una unión etiquetada, quien la usa casi siempre quiere hacer su propio switch sobre las variantes,
y para eso necesita ver los campos. Por eso Payment y el Value del laboratorio no son opacos: es una
decisión a propósito, y no un olvido. Las dos opciones son razonables, y cada una deja algo a cargo de
alguien:
| Tipo opaco | Unión etiquetada visible | |
|---|---|---|
| ¿Quién garantiza que el dato está bien formado? | El módulo | La disciplina de quien lo usa |
| ¿Se puede cambiar la representación sin tocar a quien lo usa? | Sí | No |
| ¿Se puede agregar una operación nueva sin tocar el módulo? | No | Sí, con otro switch |
Una variante que posee memoria
PAY_WALLET guarda una dirección. ¿De quién es esa cadena? Lo aprendieron en la semana 5: todo bloque tiene
un owner, y la firma debe decir quién es. Aquí el owner es el pago. El constructor guarda una copia, de
modo que el pago no depende de quien lo llamó:
Payment payment_wallet(const char *phone) {
    char *copy = malloc(strlen(phone) + 1);
    if (copy == NULL) {
        return payment_cash(0.0);
    }
    strcpy(copy, phone);
Y hay una función que libera lo que el pago posee. Solo esa variante tiene algo que liberar, así que hay que
mirar la etiqueta. Al final, el pago queda convertido en otro válido y sin memoria, de modo que un segundo
payment_free sobre la misma variable no hace daño:
void payment_free(Payment *p) {
    if (p->kind == PAY_WALLET) {
        free(p->as.phone);
    }
    *p = payment_cash(0.0);
}
Error común. Liberar sin mirar la etiqueta. Un
free(p->as.phone)en un pago en efectivo le pasaría afreelos bytes de undoublecomo si fueran una dirección.
Ahora, la trampa. En la semana 3 vimos que asignar un struct copia todos sus campos. Eso sigue siendo
cierto, y por eso mismo copia la dirección de la cadena, no la cadena. En errors/shared_owner.c:
Payment first = payment_wallet("987654321");
Payment second = first;payment_free(&first);
payment_free(&second);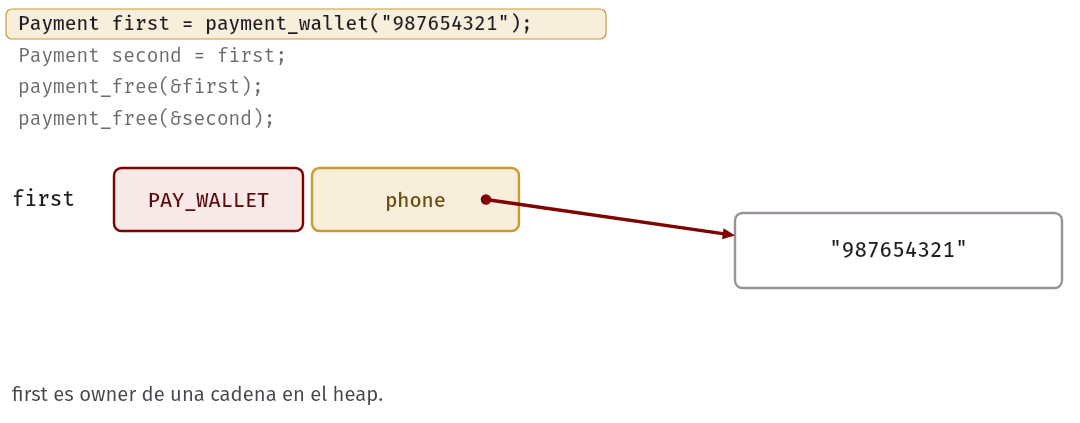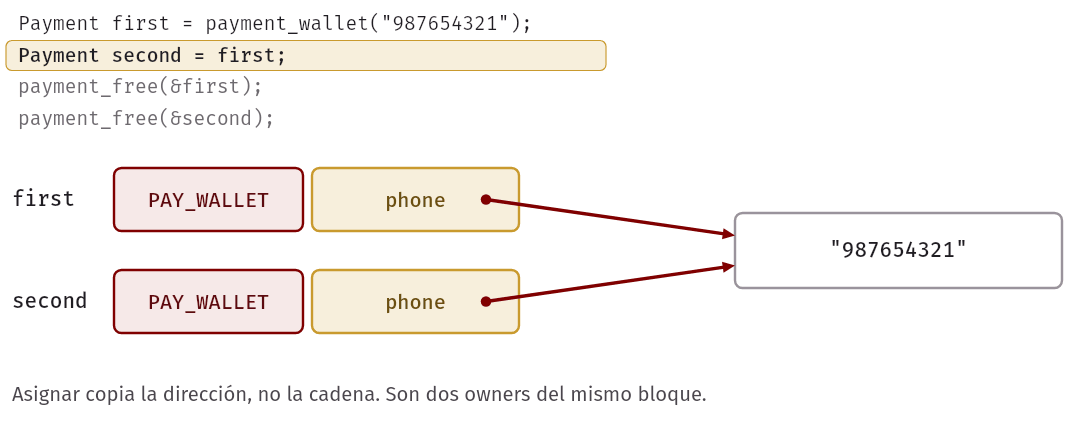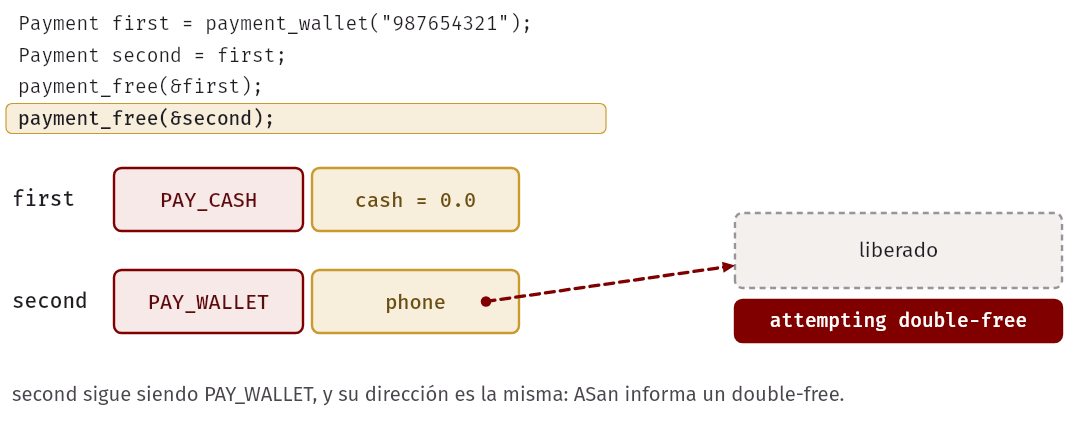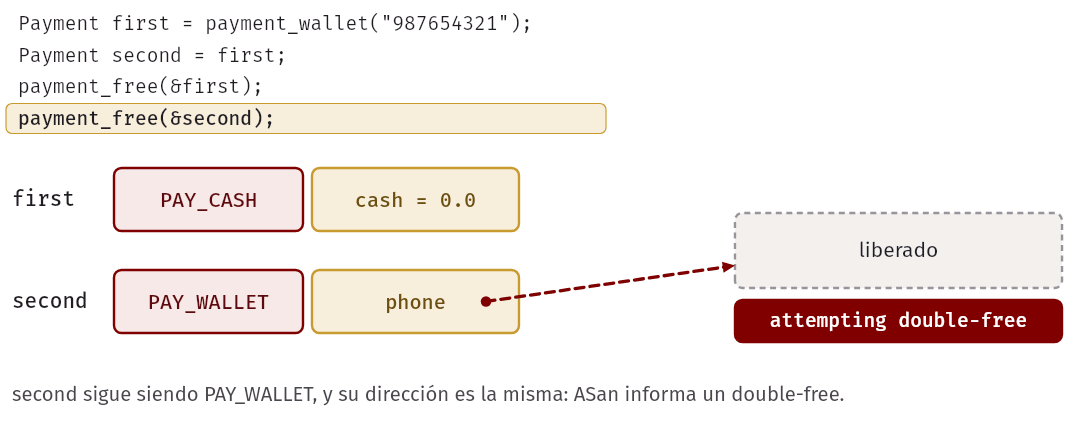
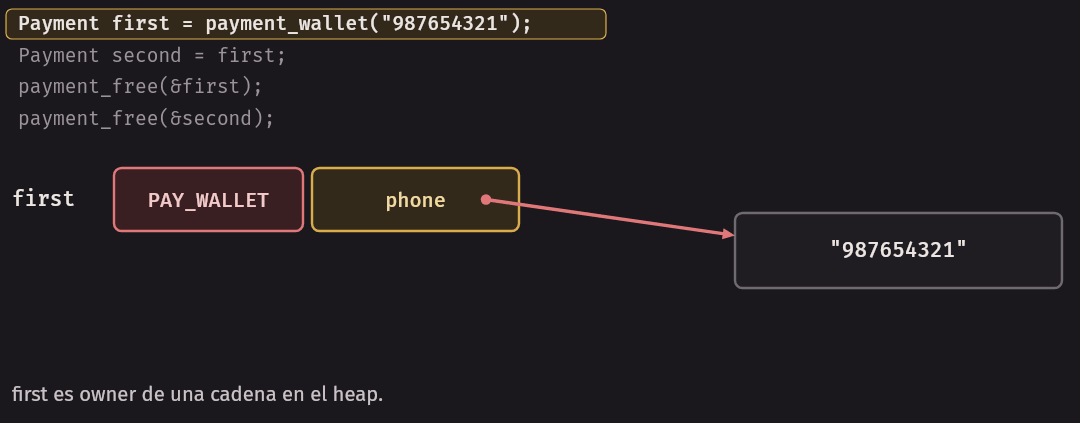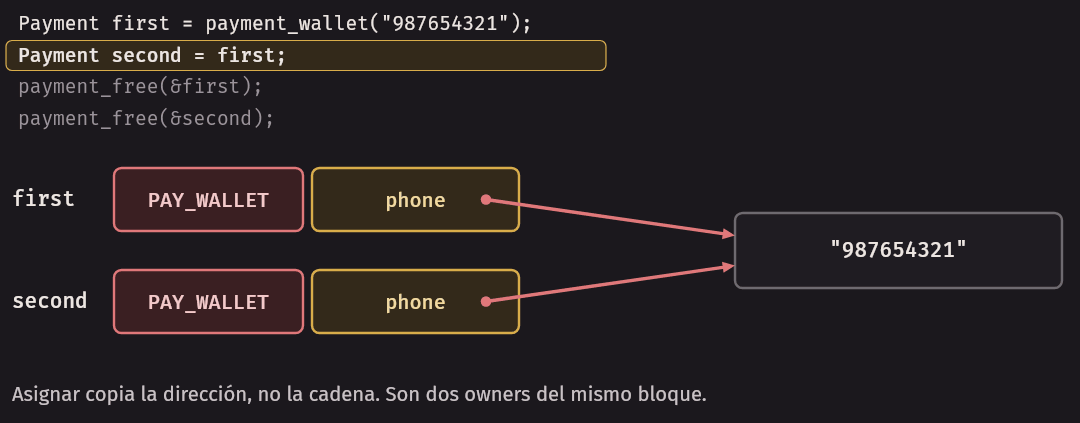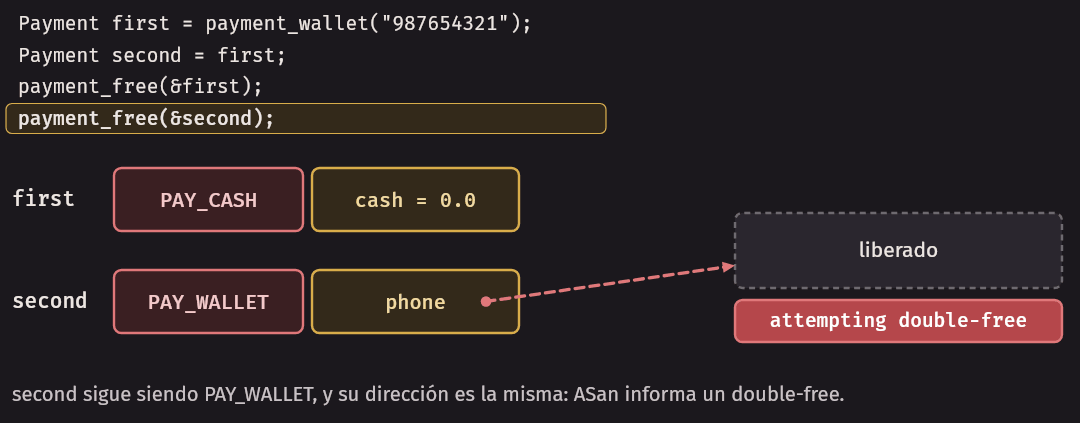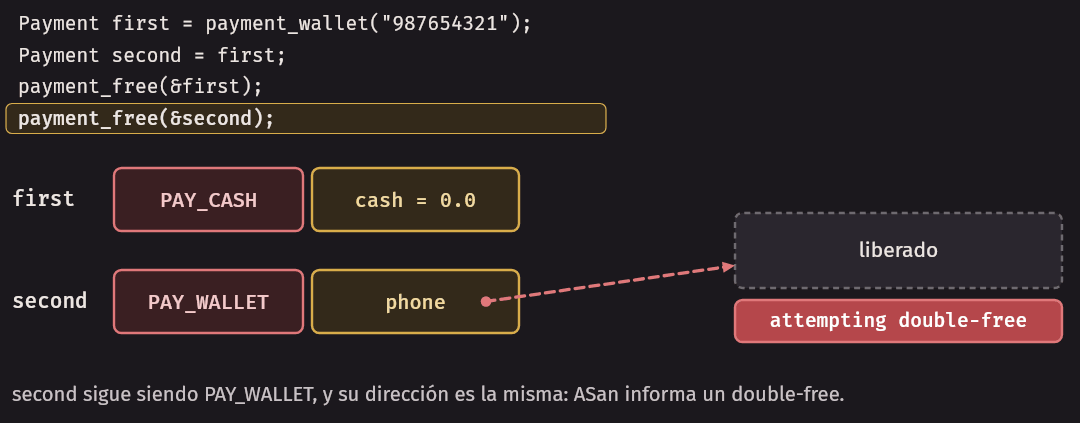
Son dos owners del mismo bloque. El primer payment_free lo libera y deja a first sin memoria, pero
second no se entera: su dirección sigue ahí.
$ gcc -Wall -Wextra -std=c17 -g -fsanitize=address,undefined -I. errors/shared_owner.c payment.c -o build/shared_owner
$ build/shared_owner
==156==ERROR: AddressSanitizer: attempting double-free on 0x502000000010 in thread T0:
...
    #2 0xaaaad3db18a4 in main errors/shared_owner.c:11
...
freed by thread T0 here:
...
    #2 0xaaaad3db189c in main errors/shared_owner.c:10
...
previously allocated by thread T0 here:
...
    #2 0xaaaad3db1860 in main errors/shared_owner.c:5
...
SUMMARY: AddressSanitizer: double-free ../../../../src/libsanitizer/asan/asan_malloc_linux.cpp:52 in free
El informe cuenta la historia completa, de abajo hacia arriba: se reservó en la línea 5, se liberó en la 10, y se intentó liberar otra vez en la 11. Noten que el programa escribió bien el pago antes de fallar: mientras nadie libere, compartir no se nota.
Hay dos políticas correctas, y un programa debe elegir y documentar:
- Mover: después de
second = first, el owner essecond, yfirstya no se usa ni se libera. Es la que usaremos en el laboratorio: cuando una celda de la tabla recibe lo que devolvióvalue_parse, la cadena pasa a ser de la celda. - Copiar de verdad: una función aparte, que reserve memoria nueva para la cadena. Nadie comparte nada,
pero cuesta memoria y un
mallocmás.
Idea clave. Una unión etiquetada con memoria adentro es un
structque no se puede asignar sin pensar. La regla de quién es owner va escrita en el encabezado. Lean el comentario inicial delab/value.h.
Conversiones
C convierte tipos por su cuenta, sin decir nada. Ya vieron en Introducción a la Computación las conversiones
entre int y double, los enteros sin signo, y size_t, incluido por qué strlen(s) - 1 da la vuelta con
una cadena vacía. Hoy juntamos eso en unas pocas reglas y les ponemos nombre.
Esta sección se puede estudiar aparte: nada de la unión etiquetada depende de ella.
Empecemos con la pregunta de la semana. ¿Qué escribe este programa? Decidan antes de seguir leyendo.
if (-1 < 1u) {
    puts("menor");
} else {
    puts("mayor");
}
$ gcc -Wall -Wextra -std=c17 errors/minus_one.c -o build/minus_one
errors/minus_one.c: In function 'main':
errors/minus_one.c:5:12: warning: comparison of integer expressions of different signedness: 'int' and 'unsigned int' [-Wsign-compare]
5 | if (-1 < 1u) {
| ^
$ build/minus_one
mayorEscribe mayor. La u hace que 1u sea un unsigned int. Antes de comparar, los dos operandos deben
tener el mismo tipo, y la regla elige unsigned int, aunque ahí no quepa un -1. Entonces el -1 se
convierte. Como vieron con (unsigned int) x, convertir a un tipo sin signo suma 2^32 hasta que el valor
cabe: -1 pasa a ser 4294967295. La comparación que de verdad se hace es 4294967295 < 1, y es falsa.
Las reglas
Cuando una operación mezcla tipos, C aplica estas reglas, de arriba hacia abajo. Son las conversiones aritméticas habituales, y las versiones siguientes bastan para este curso:
| Si los operandos son | Se convierten a | Ejemplo |
|---|---|---|
Algún double |
double |
7 / 2.0 es 3.5 |
Más chicos que int (char, unsigned char) |
int, siempre, aunque los dos sean iguales |
a + b en promotion.c |
int y unsigned int |
unsigned int |
-1 < 1u |
int y size_t |
size_t |
position < strlen(word) |
Y en una asignación, en un parámetro o en un return, el valor se convierte al tipo de destino, aunque no
quepa.
El mismo -1 cambia de valor según el tipo sin signo al que llegue:
printf("como unsigned int: %u\n", (unsigned int) negative);
printf("como size_t: %zu\n", (size_t) negative);
printf("con cast a int: %d\n", negative < (int) strlen("hola"));
$ build/sign_rule
como unsigned int: 4294967295
como size_t: 18446744073709551615
con cast a int: 1Ese segundo número depende del tamaño de size_t, que aquí es de 8 bytes.
Con signo y sin signo: size_t
El caso de la pregunta se ve artificial, porque nadie escribe -1 < 1u. Pero sí escribimos esto, en
errors/size_compare.c:
const char *word = "hola";
int position = -1;

if (position < strlen(word)) {
$ gcc -Wall -Wextra -std=c17 errors/size_compare.c -o build/size_compare
errors/size_compare.c: In function 'main':
errors/size_compare.c:9:18: warning: comparison of integer expressions of different signedness: 'int' and 'size_t' {aka 'long unsigned int'} [-Wsign-compare]
9 | if (position < strlen(word)) {
| ^
$ build/size_compare
la posición está después del finalUna posición -1 “está después del final” de una cadena de 4 letras, porque se comparó con
18446744073709551615. strlen y sizeof devuelven size_t. El arreglo de la advertencia es el de la línea
con cast a int de arriba: guardar la longitud en un int, con un cast, si saben que cabe. Es lo que
vienen haciendo desde Introducción a la Computación. Un cast no es una decoración: dice que ustedes
revisaron que el valor cabe.
Error común. Callar la advertencia
-Wsign-comparesin entenderla. Es una de las pocas veces quegccles avisa de un bug real, y sin ella el programa simplemente da la respuesta contraria.
Promoción de enteros
Lo que es más chico que un int se convierte a int antes de operar. Se llama promoción de enteros
(integer promotion). En promotion.c:
unsigned char a = 200;
unsigned char b = 100;

int sum = a + b;
unsigned char small_sum = a + b;
unsigned char top = 255;
printf("top + 1 == 0: %d\n", top + 1 == 0);
unsigned int big_top = 4294967295u;
printf("big_top + 1 == 0: %d\n", big_top + 1 == 0);$ build/promotion
sum = 300, small_sum = 44
sizeof(a) = 1, sizeof(a + b) = 4
top + 1 == 0: 0
big_top + 1 == 0: 1Lean línea por línea:
a + bno se hace en 8 bits. Los dos pasan aint, y da 300.sumlo recibe entero.small_sumno tiene dónde guardar 300. La conversión aunsigned charreduce módulo 256: 300 - 256 = 44.sizeof(a + b)confirma que el resultado es unint, de 4 bytes en este entorno.top + 1vale 256, porquetopse volvióint: no dio la vuelta. En cambio,big_top + 1no se promueve a nada, porqueunsigned intno es más chico queint, y ahí sí da la vuelta a 0.
Conversiones que pierden información
Una asignación a un tipo más chico no da ninguna advertencia con -Wall -Wextra. Las tres de narrowing.c
compilan en silencio:
int total = 300;
unsigned char small = total;
double price = 3.99;
int soles = price;unsigned int large = 3000000000u;
int wrong = large;$ build/narrowing
small = 44
soles = 3
wrong = -1294967296Cada una tiene un estatus distinto:
| Conversión | Qué dice C |
|---|---|
| A un tipo sin signo, si no cabe | Definida: se reduce módulo 2^n. small vale 44 en cualquier máquina |
De double a int, si la parte entera cabe |
Definida: se descartan los decimales, sin redondear |
| A un tipo con signo, si no cabe | La decide cada compilador, que debe documentarla. gcc reduce módulo 2^32 |
De double a int, si la parte entera no cabe |
Comportamiento indefinido |
gcc tiene una opción que no viene en -Wall -Wextra y que avisa de todas estas. Conviene probarla de vez
en cuando, aunque es ruidosa en un programa grande:
$ gcc -Wall -Wextra -std=c17 -Wconversion narrowing.c -o build/narrowing_checked
narrowing.c: In function 'main':
narrowing.c:6:27: warning: conversion from 'int' to 'unsigned char' may change value [-Wconversion]
    6 |     unsigned char small = total;
      |                           ^~~~~
narrowing.c:10:17: warning: conversion from 'double' to 'int' may change value [-Wfloat-conversion]
   10 |     int soles = price;
      |                 ^~~~~
narrowing.c:14:17: warning: conversion to 'int' from 'unsigned int' may change the sign of the result [-Wsign-conversion]
   14 |     int wrong = large;
      |                 ^~~~~
Tres reglas prácticas cierran esta sección:
- Para contar y para índices, usen
int, mientras los tamaños quepan. Es lo que hace este curso. - No mezclen signos en una comparación. Si
gccavisa, conviertan con un cast, después de pensar si el valor cabe. - Usen
unsignedpara trabajar con bits y bytes, no para decir “este número no puede ser negativo”. Ununsignedno impide el negativo: lo convierte en un número enorme, y el bug se vuelve invisible.
Comportamiento indefinido
Lo han visto nombrado varias veces. Ahora lo miramos de frente. El estándar de C divide lo que un programa puede hacer en tres grupos:
| Grupo | Qué significa | Ejemplo |
|---|---|---|
| Definido | El estándar dice qué pasa | unsigned char que da la vuelta |
| Definido por la implementación | Cada compilador elige, y debe documentarlo | int wrong = large;, si no cabe |
| Indefinido | El estándar no exige nada | Overflow de un int, un índice fuera de rango, leer una local sin inicializar |
“No exige nada” es literal. No significa “da un número raro”. Significa que el programa completo deja de tener un significado definido, y que el compilador puede suponer que eso nunca ocurre. Esa suposición es la que sorprende, y es la que veremos ahora.
Por qué “me funcionó” no prueba nada
Si x es el mayor int, ¿x + 1 es mayor que x? Veamos errors/overflow_compare.c:
int next = x + 1;
printf("next = %d, next > x: %d\n", next, next > x);

int steps = 0;
for (int i = x; i > 0 && steps < 5; i++) {
    steps++;
}
printf("steps = %d\n", steps);
Lo compilamos dos veces, con el mismo código y sin ninguna advertencia. La opción -O2 le pide a gcc que
optimice, es decir, que genere un ejecutable más rápido sin cambiar lo que hace un programa sin comportamiento indefinido. -O0 le
pide que no optimice, y es lo que usamos con gdb.
$ gcc -Wall -Wextra -std=c17 -O0 errors/overflow_compare.c -o build/overflow_o0
$ gcc -Wall -Wextra -std=c17 -O2 errors/overflow_compare.c -o build/overflow_o2
$ echo 2147483647 | build/overflow_o0
next = -2147483648, next > x: 0
steps = 1
$ echo 2147483647 | build/overflow_o2
next = -2147483648, next > x: 1
steps = 5
Lean la línea de -O2: dice que next vale -2147483648, y a la vez que es mayor que 2147483647. Las dos
cosas en la misma línea. No es un error de gcc. El compilador razona así: como el overflow de un int
no puede ocurrir en un programa válido, x + 1 siempre es mayor que x, y no vale la pena hacer la
comparación. Lo mismo con el ciclo: si i empieza siendo positivo y solo aumenta, i > 0 siempre es
cierto.
Esa decisión es correcta para todo programa sin comportamiento indefinido, y hace más rápidos a los programas normales. Con 5 como entrada, los dos ejecutables hacen lo mismo:
$ echo 5 | build/overflow_o0
next = 6, next > x: 1
steps = 5
$ echo 5 | build/overflow_o2
next = 6, next > x: 1
steps = 5
Esa es la respuesta a la pregunta de por qué un programa con comportamiento indefinido puede funcionar hoy y fallar mañana:
- Depende del compilador, de su versión y de sus opciones, como acabamos de ver. Estos resultados son de
este
gcc; otro puede dar otros. - Depende de lo que hay en la memoria, como veremos con la variable sin inicializar. Cambiar una línea lejana puede cambiar esos bytes.
- Depende de los datos. El programa de arriba es correcto para casi todas las entradas.
Una prueba que pasa solo dice que, en esa corrida y con esos datos, no se notó.
Idea clave. Si un programa tiene comportamiento indefinido, que funcione no es evidencia de nada. No se puede razonar sobre lo que “de verdad” hace la máquina, porque el compilador ya tomó decisiones suponiendo que eso no pasaba.
Cómo encontrarlo: overflow
-fsanitize=undefined, o UBSan, agrega revisiones al ejecutable, y lo vienen usando desde el principio
del curso. Sus avisos van a la salida de errores: en una terminal salen así, intercalados con lo que escribe
el programa.
$ gcc -Wall -Wextra -std=c17 -g -fsanitize=undefined errors/overflow_compare.c -o build/overflow_ub
$ echo 2147483647 | build/overflow_ub
errors/overflow_compare.c:10:9: runtime error: signed integer overflow: 2147483647 + 1 cannot be represented in type 'int'
next = -2147483648, next > x: 0
errors/overflow_compare.c:14:42: runtime error: signed integer overflow: 2147483647 + 1 cannot be represented in type 'int'
steps = 1
Solo avisa si esa línea se ejecuta con esos datos. Con la entrada 5 no diría nada.
Índice fuera de rango
int grades[4] = {14, 9, 17, 11};printf("grades[%d] = %d\n", i, grades[i]);Sin sanitizers, un índice 4 da lo que haya ahí, y un índice lejano puede matar el programa. Los resultados dependen del entorno:
$ gcc -Wall -Wextra -std=c17 errors/index_out.c -o build/index_plain
$ echo 4 | build/index_plain
grades[4] = -1053909216
$ echo 1000000 | build/index_plain
bash: line 1:    15 Done                    echo 1000000
        16 Segmentation fault      | build/index_plain
Con los sanitizers de siempre, el error se encuentra en el primer caso:
$ gcc -Wall -Wextra -std=c17 -g -fsanitize=address,undefined errors/index_out.c -o build/index_out
$ echo 4 | build/index_out
errors/index_out.c:10:42: runtime error: index 4 out of bounds for type 'int [4]'
...
==201==ERROR: AddressSanitizer: stack-buffer-overflow on address 0xffff84400050 at pc 0xaaaab7d01474 bp 0xffffce169b80 sp 0xffffce169b98
READ of size 4 at 0xffff84400050 thread T0
    #0 0xaaaab7d01470 in main errors/index_out.c:10
Variable sin inicializar
discount no le da valor a percent si la edad está entre 18 y 64. En errors/uninitialized.c:
int discount(int age) {
    int percent;
    if (age < 18) {
        percent = 50;
    } else if (age >= 65) {
        percent = 30;
    }
    return percent;
}
Sin optimizar, gcc no avisa. Y con los dos sanitizers, el programa corre sin ningún reclamo, y responde un
descuento. El valor depende del entorno:
$ gcc -Wall -Wextra -std=c17 -g -fsanitize=address,undefined errors/uninitialized.c -o build/uninitialized
$ echo 30 | build/uninitialized
descuento: 0%
$ gcc -Wall -Wextra -std=c17 -g -O0 errors/uninitialized.c -o build/uninitialized_gdb
$ echo 30 | build/uninitialized_gdb
descuento: 65535%
La respuesta 0% es la peligrosa: parece correcta, y las pruebas pasarían. ASan y UBSan no detectan
esta clase de error. Para esto están valgrind, que sigue qué bytes recibieron un valor, y la advertencia de
gcc que solo se activa al optimizar. Recuerden que valgrind se usa sin sanitizers:
$ echo 30 | valgrind -q --track-origins=yes build/uninitialized_gdb
==44== Use of uninitialised value of size 8
...
==44==    by 0x10886B: main (uninitialized.c:19)
==44==  Uninitialised value was created by a stack allocation
==44==    at 0x1087E8: discount (uninitialized.c:4)
$ gcc -Wall -Wextra -std=c17 -O2 errors/uninitialized.c -o build/uninitialized_o2
errors/uninitialized.c: In function 'discount':
errors/uninitialized.c:11:12: warning: 'percent' may be used uninitialized [-Wmaybe-uninitialized]
11 | return percent;
| ^~~~~~~
errors/uninitialized.c:5:9: note: 'percent' was declared here
5 | int percent;
| ^~~~~~~Ninguna herramienta lo ve todo
Un último ejemplo: un double cuya parte entera no cabe en un int también es comportamiento indefinido, y
-fsanitize=undefined, a pesar de su nombre, no lo revisa. Hace falta pedirlo aparte. El número de la
primera corrida depende de la máquina:
$ gcc -Wall -Wextra -std=c17 -g -fsanitize=address,undefined errors/double_too_big.c -o build/double_too_big
$ echo 3e10 | build/double_too_big
n = 2147483647
$ gcc -Wall -Wextra -std=c17 -g -fsanitize=undefined,float-cast-overflow errors/double_too_big.c -o build/double_checked
$ echo 3e10 | build/double_checked
errors/double_too_big.c:9:5: runtime error: 3e+10 is outside the range of representable values of type 'int'
n = 2147483647
Esta tabla resume lo que comprobamos en este capítulo, y test_examples.py comprueba cada fila:
| Error | -Wall -Wextra |
ASan + UBSan | valgrind |
|---|---|---|---|
Overflow de un int |
No | Sí, si se ejecuta | No |
| Índice fuera de rango de un arreglo local | No, si el índice se lee al correr | Sí, si se ejecuta | No ve el índice. Aquí solo avisó de un valor sin inicializar |
| Local sin inicializar | Solo con -O2, y no siempre |
No | Sí, si se usa el valor |
Doble free |
No | Sí | Sí |
double que no cabe en un int |
No | No, sin float-cast-overflow |
No |
| Leer la variante equivocada, sin usarla como dirección | No | No | No |
Cómo evitarlo
Las herramientas encuentran errores en los caminos que se ejecutan, y por eso la defensa principal es
escribir de modo que el error no pueda ocurrir. Para el overflow, la técnica es revisar antes de operar,
porque después ya es tarde. Es lo que hace value_parse en lab/value.c, y lo van a leer en el
laboratorio:
if (value > (INT_MAX - digit) / 10) {
    return 0;
}
value = value * 10 + digit;
Por eso mismo value_parse no usa sscanf con %d para los enteros. En Introducción a la Computación
vieron que sscanf no promete ningún aviso si el número no cabe: según el estándar, también eso es
comportamiento indefinido.
El código de esta semana
make compila los programas de la clase en build/. make test corre tres archivos de pruebas:
| Archivo | Qué comprueba |
|---|---|
test_examples.py |
Que los programas compilan sin advertencias, y cada afirmación sobre herramientas: qué avisa gcc, qué detectan los sanitizers y qué detecta valgrind |
test_notes.py |
Vuelve a correr los comandos de este capítulo y compara su salida. Los bloques que dependen del sistema se corren, pero no se comparan |
test_lab.py |
La solución del laboratorio, si está disponible |
make test-lab corre esas mismas pruebas de laboratorio sobre su código.
El laboratorio, paso a paso
Los archivos de partida están en code/week-07/lab, y su README.md tiene las preguntas y lo que pide cada
parte. Esta semana hay una sola sesión, porque la otra es para la Práctica 2. make test-lab comprueba el
módulo: falla hasta que terminen. Aquí están las ideas, no el código.
El tipo es el mismo esquema de Payment, con cuatro variantes, y está en lab/value.h:
typedef enum { VALUE_NONE, VALUE_INT, VALUE_DOUBLE, VALUE_STRING } ValueKind;

typedef struct {
    ValueKind kind;
    union {
        int integer;   // VALUE_INT
        double number; // VALUE_DOUBLE
        char *text;    // VALUE_STRING: cadena en el heap, que posee este Value
    } as;
} Value;
La variante VALUE_NONE no tiene dato. No es un número especial, como un -1, ni una cadena vacía: es otro
estado, que no se puede confundir con un dato válido. Por eso no hace falta reservar ningún valor para decir
“no hay”.
El módulo Value. value_none, value_int y value_parse ya están hechos: value_int es el modelo
de los otros constructores. Lo que debe cuidar cada función:
value_stringguarda una copia. Quien la llama puede cambiar o perder su cadena después.value_freemira la etiqueta, y deja el valor como nada.value_printyvalue_equalllevan unswitchsindefault.value_equalmira primero las etiquetas: si no coinciden, no hay nada más que comparar, y leer launiondel otro sería leer la variante equivocada.
La tabla. El archivo es un CSV en el que una misma columna puede mezclar tipos, y eso es lo que
justifica Value. La columna tarifa tiene enteros y decimales, y pasajeros tiene un dato ausente y otro
escrito en palabras. Una tabla es un solo arreglo de Value, fila por fila, con la misma fórmula de
image_from_values.
table.c trae hecha la lectura, y ustedes escriben tres cosas: add_row, table_free y table_summary.
Antes de escribir table_free, respondan quién posee qué. La tabla posee el arreglo de celdas, y cada celda
posee su cadena. Por eso primero se liberan las cadenas, luego el arreglo y al final la tabla. Si invierten
el orden, ASan lo muestra.
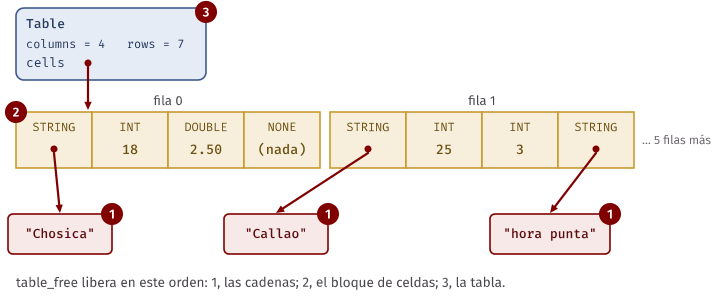
En table_summary, el error típico es empezar el mínimo y el máximo en 0: una columna con solo números
positivos tendría mínimo 0, que no aparece en los datos. El primer número encontrado debe fijar los dos.
Esto debe producir su programa:
$ build/lab/report lab/data/viajes.csv
7 filas y 4 columnas

"Chosica" | 18 | 2.50 | (nada)
"Callao" | 25 | 3 | "hora punta"
"Chosica" | 22 | 2.50 | (nada)
"Ate" | (nada) | 1.80 | "sin conteo"
"Callao" | 31 | 3.50 | "feriado"
"Ate" | 9 | 2 | (nada)
"Chosica" | "sin dato" | 2.50 | "lluvia"

columna      enteros decimales cadenas   nada      suma   media     min     max
ruta               0         0       7      0
pasajeros          5         0       1      1    105.00   21.00    9.00   31.00
tarifa             2         5       0      0     17.80    2.54    1.80    3.50
nota               0         0       4      3
En C.
report.crecibe el nombre del archivo en la línea de comandos. Por eso sumainse declara comoint main(int argc, char *argv[]):argcdice cuántas palabras tiene el comando, yargves un arreglo de cadenas con esas palabras.argv[0]es el nombre del programa yargv[1]es lo que viene después. No hace falta nada más para este laboratorio.
Comprueben una fila a mano antes de creerle a su programa. En tarifa hay 2 enteros y 5 decimales, que
suman 17.80. Como todo corre con ASan, terminar sin un informe significa que ningún bloque quedó sin liberar
en esa corrida.
Resumen
- Un tipo dice qué valores existen y qué se puede hacer con ellos. Mientras menos estados inválidos se puedan representar, menos hay que revisar.
typedefda otro nombre al mismo tipo: documenta, pero no protege. Dosstructsí son tipos distintos.- Un
enumdefine valores con nombre. Frente a#definese gana el nombre engdb, la advertencia de-Wswitchy el aviso al mezclar dosenum. Por dentro es un entero:enum trip_state state = 7;compila. - En un
switchsobre unenum, no pongandefault, para que-Wallavise si falta un caso. Dejen unreturndespués si la función devuelve algo. - Los campos de una
unionempiezan en el mismo lugar. Tiene espacio para uno, y no recuerda cuál se escribió. - Una unión etiquetada es un
structcon unenumy unaunion. Se crea con constructores y se lee con unswitch. La etiqueta es una promesa que C no revisa. - Leer la variante equivocada interpreta esos bytes con otro tipo. Ninguna herramienta lo detecta. Si esos bytes se usan como dirección, es comportamiento indefinido.
- Asignar un
structcon un puntero adentro copia la dirección, y deja dos owners: hay que elegir entre mover y copiar, y escribirlo en el encabezado. - En una comparación entre
intyunsigned int, osize_t, elintse convierte al tipo sin signo:-1 < 1ues falso. Lo más chico queintse promueve aintantes de operar. - Las asignaciones a tipos más chicos no avisan con
-Wall -Wextra.-Wconversionsí. - El comportamiento indefinido significa que el estándar no exige nada, y el compilador puede suponer
que no ocurre. Por eso un mismo programa da resultados distintos con
-O0y con-O2, y “me funcionó” no prueba nada. - UBSan encuentra el overflow, ASan y UBSan el índice fuera de rango, y valgrind la variable sin inicializar. Cada uno solo en los caminos que se ejecutan, y ninguno lo ve todo. Revisen antes de operar.
Ejercicios
Decidan primero y ejecuten después. Todo programa revisa sus lecturas, compila sin advertencias y libera lo que reserva.
-
¿Qué ventaja tiene un
enumfrente a#define RED 0? Den tres, y digan quéenumno impide. Compruébenlo con un programa pequeño. -
Sin compilar, digan qué avisa
gcccon-Wall -Wextraen cada caso, y qué escribe. Luego compruébenlo.enum light { GREEN, YELLOW, RED }; a) enum light x = 5; printf("%d\n", x); b) switch (x) { case GREEN: puts("g"); break; case RED: puts("r"); break; } c) switch (x) { case GREEN: puts("g"); break; default: puts("o"); break; } -
Sin compilar, digan qué escribe cada línea, y por qué. Luego compruébenlo. La tercera línea depende del tamaño de
int: díganlo.if (-1 < 1u) puts("menor"); else puts("mayor"); if (-1 < 1) puts("menor"); else puts("mayor"); printf("%u\n", 0u - 1u); unsigned char c = 250; c = c + 10; printf("%d\n", c); unsigned char d = 250; printf("%d\n", d + 10); -
¿Qué pasa si leen
v.as.numbercuando la etiqueta dice que hay una cadena? ¿Y si leenv.as.textcuando la etiqueta dice que hay un número, y lo pasan aprintfcon%s? Expliquen la diferencia. Usenerrors/wrong_variant.cyerrors/wrong_text.c. -
Definan una unión etiquetada
Shape, con un círculo (radio), un rectángulo (ancho y alto) y un punto (sin datos), con sus constructores ydouble shape_area(const Shape *s). Agreguen un triángulo, y lean lo que dicegccantes de cambiar la función. -
En
errors/shared_owner.c, escribanPayment payment_copy(const Payment *p), y úsenla para que el programa termine sin errores. Compruébenlo con ASan. ¿Qué variantes pueden copiarse con una simple asignación? -
Este ciclo debería escribir una cadena al revés. Encuentren los dos problemas, digan qué avisa
gcc, y corríjanlo con un cast.for (size_t i = strlen(s) - 1; i >= 0; i--) { putchar(s[i]); } -
Escriban
int add_checked(int a, int b, int *result), que devuelve 1 y guarda la suma si cabe, y devuelve 0 sin tocar*resultsi no cabe. No puede ocurrir overflow en ningún caso: revisen antes de sumar, y tengan en cuenta los dos signos. Pruébenla conassert, conINT_MAXeINT_MIN, y córranla con UBSan. -
Para cada fragmento, digan si tiene comportamiento indefinido. Si lo tiene, digan qué herramienta lo encontraría, y compruébenlo.
a) int x = 2147483647; x = x + 1; b) unsigned int y = 4294967295u; y = y + 1; c) int a[3]; a[0] = 1; printf("%d\n", a[1]); d) int n = 3.99; e) double big = 1e20; int m = big; -
errors/overflow_compare.cda resultados distintos con-O0y-O2. Compílenlo también con-O1, y con-O2 -fwrapv. Averigüen en la ayuda degccqué hace-fwrapvy expliquen el resultado. ¿Con esa opción, sigue siendo comportamiento indefinido engcc? ¿Es C portable? -
Agreguen al laboratorio
Value value_copy(const Value *v). Escriban una prueba que copie una cadena, libere el original y siga leyendo la copia, y corran con ASan. ¿Qué mostraría ASan sivalue_copyfuera soloreturn *v;? -
Agreguen a la tabla una función que sepa si una columna es “pura”, es decir, si todas sus celdas no vacías tienen la misma variante. Después cambien
report.cpara que lo escriba. Luego expliquen por qué esa información no se podría obtener sivalue_parseconvirtiera todo adouble.