Apuntes · Capítulo 10Recursión
Recursión en árbol
Recursión en árbol
La semana pasada, cada llamada recursiva hacía a lo sumo una llamada más: los marcos formaban una cadena que crecía y luego se desarmaba. Muchos problemas no tienen esa forma. Para saber qué parte de una imagen tiene el mismo color que un píxel, hay que mirar hacia arriba, hacia abajo, hacia la izquierda y hacia la derecha. Son cuatro preguntas, y cada una lleva a cuatro más. Cuando una llamada hace varias llamadas, el dibujo de las llamadas ya no es una cadena, es un árbol, y por eso se habla de recursión en árbol (tree recursion).
Hoy veremos tres cosas que antes no aparecían. La primera es que un árbol de llamadas puede ser enorme aunque la función sea de tres líneas. La segunda es que, cuando la recursión recorre una cuadrícula, debe recordar por dónde ya pasó, porque si no, no termina. La tercera es que la profundidad de esa recursión puede ser tan grande como la imagen entera, y la pila no alcanza.
En el laboratorio usarán todo esto para pintar regiones de las imágenes PGM y para construir un Buscaminas de terminal, en memoria dinámica. Al final lo pondrán a prueba con un tablero de 1000 × 1000 sin minas.
Ruta de lectura.
- Antes de clase (15 a 20 minutos, obligatoria): la introducción, Cuando una llamada hace varias llamadas y Contar llamadas de verdad.
- En clase: Flood fill: pintar una región, El estado “visitado”, Contar regiones, Encontrar un camino en un laberinto, ¿Cuán profundo llega la pila? y Una pila propia. Memoización (✂️) entra si alcanza el tiempo.
- Después de clase: El laboratorio, paso a paso. Luego el Resumen y los Ejercicios. Si Memoización no se vio en clase, queda como lectura. Para ir más allá: los últimos ejercicios del capítulo.
Código. Los programas de este capítulo están en
code/week-10. Dentro del entorno del curso, entren a esa carpeta y corranmakepara compilar los ejemplos ymake testpara comprobarlos. Los comandos de este capítulo se corren desde ahí. Los programas deerrors/tienen errores a propósito y se compilan a mano, como se muestra en cada caso.
Cuando una llamada hace varias llamadas
Los números de Fibonacci son 0, 1, 1, 2, 3, 5, 8, 13… Cada uno es la suma de los dos anteriores. La definición ya viene escrita en forma recursiva:
algoritmo fib(n)
    si n < 2 entonces
        devolver n
    fin si
    devolver fib(n - 1) + fib(n - 2)
fin algoritmo
Hay dos casos base, 0 y 1, y un caso recursivo que hace dos llamadas. Razonando como la semana pasada, es
fácil creer que es correcta: si fib(n - 1) y fib(n - 2) están bien, la suma también, y n siempre baja hasta
llegar a un caso base. Lo nuevo es lo que cuesta ejecutarla. fib_trace.c escribe una línea por cada llamada,
con una sangría según su profundidad:
int fib(int n, int depth) {
    printf("%*sfib(%d)\n", depth * 4, "", n);
    if (n < 2) {
        return n;
    }
    return fib(n - 1, depth + 1) + fib(n - 2, depth + 1);
}
En C. En
printf,%*stoma el ancho de un argumento: aquí escribe la cadena vacía""en un ancho dedepth * 4espacios. Es una forma corta de escribir una sangría.
$ build/fib_trace
fib(4)
    fib(3)
        fib(2)
            fib(1)
            fib(0)
        fib(1)
    fib(2)
        fib(1)
        fib(0)
resultado: 3
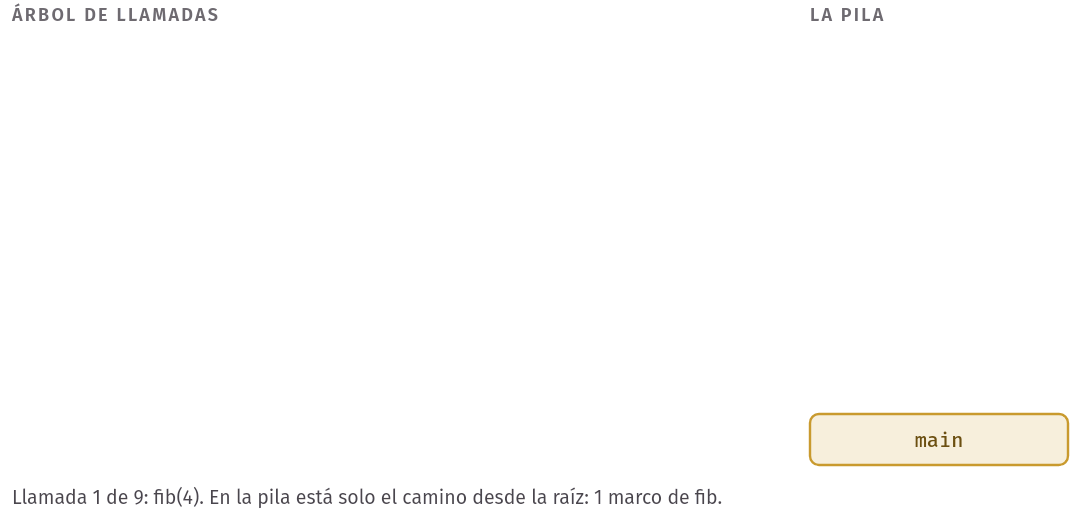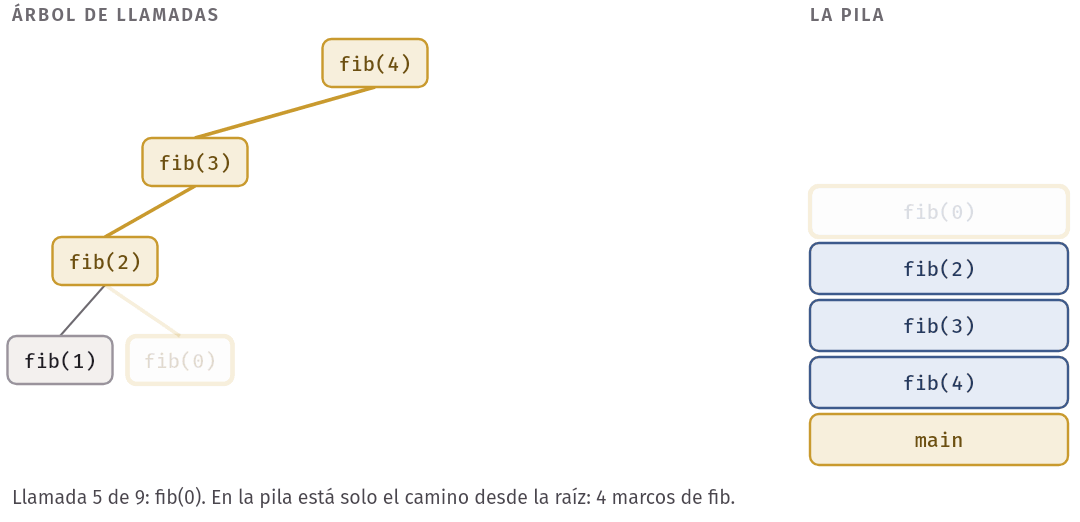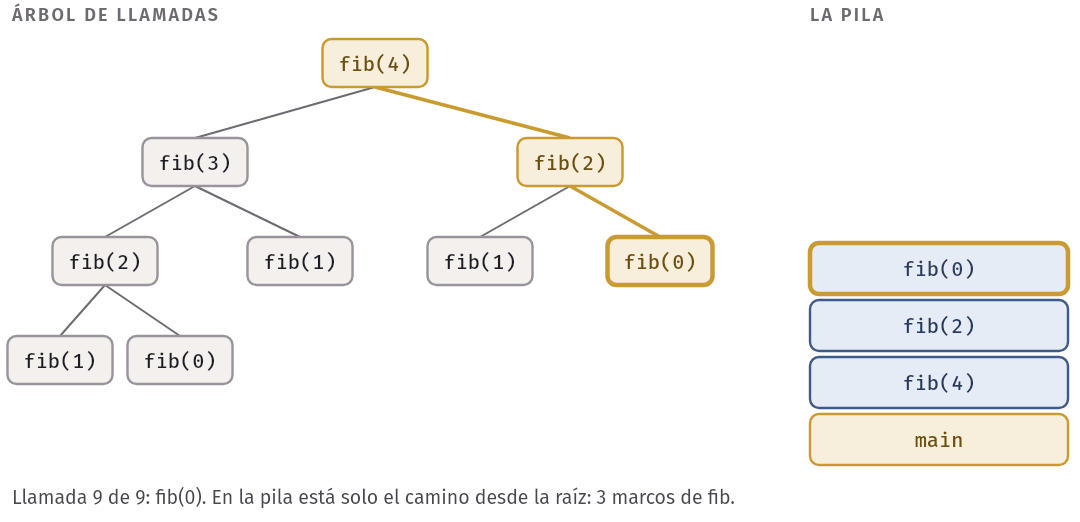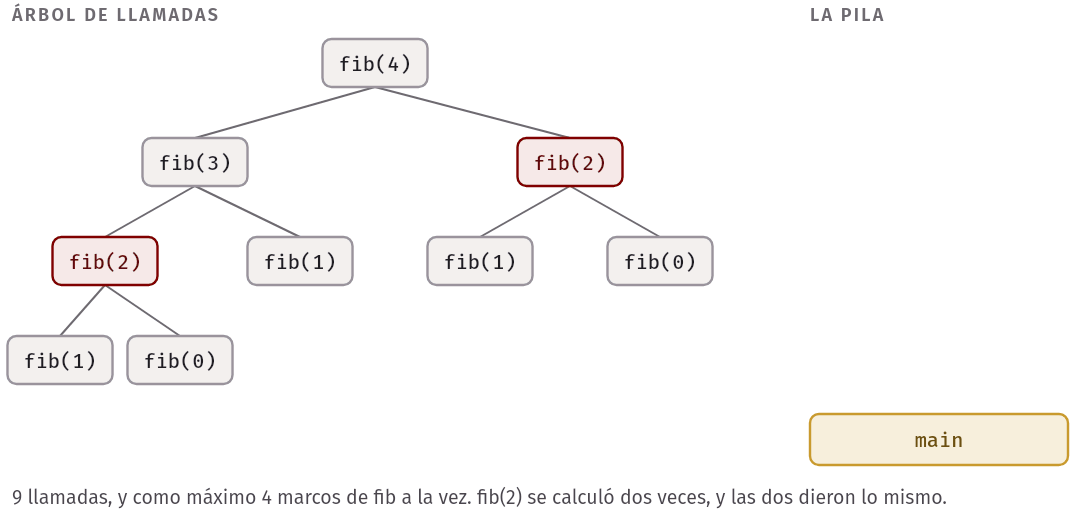
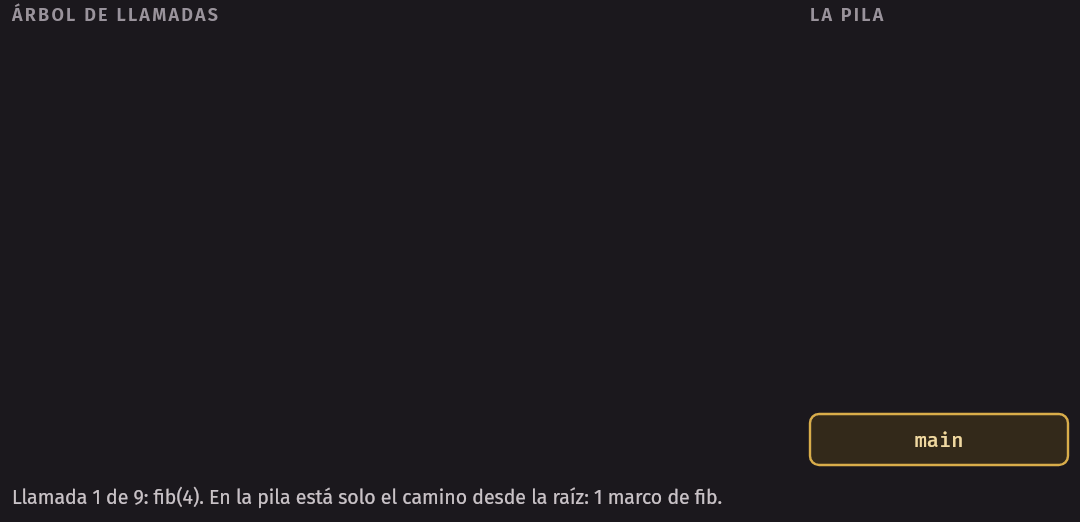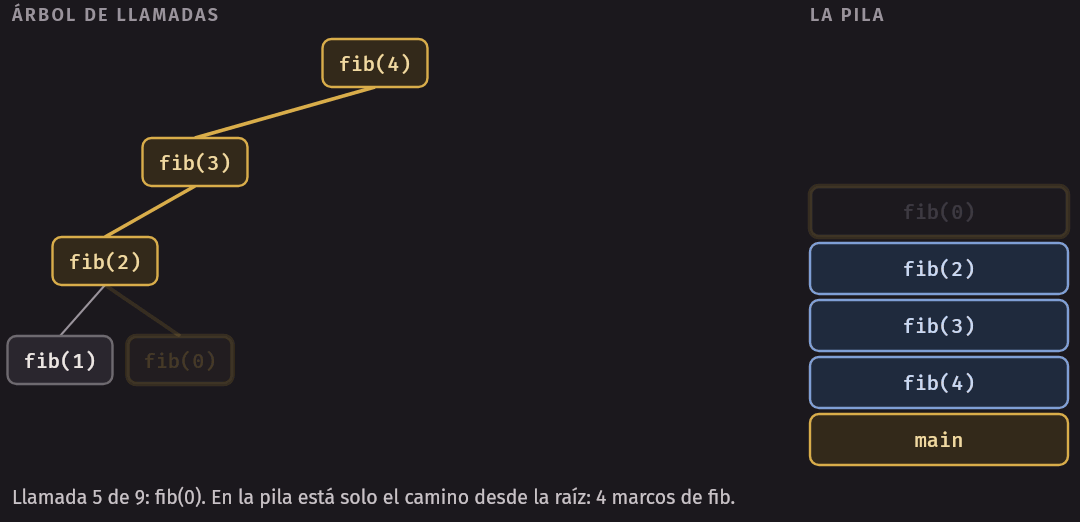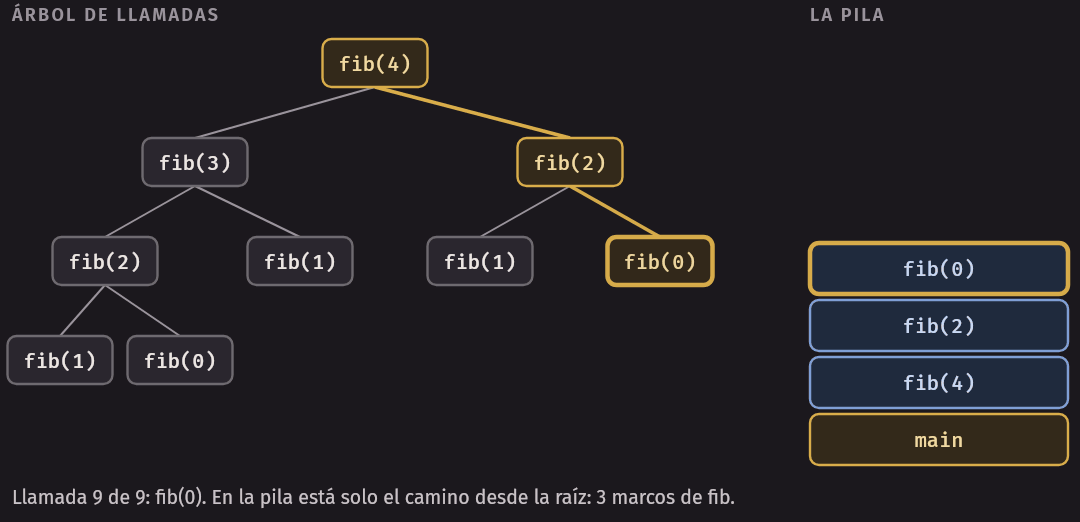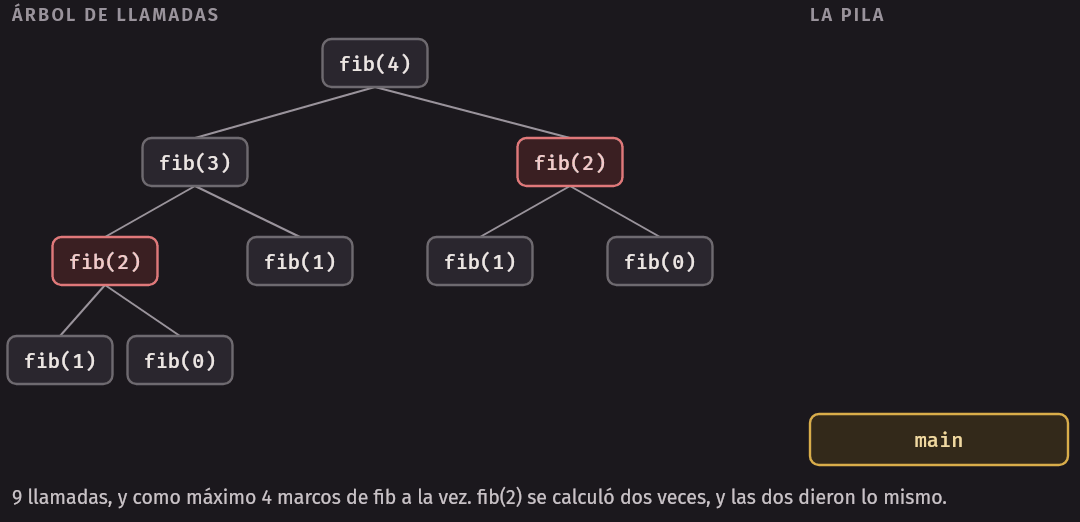
Léanlo como un árbol acostado. fib(4) es la raíz. Sus hijos son las dos llamadas que hace, fib(3) y fib(2),
con la misma sangría. Las llamadas que no hacen más llamadas, los casos base, son las hojas.
Este dibujo muestra dos medidas diferentes, y conviene no confundirlas:
- Cuántas llamadas hay: las líneas. Aquí son 9. Eso mide el trabajo total.
- Cuán profundo llega: la mayor sangría. Aquí son 4 niveles:
fib(4),fib(3),fib(2)yfib(1). Eso mide cuántos marcos hay en la pila a la vez.
En la pila nunca está el árbol completo. Solo está el camino desde la raíz hasta la llamada que está
corriendo. Cuando fib(3) termina, su marco desaparece, y recién entonces empieza fib(2), en el mismo lugar
de la pila.
Idea clave. En una recursión en árbol, el número de llamadas dice cuánto tarda, y la profundidad dice cuánta pila usa. Son dos preguntas distintas, y más adelante veremos un caso donde lo que falla es la segunda.
Contar llamadas de verdad
Mejor que suponer es contar. No queremos una variable global, así que el contador llega por puntero a todas
las llamadas, como aprendieron en la semana 4. En fib_count.c:
long long fib(int n, long long *calls) {
    (*calls)++;
    if (n < 2) {
        return n;
    }
    return fib(n - 1, calls) + fib(n - 2, calls);
}
$ build/fib_count
n fib(n) llamadas
1 1 1
2 1 3
3 2 5
4 3 9
5 5 15
10 55 177
20 6765 21891
30 832040 2692537
35 9227465 29860703
36 14930352 48315633
37 24157817 78176337
40 102334155 331160281Para fib(40) son más de 331 millones de llamadas. En nuestro entorno, con ASan, todo el programa tardó unos
2 segundos. Ese tiempo depende de la máquina. Las llamadas, no.
Comparen las filas 35, 36 y 37: cada una tiene unas 1.6 veces las llamadas de la anterior. Sumar 1 a n
multiplica el trabajo. Un crecimiento así le gana muy pronto a cualquier computadora: subir de n = 40 a
n = 50 multiplica el trabajo por más de 100. Esa forma de crecer se estudia con precisión en Estructuras de
Datos y Algoritmos. Aquí nos basta con haberla medido.
¿De dónde sale tanto trabajo? Miren otra vez el árbol de fib(4) y cuenten:
| Llamada | Veces |
|---|---|
fib(4) |
1 |
fib(3) |
1 |
fib(2) |
2 |
fib(1) |
3 |
fib(0) |
2 |
Se calcula fib(2) dos veces, y las dos dan lo mismo. El programa repite trabajo, porque una llamada no
sabe que otra ya hizo esa cuenta. Volveremos a esto en la última parte del capítulo, porque tiene arreglo.
Error común. Creer que toda recursión en árbol es lenta. Lo lento aquí es repetir. En un flood fill, la recursión en árbol que viene ahora, cada celda se procesa una sola vez, y el trabajo es proporcional al tamaño de la imagen.
Flood fill: pintar una región
Todo programa de dibujo tiene una herramienta de balde: se hace clic en un punto y se pinta toda la zona del mismo color, sin pasar a las otras. Ese algoritmo se llama flood fill, porque la pintura se esparce como el agua.
Primero hay que decir qué es una zona. Una región es un grupo de celdas del mismo valor, conectadas: de cualquiera se puede llegar a cualquier otra caminando hacia arriba, abajo, izquierda o derecha, sin salir del grupo. Las diagonales no conectan en esta definición. Son las cuatro vecinas de una celda.
La recursión aparece sola. Pintar la región desde una celda es: pintar esa celda, y luego pintar la región desde cada una de sus cuatro vecinas. Una vecina fuera de la imagen, o de otro valor, no se pinta. Ese es el caso base.
algoritmo flood_fill(imagen, x, y, viejo, nuevo)
    si (x, y) está fuera de la imagen entonces
        devolver
    fin si
    si imagen[x, y] ≠ viejo entonces
        devolver
    fin si
    imagen[x, y] ← nuevo
    flood_fill(imagen, x, y - 1, viejo, nuevo)
    flood_fill(imagen, x, y + 1, viejo, nuevo)
    flood_fill(imagen, x - 1, y, viejo, nuevo)
    flood_fill(imagen, x + 1, y, viejo, nuevo)
fin algoritmo
En el laboratorio lo escribirán para imágenes PGM. En clase lo veremos sobre una cuadrícula de caracteres,
porque el resultado se puede leer directamente en la terminal. Filas y columnas en lugar de x e y, y las
mismas cuatro llamadas. En grid_fill.c:
void fill(char grid[][COLS + 1], int row, int col, char old_mark, char new_mark) {
    if (row < 0 || row >= ROWS || col < 0 || col >= COLS) {
        return;
    }
    if (grid[row][col] != old_mark) {
        return;
    }
    grid[row][col] = new_mark;
    fill(grid, row - 1, col, old_mark, new_mark);
    fill(grid, row + 1, col, old_mark, new_mark);
    fill(grid, row, col - 1, old_mark, new_mark);
    fill(grid, row, col + 1, old_mark, new_mark);
}
En C. Como vieron en Introducción a la Computación, una función que recibe una matriz debe saber cuántas columnas tiene: por eso
grid[][COLS + 1]. Cada fila es una cadena, y el+ 1es el espacio de su\0.
El programa pinta desde la fila 4, columna 8, y escribe la cuadrícula antes y después:
$ build/grid_fill
....#.......
....#..###..
#####..#.#..
..#....###..
..#.........
..#.........

....#ooooooo
....#oo###oo
#####oo#.#oo
..#oooo###oo
..#ooooooooo
..#ooooooooo
Vean lo que no se pintó. El . dentro del cuadrado de # es del mismo valor, pero no está conectado. Las zonas
de la izquierda tampoco: las paredes de # las separan. El algoritmo no tiene ninguna noción de “adentro” o
“afuera”. Solo sigue a las vecinas, y lo correcto sale de ahí.
¿Por qué termina?
Con Fibonacci, n bajaba en cada llamada. Aquí no hay ningún número que baje: row y col suben y bajan.
Lo que baja es otra cosa: la cantidad de celdas que aún valen old_mark. Cada llamada que hace más llamadas
acaba de pintar una celda, justo antes, y esa cuenta nunca sube. Como es finita, en algún momento no quedan
celdas que pintar, y todas las llamadas caen en un caso base.
Es el mismo razonamiento de la semana 9, con otra medida. Cuando una recursión no tiene un argumento que se achique, hay que preguntarse qué es lo que se achica.
Seguir una llamada a mano
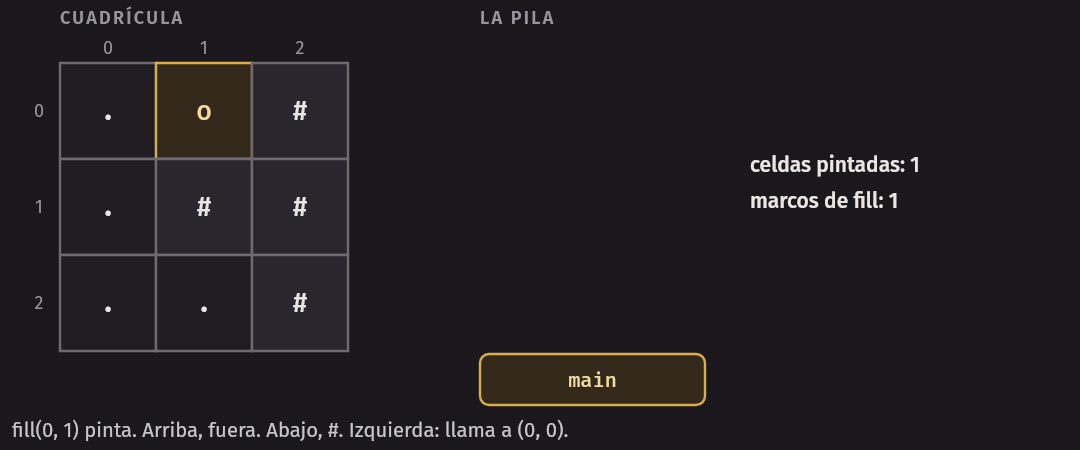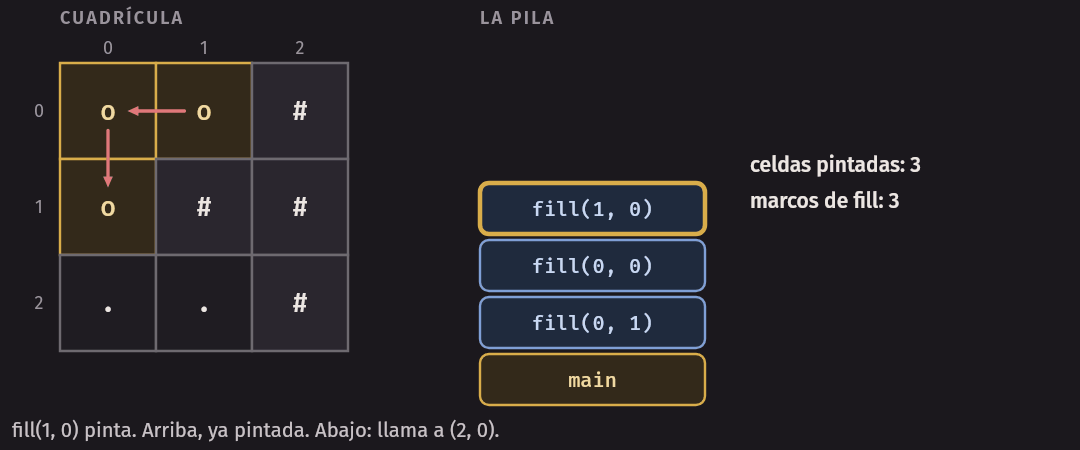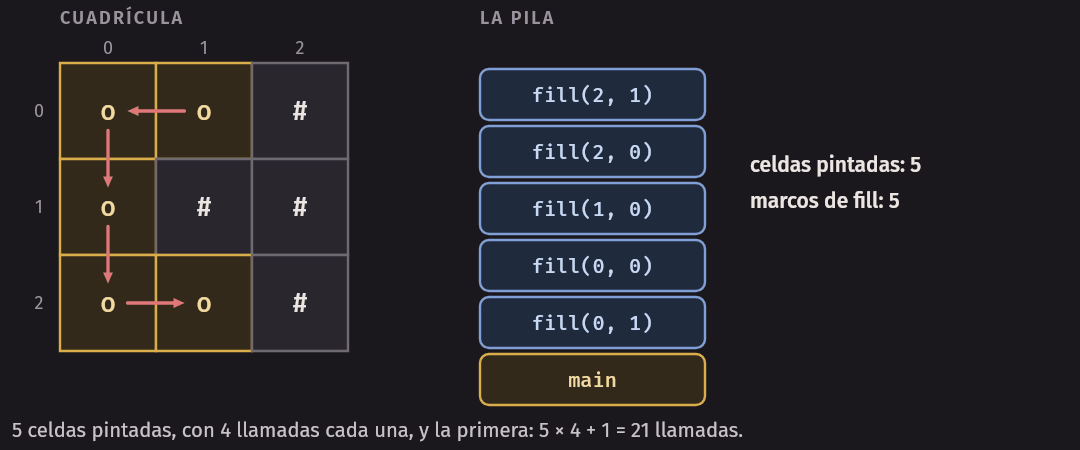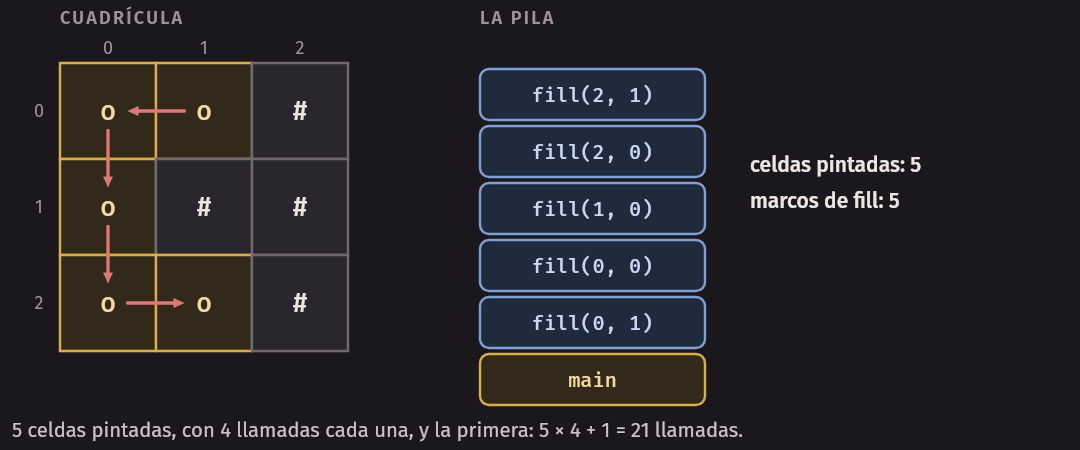
fill_trace.c hace lo mismo sobre una cuadrícula de 3 × 3, con una línea cada vez que pinta, y cuenta las
llamadas. La cuadrícula es esta, y se empieza en (0, 1):
..#
.##
..#
$ build/fill_trace
pinta (0, 1)
pinta (0, 0)
pinta (1, 0)
pinta (2, 0)
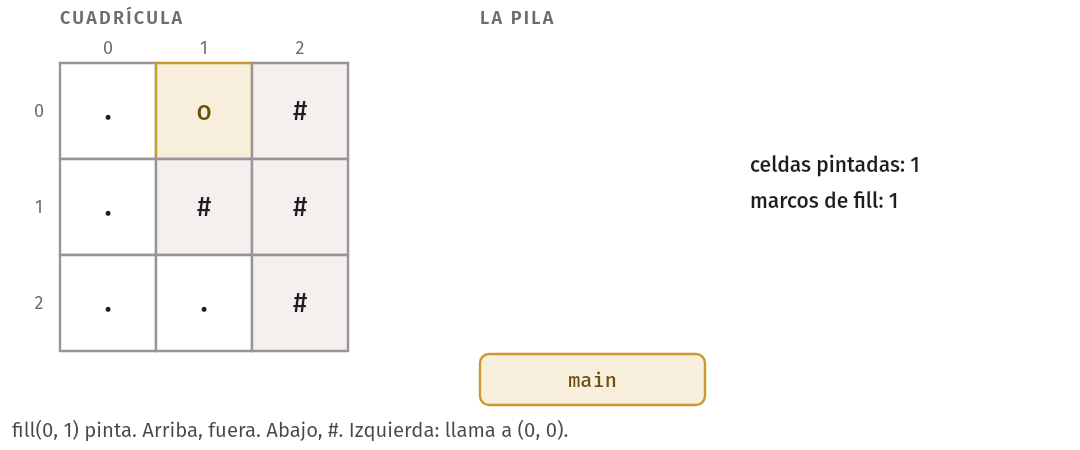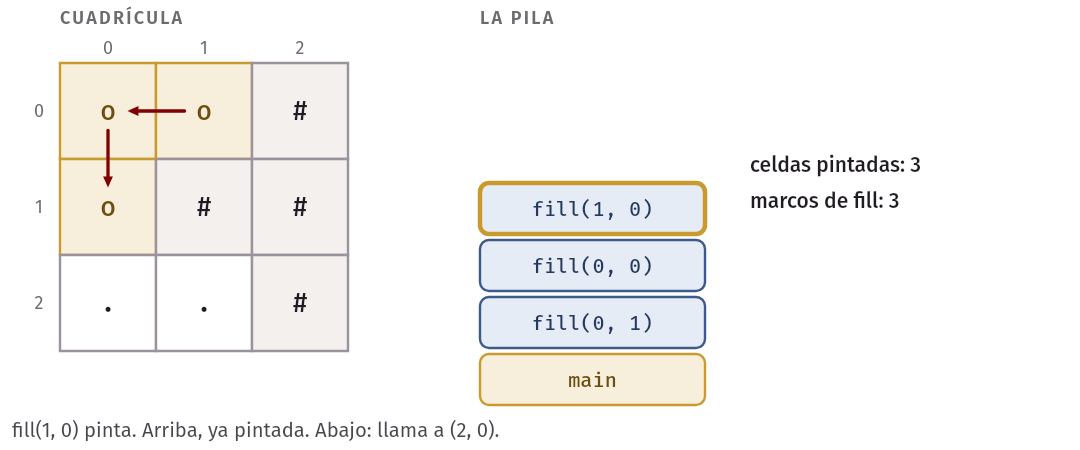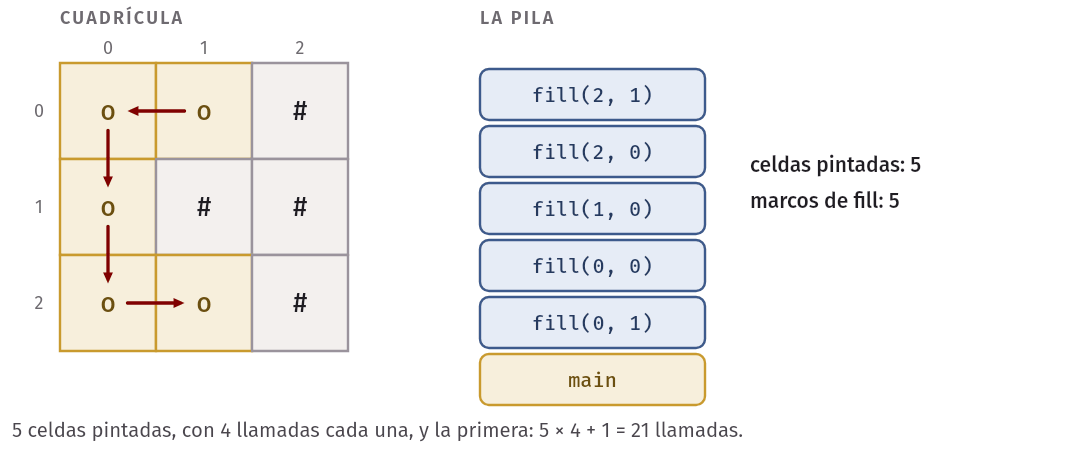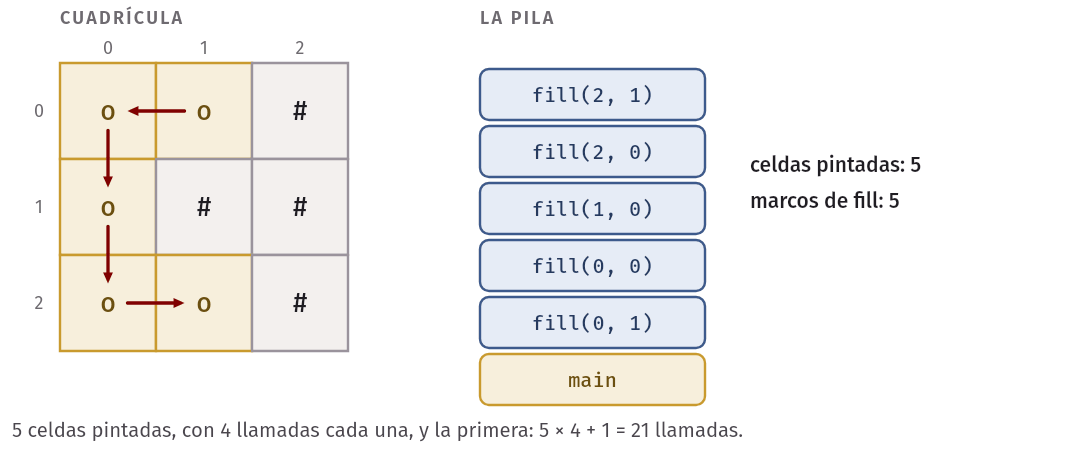
pinta (2, 1)
oo#
o##
oo#
5 celdas pintadas, 21 llamadasSigan el orden en el código: arriba, abajo, izquierda, derecha.
| Llamada | Arriba | Abajo | Izquierda | Derecha |
|---|---|---|---|---|
(0, 1) |
fuera | # |
pinta (0, 0) |
# |
(0, 0) |
fuera | pinta (1, 0) |
fuera | ya pintada |
(1, 0) |
ya pintada | pinta (2, 0) |
fuera | # |
(2, 0) |
ya pintada | fuera | fuera | pinta (2, 1) |
(2, 1) |
# |
fuera | ya pintada | # |
¿Por qué 21 llamadas? Cada una de las 5 celdas pintadas hace 4 llamadas, y a eso se suma la primera: 5 × 4 + 1 = 21. La mayoría de las llamadas termina enseguida, en un caso base. Por eso el trabajo crece como el tamaño de la región: es un árbol con muchas hojas, pero nunca se repite una rama.
Esto contesta también a la pregunta por la profundidad en este ejemplo. Al pintar (2, 1) están en la pila las
5 llamadas que pintaron, en cadena. Es la sangría de la salida.
El estado “visitado”
En fill, la línea que pinta hace dos trabajos: es el resultado que queremos, y también es la marca de
visitado. Una celda ya pintada ya no vale old_mark, y por eso quien vuelva a ella se detiene. Los dos errores
clásicos de flood fill rompen esa marca.
Pintar demasiado tarde. errors/fill_no_mark.c pinta después de las llamadas, y no antes:
fill(grid, row - 1, col);
fill(grid, row + 1, col);
fill(grid, row, col - 1);
fill(grid, row, col + 1);
grid[row][col] = 'o';
Parece que da igual, porque de todos modos pinta. Pero (0, 0) llama a (1, 0), que mira hacia arriba: (0, 0) sigue
sin pintar, así que la llama otra vez, y esta a (1, 0), sin fin. El programa compila sin ninguna advertencia, y
como ninguna llamada termina, la pila se agota. El informe de ASan está recortado, y sus direcciones cambian en
cada corrida:
$ gcc -Wall -Wextra -std=c17 -g -fsanitize=address,undefined errors/fill_no_mark.c -o build/fill_no_mark
$ build/fill_no_mark
==201==ERROR: AddressSanitizer: stack-overflow on address 0xffffc9846ff0 (pc 0xaaaab0ea14e8 bp 0xffffc9847020 sp 0xffffc9846ff0 T0)
    #0 0xaaaab0ea14e8 in fill errors/fill_no_mark.c:7
    #1 0xaaaab0ea1694 in fill errors/fill_no_mark.c:14
    #2 0xaaaab0ea1694 in fill errors/fill_no_mark.c:14
    #3 0xaaaab0ea16cc in fill errors/fill_no_mark.c:15
    #4 0xaaaab0ea1694 in fill errors/fill_no_mark.c:14
...
SUMMARY: AddressSanitizer: stack-overflow errors/fill_no_mark.c:7 in fill
La pila del informe se lee como un backtrace de la semana pasada, y aquí se ve el error: las líneas 14 y 15
son las llamadas hacia arriba y hacia abajo, y se alternan. Las dos celdas se están llamando entre sí.
Pintar del mismo color. errors/fill_same_mark.c tiene el fill correcto, y la llamada es esta:
fill(grid, 0, 0, grid[0][0], '.');La región ya vale . y se pide pintarla de .. La celda se “pinta”, pero sigue valiendo old_mark, y la marca
no marca nada. El final es el mismo, stack-overflow. Por eso en grid_fill.c el comentario exige
new_mark != old_mark, y en el laboratorio su flood_fill tendrá que revisar ese caso antes de empezar.
Idea clave. En una recursión sobre una cuadrícula, marquen la celda antes de llamar a sus vecinas, y asegúrense de que la marca se note. Si la marca llega después, o no cambia nada, dos vecinas se llaman entre sí para siempre.
Error común. Leer la celda antes de revisar que esté dentro.
grid[row][col]conrowigual a -1 es un acceso fuera del arreglo, comportamiento indefinido. Por eso la revisión de límites va primero. En el laboratorio,image_gettiene unassert, que detendrá el programa si se equivocan en esto.
Contar regiones
Con flood fill ya sabemos recorrer una región entera. Contarlas sale de un ciclo: se recorre la cuadrícula, cada vez que aparece una celda sin visitar se cuenta una región, y se visita toda esa región para no contarla de nuevo.
count_islands.c cuenta islas en un mapa, donde # es tierra. Una vez contada una isla, la hunde:
void sink(char map[][COLS + 1], int row, int col) {
    if (row < 0 || row >= ROWS || col < 0 || col >= COLS) {
        return;
    }
    if (map[row][col] != '#') {
        return;
    }
    map[row][col] = '~';
    sink(map, row - 1, col);
    sink(map, row + 1, col);
    sink(map, row, col - 1);
    sink(map, row, col + 1);
}
int count_islands(char map[][COLS + 1]) {
int islands = 0;
for (int row = 0; row < ROWS; row++) {
for (int col = 0; col < COLS; col++) {
if (map[row][col] == '#') {
islands++;
sink(map, row, col);
}
}
}
return islands;
}$ build/count_islands
##......#.....
##.....###..#.
........#...#.
...#........#.
....#...##....
.........##...
islas: 6Cuenten a mano antes de seguir. El # de la fila 3 y el de la fila 4 se tocan solo por una esquina, y por eso son
dos islas. Es la definición que elegimos: con ocho vecinas serían una sola.
Aquí hay un costo que conviene ver: count_islands destruye el mapa que recibe. Al terminar no queda ningún
#. Una función que solo cuenta no debería cambiar lo que cuenta. En el laboratorio, count_regions recibe un
const Image *, que promete no cambiar nada. Por eso no puede usar lo pintado como marca, y tendrá que guardar sus
marcas de visitado aparte, en un bloque de memoria dinámica del que será owner.
Idea clave. Hay dos formas de recordar por dónde se pasó: escribir la marca en los datos, o llevar las marcas aparte. Marcar en los datos es corto, pero cambia los datos. Llevarlas aparte cuesta un bloque de memoria, y deja intacto lo que se recorre.
Encontrar un camino en un laberinto
Un laberinto también es una cuadrícula, y buscar la salida también es seguir a las vecinas. Lo que cambia es que cada llamada ahora responde algo: si desde esta celda se puede llegar a la salida.
algoritmo buscar_camino(laberinto, fila, columna)
    si (fila, columna) está fuera entonces
        devolver falso
    fin si
    si laberinto[fila, columna] es la salida entonces
        devolver verdadero
    fin si
    si laberinto[fila, columna] no está libre entonces
        devolver falso
    fin si
    marcar (fila, columna) como parte del camino
    si desde alguna de las cuatro vecinas hay camino entonces
        devolver verdadero
    fin si
    marcar (fila, columna) como callejón
    devolver falso
fin algoritmo
En maze.c, + marca el camino y x los callejones:
int find_path(char maze[][COLS + 1], int row, int col) {
    if (row < 0 || row >= ROWS || col < 0 || col >= COLS) {
        return 0;
    }
    if (maze[row][col] == 'E') {
        return 1;
    }
    if (maze[row][col] != ' ') {
        return 0;
    }
    maze[row][col] = '+';
    if (find_path(maze, row - 1, col) || find_path(maze, row + 1, col)
        || find_path(maze, row, col - 1) || find_path(maze, row, col + 1)) {
        return 1;
    }
    maze[row][col] = 'x';
    return 0;
}
El operador || hace aquí un trabajo importante: si la primera llamada devuelve 1, las otras tres no se
ejecutan. Apenas una llamada encuentra la salida, todas las que están en la pila devuelven 1 sin explorar nada
más, y las celdas + quedan como el camino. Corremos dos laberintos desde (1, 1), el segundo con el paso cerrado:
$ build/maze
hay camino: 1
###########
#+xx#xxxxx#
#+#x#x###x#
#+#xxx#+++#
#+#####+#+#
#+++++++#E#
###########
hay camino: 0
###########
#xxx#xxxxx#
#x#x#x###x#
#x#xxx#xxx#
#x#########
#xxxxxxx#E#
###########
Lean el primero con cuidado. La búsqueda bajó, fue a la derecha, y al llegar a (3, 9) probó primero hacia
arriba, porque ese es el orden del código. Recorrió todo el pasillo de arriba hasta volver al comienzo, y no
encontró nada. Todo ese recorrido quedó en x. Recién entonces, de vuelta en (3, 9), probó hacia abajo.
Tres observaciones:
- El camino encontrado no tiene por qué ser el más corto. Es el primero que se encontró en ese orden. Buscar el más corto pide otro algoritmo, que verán en Estructuras de Datos y Algoritmos.
- Una celda
xno se vuelve a probar. No se pierde nada: igual que flood fill, la búsqueda alcanza todo lo que está conectado con la entrada, así que si hay salida, la encuentra. En el segundo laberinto, todo lo alcanzable quedó enx, y por eso sabe que no hay camino. - Probar, y volver cuando falla, se parece al backtracking de la semana 11. La diferencia es que allá se deshace de verdad la elección, para que otra rama pueda volver a usar esa celda.
¿Cuán profundo llega la pila?
Volvamos a la segunda medida. En fib(n) la profundidad es n, aunque las llamadas sean millones. En flood fill,
¿cuántos marcos puede haber a la vez?
deep_fill.c hace el flood fill de una cuadrícula de N × N vacía, desde la esquina (0, 0), y lleva la cuenta de la
profundidad en cada llamada. Los datos van en un struct que recibe por puntero, y las celdas en un solo bloque,
fila por fila, igual que los píxeles de la semana 5:
void fill(Canvas *canvas, int row, int col) {
    canvas->depth++;
    if (canvas->depth > canvas->max_depth) {
        canvas->max_depth = canvas->depth;
    }
    int size = canvas->size;
    if (row >= 0 && row < size && col >= 0 && col < size && canvas->cells[row * size + col] == 0) {
        canvas->cells[row * size + col] = 1;
        canvas->painted++;
        fill(canvas, row - 1, col);
        fill(canvas, row + 1, col);
        fill(canvas, row, col - 1);
        fill(canvas, row, col + 1);
    }
    canvas->depth--;
}
$ build/deep_fill 3
N = 3: 9 celdas pintadas, 10 marcos apilados como máximo
$ build/deep_fill 10
N = 10: 100 celdas pintadas, 101 marcos apilados como máximo
$ build/deep_fill 100
N = 100: 10000 celdas pintadas, 10001 marcos apilados como máximoEl máximo es N² + 1. La cuenta se ve siguiendo el orden en un tablero de 3 × 3. Desde (0, 0), la función baja
mientras pueda. Al llegar abajo, la única salida es a la derecha. Desde ahí sube mientras pueda, y así:
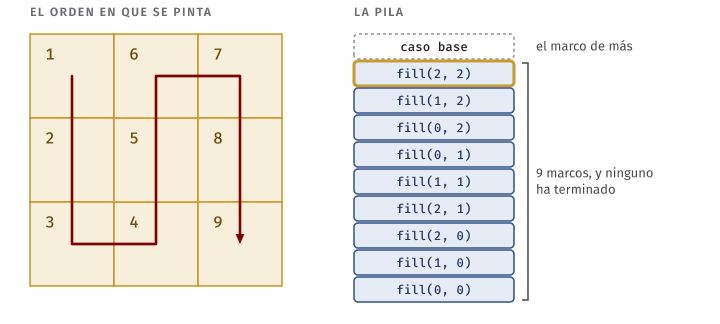
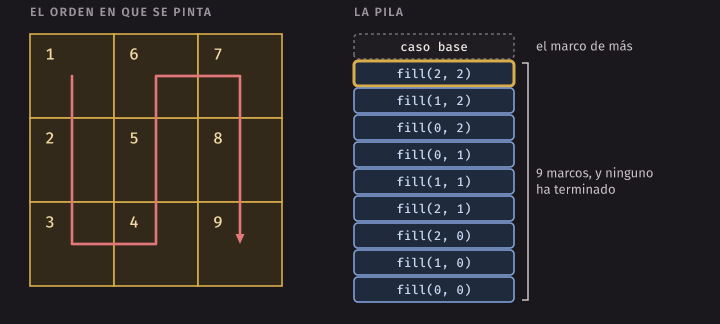
El número es el orden en que se pinta, y ninguna llamada ha terminado todavía cuando se pinta el 9: cada celda llamó a la siguiente y está esperando. La región entera está en la pila. El marco de más es la primera llamada que hace la última celda, que termina en el caso base: va a una celda ya pintada.
Así que la respuesta para una imagen de N × N, en el peor caso, es del orden de N² marcos. No N, como uno podría pensar. Para una imagen de 1000 × 1000 es un millón de marcos.
Error común. Decir “la imagen solo tiene 1000 de lado, así que la recursión tiene unos 1000 niveles”. La profundidad no depende del lado: depende de cuán larga puede ser la cadena de celdas sin que ninguna termine, y eso puede ser la región completa.
Lo que pasa de verdad
La pila es limitada, como vieron en la semana 5. En el entorno del curso son 8 MB:
$ ulimit -s
8192
El Makefile compila deep_fill.c tres veces: deep_fill con ASan, deep_fill_plain sin sanitizers y con
-O0, y deep_fill_o2 sin sanitizers y con -O2. Con un lado de 300, las tres funcionan:
$ build/deep_fill 300
N = 300: 90000 celdas pintadas, 90001 marcos apilados como máximo
$ build/deep_fill_plain 300
N = 300: 90000 celdas pintadas, 90001 marcos apilados como máximo
$ build/deep_fill_o2 300
N = 300: 90000 celdas pintadas, 90001 marcos apilados como máximo
Con un lado de 1000, ninguna. El informe está recortado, y en sus rutas quitamos la carpeta:
$ build/deep_fill 1000
AddressSanitizer:DEADLYSIGNAL
=================================================================
==152==ERROR: AddressSanitizer: stack-overflow on address 0xfffffe174ff0 (pc 0xaaaabbe02668 bp 0xfffffe175030 sp 0xfffffe174ff0 T0)
    #0 0xaaaabbe02668 in fill deep_fill.c:15
    #1 0xaaaabbe02e04 in fill deep_fill.c:24
    #2 0xaaaabbe02e04 in fill deep_fill.c:24
...
SUMMARY: AddressSanitizer: stack-overflow deep_fill.c:15 in fill
==152==ABORTING
$ build/deep_fill_plain 1000; echo "estado: $?"
bash: line 7:   159 Segmentation fault      build/deep_fill_plain 1000
estado: 139
Es un stack overflow. Sin sanitizers, lo único que se ve es Segmentation fault, sin ninguna
pista; la línea de bash lleva esos números porque aquí la salida se capturó en un script. Es lo que vieron la semana pasada con
una recursión sin caso base. Con ASan puede pasar lo mismo en algunas máquinas, que caen sin alcanzar a escribir el
informe: si no aparece, corran el programa otra vez. Pero este programa no tiene ningún bug: su caso base está bien, termina con
cualquier N, y el bloque de un millón de celdas se pidió sin problema. Lo que no alcanzó fue la pila.
¿Y hasta dónde llega? Probando lados en este entorno (aarch64, con 8 MB de pila) encontramos el mayor N que funciona:
| Programa | Compilado | Mayor N que funcionó | Bytes por marco, aprox. |
|---|---|---|---|
deep_fill |
con ASan | 361 | 64 |
deep_fill_plain |
sin sanitizers, -O0 |
417 | 48 |
deep_fill_o2 |
sin sanitizers, -O2 |
417 | 48 |
Los bytes salen de dividir 8 MB entre N², y son una estimación. Estos números dependen de la máquina: en otra arquitectura, con otro compilador o con otras opciones, cada marco ocupa otra cantidad. Pero la conclusión no cambia. Un marco tiene por lo menos la dirección de retorno y los datos guardados, así que un millón de marcos no cabe en 8 MB en ninguna máquina común.
Se puede comprobar que la causa es esa, dándole más pila. Los paréntesis corren esos comandos en un shell aparte, para que el cambio no se quede en su terminal:
$ (ulimit -s 400000; build/deep_fill_plain 1000)
N = 1000: 1000000 celdas pintadas, 1000001 marcos apilados como máximo
Con la misma compilación, ahora termina bien. Pero no es una solución: quien corra su programa tendrá otro límite, y el suyo no se puede cambiar desde el código. Además, un programa no tiene forma de preguntar si la próxima llamada cabrá.
Idea clave. Una recursión correcta también puede caer. Si la profundidad depende del tamaño de la entrada, y esa entrada puede ser grande, el programa tiene un límite escondido, que no sale en ninguna prueba con datos pequeños.
Una pila propia
¿Qué hay en un marco de fill? Lo que queda por hacer: la celda, y cuáles vecinas faltan. Nada obliga a guardar eso
en la pila del sistema. Se puede guardar en un bloque de memoria dinámica, donde el límite es mucho mayor y, si
se acaba, malloc devuelve NULL en lugar de matar el programa.
Lo guardamos en un arreglo que usamos como pila, igual que el módulo Stack del laboratorio de la semana 6, pero con
celdas en lugar de enteros. El algoritmo es un ciclo:
algoritmo flood_fill_con_pila(imagen, x, y)
    pintar (x, y) y ponerla en la pila
    mientras la pila no esté vacía hacer
        sacar una celda de la pila
        para cada vecina de esa celda hacer
            si la vecina está dentro y sin pintar entonces
                pintar la vecina y ponerla en la pila
            fin si
        fin para
    fin mientras
fin algoritmo
En fill_stack.c, la parte que pinta y apila:
void push_if_free(char *cells, int size, Cell *stack, long long *top, int row, int col) {
    if (row >= 0 && row < size && col >= 0 && col < size && cells[row * size + col] == 0) {
        cells[row * size + col] = 1;
        stack[*top].row = row;
        stack[*top].col = col;
        (*top)++;
    }
}
Y el ciclo:
push_if_free(cells, size, stack, &top, 0, 0);
while (top > 0) {
    if (top > max_top) {
        max_top = top;
    }
    top--;
    Cell cell = stack[top];
    painted++;
    push_if_free(cells, size, stack, &top, cell.row - 1, cell.col);
    push_if_free(cells, size, stack, &top, cell.row + 1, cell.col);
    push_if_free(cells, size, stack, &top, cell.row, cell.col - 1);
    push_if_free(cells, size, stack, &top, cell.row, cell.col + 1);
}
Cada celda se pinta al entrar a la pila, y una celda pintada no vuelve a entrar. Por eso la pila nunca pasa de N × N
celdas, y ese es el tamaño que pide el programa con malloc. Ahora con ASan, y con el mismo límite de 8 MB:
$ build/fill_stack 10
N = 10: 100 celdas pintadas, 46 pendientes como máximo
$ build/fill_stack 300
N = 300: 90000 celdas pintadas, 44851 pendientes como máximo
$ build/fill_stack 1000
N = 1000: 1000000 celdas pintadas, 499501 pendientes como máximo
El resultado es el mismo que con la recursión: la misma región pintada, aunque en otro orden. El máximo de pendientes es unas N²/2, y cada entrada ocupa 8 bytes, no los 48 o 64 de un marco.
Error común. Marcar la celda al sacarla de la pila, y no al ponerla. Entonces una misma celda puede entrar varias veces antes de que alguien la marque. Lo medimos cambiando esa línea: con 1000 de lado, el programa sacó de la pila casi 2 millones de celdas en lugar de 1 millón, y llegó a 998002 pendientes. Ya no hay ninguna garantía de que N × N alcance. Marquen al apilar.
¿Cuál usar entonces?
| Recursión | Pila propia | |
|---|---|---|
| Código | Corto, se parece a la definición | Más largo, con más variables |
| Límite | La pila del sistema, unos MB | La memoria dinámica, mucho más |
| Si no alcanza | El programa cae | malloc devuelve NULL, y se puede avisar |
| Cuándo | La profundidad es pequeña y conocida | La profundidad crece con la entrada |
Para un laberinto de 11 × 7 o una imagen de 32 × 16, la recursión es lo correcto, porque es más clara. Para una imagen que puede venir de cualquier parte, es un riesgo. La pregunta que hay que hacerse es siempre la misma: ¿cuán profunda puede ser, y quién decide eso?
Memoización
Volvamos a Fibonacci, que repetía trabajo. Si fib(2) ya se calculó, ¿por qué calcularlo otra vez? Se puede guardar
cada resultado en una tabla, y mirar ahí antes de calcular. Esa técnica se llama memoización (memoization).
algoritmo fib_memo(n, tabla)
    si n < 2 entonces
        devolver n
    fin si
    si tabla[n] ya tiene un valor entonces
        devolver tabla[n]
    fin si
    tabla[n] ← fib_memo(n - 1, tabla) + fib_memo(n - 2, tabla)
    devolver tabla[n]
fin algoritmo
En fib_memo.c, la tabla es un arreglo con un lugar para cada n, y NOT_KNOWN, que vale -1, significa “todavía no”.
Ningún número de Fibonacci es negativo, así que ese valor no se confunde con un resultado:
long long fib_memo(int n, long long memo[], long long *calls) {
    (*calls)++;
    if (n < 2) {
        return n;
    }
    if (memo[n] != NOT_KNOWN) {
        return memo[n];
    }
    memo[n] = fib_memo(n - 1, memo, calls) + fib_memo(n - 2, memo, calls);
    return memo[n];
}
La tabla la pide y la libera fib_with_table, que es su owner. Quien llama solo recibe el número:
long long fib_with_table(int n, long long *calls) {
    long long *memo = malloc((n + 1) * sizeof(long long));
    if (memo == NULL) {
        return -1;
    }
    for (int i = 0; i <= n; i++) {
        memo[i] = NOT_KNOWN;
    }
    long long value = fib_memo(n, memo, calls);
    free(memo);
    return value;
}
Las dos versiones, midiendo las llamadas:
$ build/fib_memo
   n       fib(n)    sin tabla    con tabla
   5            5           15            9
  10           55          177           19
  20         6765        21891           39
  30       832040      2692537           59
  35      9227465     29860703           69
fib(90) = 2880067194370816120, con 179 llamadas
Con la tabla son 2n - 1 llamadas. El árbol se volvió casi una cadena: cada fib(k) se calcula una vez, y la segunda
vez que se pide responde enseguida, desde la tabla. El precio es un bloque de n + 1 números.
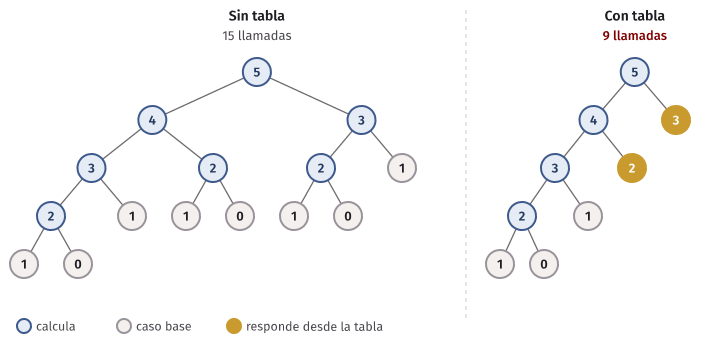
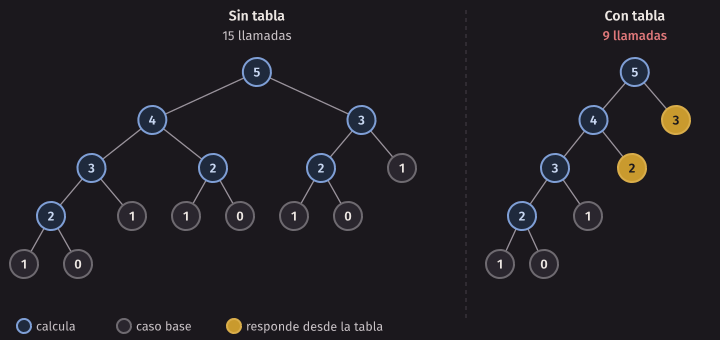
Sin la tabla, fib(90) no se podría calcular. El programa fib_count cumple que las llamadas son 2 × fib(n + 1) - 1,
y para n = 90 eso da más de 9 × 10¹⁸ llamadas. A cien millones por segundo serían unos 3000 años. No lo corrimos:
sale de la fórmula. Con la tabla, fueron 179.
¿Qué tiene que cumplir una función para poder memoizarla?
- Mismo argumento, mismo resultado. El resultado debe depender solo de los argumentos. Una función que lee un archivo, una hora o un número aleatorio puede dar otra cosa la segunda vez, y la tabla devolvería un valor viejo.
- Sin efectos que importen. Si la función escribe en pantalla o cambia un dato, la llamada que responde desde la tabla
no lo hace. Se nota en nuestro propio programa: el contador
callses un efecto, y por eso cambia. Es justo lo que queríamos medir, pero si fuera parte del resultado, la memoización lo habría alterado. - Argumentos que sirvan de índice. Hay que poder buscar el resultado. Con un
intpequeño basta un arreglo. Con argumentos más grandes hace falta otra estructura, que verán en Estructuras de Datos y Algoritmos.
Y para que además valga la pena, los subproblemas tienen que repetirse. Flood fill no cumple las dos primeras: su trabajo es cambiar la imagen, y lo que hace depende de lo ya pintado. Tampoco ganaría nada, porque nunca repite una celda. La memoización no sirve para todo árbol de llamadas.
Idea clave. Memoizar es cambiar memoria por tiempo. Funciona cuando la misma pregunta se hace muchas veces, y cuando la respuesta a esa pregunta no cambia.
El laboratorio, paso a paso
El laboratorio tiene dos sesiones, y la guía está en lab/README.md. Aquí van las ideas.
Sesión 1: regiones y tablero
Reciben terminado el módulo de imágenes de la semana 6, con su tipo opaco. Su flood_fill no puede mirar img->pixels,
y tiene que usar image_get, image_set, image_width e image_height. Lo que cambia respecto a grid_fill.c son esos
detalles, y el caso del valor igual: flood_fill recibe solo el valor nuevo, lee el viejo de la imagen, y si son iguales
no tiene nada que hacer.
count_regions es distinta de count_islands en dos cosas. Cuenta las regiones de todos los valores, de modo que
cada píxel pertenece a alguna. Y recibe un const Image *, así que necesita sus marcas en un bloque aparte. Con
islands.pgm, que tiene un mar, tres islas y una laguna dentro de una de ellas, deben ver esto:
$ build/lab/fill_demo lab/images/islands.pgm 2 2 255

 @@@@     ##
 @  @     ###
 @  @      ##
 @@@@
       ===
       =====

regiones: 5


 @@@@     ##
 @@@@     ###
 @@@@      ##
 @@@@
       ===
       =====

regiones: 4
La laguna valía 0, igual que el mar, pero son dos regiones. Al pintarla de 255 se une con el anillo que la rodea, y queda una región menos.
El tablero es un tipo opaco, Board, como en la semana 6. Tiene dos bloques, el struct y las celdas, y cada celda sabe
si es mina, cuántas minas tiene alrededor y si está tapada, abierta o con bandera. Eso último es un enum, de la
semana 7:
typedef enum {
    CELL_HIDDEN, // vale 0: es lo que queda en un bloque de calloc
    CELL_OPEN,
    CELL_FLAGGED
} CellView;
board_from_rows crea tableros fijos para las pruebas, y board_random los crea a partir de una semilla. Ya están hechos, y
llaman a count_neighbors cuando terminan de poner minas. Como esa función es static, nadie de afuera puede olvidarse de
llamarla: todo tablero que sale del módulo ya tiene sus conteos. Ustedes escriben board_new, board_free y
count_neighbors. Para recorrer las ocho vecinas, dos ciclos de -1 a 1 son más cortos que ocho if.
Sesión 2: abrir celdas
Las reglas son las de siempre. Abrir una mina hace perder. Abrir una celda con minas vecinas muestra el número. Y abrir una celda sin minas vecinas abre también sus ocho vecinas, porque se sabe que ninguna es mina. Es un flood fill con ocho vecinas, donde las celdas con número son la frontera:
algoritmo abrir(tablero, fila, columna)
    si (fila, columna) está fuera del tablero entonces
        devolver
    fin si
    si la celda ya está abierta o tiene bandera entonces
        devolver
    fin si
    abrir la celda
    si la celda es una mina entonces
        anotar que explotó
        devolver
    fin si
    sumar 1 a las celdas abiertas
    si la celda no tiene minas vecinas entonces
        para cada una de sus ocho vecinas hacer
            abrir(tablero, fila de la vecina, columna de la vecina)
        fin para
    fin si
fin algoritmo
La marca de visitado es la vista de la celda, CELL_OPEN, y se pone antes de llamar a las vecinas. Fíjense en que la
recursión nunca abre una mina: solo se expande desde celdas sin minas vecinas.
board_state responde con dos campos: si exploded vale 1 se perdió, y si opened llegó al total de celdas sin mina se
ganó. Para ganar no hacen falta banderas. Las pruebas usan tableros fijos y una semilla conocida, y esta partida se puede
repetir tal cual. Son 5 × 5, 3 minas y la semilla 7. La
entrada viene de un archivo, y por eso lo escrito no aparece y jugada: queda pegado al tablero:
$ build/lab/minesweeper 5 5 3 7 < lab/game_seed7_input.txt | tail -8
 4  . . 1 # 1
jugada:     0 1 2 3 4
 0  . 1 * # *
 1  . 1 1 2 1
 2  . . . . .
 3  . . 1 1 1
 4  . . 1 * 1
Perdieron: abrieron una mina.
Un tablero de 1000 × 1000
Al final de la sesión 2 corren big_board, que abre una esquina de un tablero sin minas. Ya saben qué esperar. Esto dio
nuestra solución, con 100 de lado:
$ build/lab/big_board 100 100
100 x 100: 10000 celdas abiertas, juego ganado
$ build/lab/big_board_plain 100 100
100 x 100: 10000 celdas abiertas, juego ganado
Con 1000 de lado, y 8 MB de pila, cayó con ASan y también sin sanitizers. Con ASan, el informe dijo
stack-overflow, en la función recursiva de abrir celdas. Sin sanitizers dijo solo Segmentation fault, con estado 139.
Con (ulimit -s 400000; ...) el mismo programa sin sanitizers terminó bien, con 1000000 celdas abiertas y el juego
ganado. Sus números de N máximo y de bytes por marco serán los de su función y su máquina: encontrarlos y explicarlos es
parte del laboratorio.
El código de la semana
| Archivo | Para qué |
|---|---|
fib_trace.c, fib_count.c |
El árbol de llamadas de Fibonacci, y cuántas llamadas hace |
fib_memo.c |
Fibonacci con memoización, contra la versión sin tabla |
grid_fill.c, fill_trace.c |
Flood fill sobre una cuadrícula, con y sin rastro |
count_islands.c |
Contar regiones, marcando en los datos |
maze.c |
Buscar un camino, con una función que devuelve si lo encontró |
deep_fill.c |
Medir la profundidad; se compila con ASan, con -O0 y con -O2 |
fill_stack.c |
El mismo recorrido, con una pila propia |
errors/ |
Los dos flood fill que no terminan |
lab/ |
El laboratorio: ver lab/README.md |
make             # compila los programas de la clase en build/
make lab         # compila el laboratorio en build/lab/
make test        # corre las pruebas de los ejemplos y de estos apuntes
make test-lab    # prueba su laboratorio; falla hasta que lo terminen
make clean       # borra lo generado
make test también vuelve a correr los comandos que aparecen en este capítulo. Los bloques con informes de una caída no se
comparan línea por línea, porque cambian con cada corrida y con la máquina: de ellos, las pruebas revisan que el programa
caiga y que ASan diga stack-overflow.
Resumen
- En una recursión en árbol, cada llamada hace varias llamadas. El número de llamadas dice cuánto trabajo hay, y la profundidad dice cuánta pila se usa. En la pila solo está el camino hasta la llamada actual.
fib(n)hace 2 ×fib(n + 1)- 1 llamadas: más de 331 millones parafib(40). El problema no es el árbol, sino que repite los mismos cálculos.- Flood fill pinta una región: pinta una celda y sigue por sus vecinas. Termina porque cada llamada que sigue acaba de pintar una celda, y eso achica lo que falta por pintar.
- La marca de visitado se pone antes de llamar a las vecinas, y tiene que cambiar algo. Sin ella, dos vecinas se llaman entre sí hasta agotar la pila. Pasa si se pinta tarde, o si se pinta del mismo valor.
- Las marcas se pueden escribir en los datos, como
count_islands, o llevarse aparte, cuando los datos no se pueden cambiar. - Buscar un camino devuelve si se encontró. Con
||, en cuanto una vecina tiene camino, las demás no se prueban. - En una imagen de N × N, flood fill puede apilar N² marcos, no N. Con 1000 de lado son un millón, y en 8 MB no caben: el
programa cae aunque no tenga ningún bug. ASan lo llama
stack-overflow, y sin sanitizers esSegmentation fault. - Si la profundidad crece con la entrada, usen una pila propia en memoria dinámica. Marquen al apilar.
- Memoización es guardar los resultados ya calculados:
fib(n)baja a 2n- 1 llamadas. Sirve si la función depende solo de sus argumentos, no tiene efectos que importen, sus argumentos sirven de índice y sus subproblemas se repiten.
Ejercicios
-
Dibujen a mano el árbol de llamadas de
fib(5). ¿Cuántas llamadas hay, y cuál es la profundidad? ¿Cuántas veces aparecefib(2)? Comprueben las llamadas conbuild/fib_count. -
Sigan a mano
fillsobre esta cuadrícula, empezando en(1, 1), y anoten el orden en que se pinta cada celda. Escriban cuántas llamadas hay en total antes de contarlas.#.# ... #.# -
Cambien en
fill_trace.cel orden de las llamadas, primero derecha y luego izquierda, abajo y arriba. ¿Cambia el resultado? ¿Cambia el orden? ¿Cambia el número de llamadas? ¿Cambia la profundidad? Predigan antes de correrlo. -
Compilen
errors/fill_no_mark.csin sanitizers y corran el programa. ¿Qué se ve? Compilen de nuevo con ASan y expliquen, con las líneas del informe, qué dos celdas se están llamando entre sí. -
Agreguen a
count_islands.clas cuatro vecinas diagonales. Antes de correrlo, digan cuántas islas tendrá el mapa, y por qué. -
Escriban
int region_size(char grid[][COLS + 1], int row, int col, char old_mark, char new_mark), que pinte una región y devuelva cuántas celdas pintó, sin contador por puntero y sin variables globales. Pruébenla sobre la cuadrícula degrid_fill.c. -
Copien
maze.cy cambienROWSyCOLSpara este laberinto, con la entrada en(1, 1). Predigan qué camino sale. ¿Es el más corto? Cambien el orden de las llamadas hasta que salga el más corto.####### # E# # ### # # # ####### -
Una imagen de 2000 × 3 está llena de un mismo valor. ¿Cuántos marcos puede apilar flood fill como máximo? ¿Y una de N × N donde solo una fila es de ese valor? Compruébenlo cambiando
deep_fill.cpara que reciba alto y ancho. -
En
fill_stack.c, cambien el orden de los cuatropush_if_free. ¿Cambia el total de celdas pintadas? ¿Y el máximo de pendientes? Luego muevan la marca: pinten al sacar de la pila, y no al apilar. ¿Qué cuenta ahorapainted? ¿Por qué ya no es N²? -
El número de caminos para ir de la esquina de arriba a la izquierda a la de abajo a la derecha de una cuadrícula, moviéndose solo a la derecha o abajo, cumple
caminos(f, c) = caminos(f - 1, c) + caminos(f, c - 1), concaminos= 1 sifoces 0. Escríbanla con un contador de llamadas, y luego memoizada con una matriz en memoria dinámica. Comparen las llamadas para una de 15 × 15. -
¿Se pueden memoizar estas funciones? Justifiquen con las condiciones de los apuntes:
power(base, exp), una función que lee un número del teclado y lo suma a su argumento,count_islands, yis_palindromesobre una cadena que no cambia. -
Reescriban
board_revealdel laboratorio con una pila propia, con la misma interfaz. Comprueben quemake test-labsigue pasando y quebig_board 1000 1000termina bien con ASan. ¿Cuántos bytes pide el bloque de la pila? ¿Dónde se libera?