Apuntes · Capítulo 9Recursión
Recursión
Recursión
Con el parcial cerramos la primera mitad del curso: punteros, memoria dinámica, módulos y tipos. Ahora empieza una parte nueva, con una sola idea: resolver un problema usando la solución de uno más pequeño del mismo tipo.
En Introducción a la Computación vieron la recursión al final, como un tema corto: el factorial con su rastro, el caso base y el programa que se queda sin pila. Hoy la vemos a fondo, por tres razones. La primera es que algunos problemas se dicen de forma natural así, y con un ciclo quedan más enredados. La segunda es que hay una manera de razonar sobre una función recursiva sin seguir cada llamada, que ahorra mucho trabajo. La tercera es que las próximas semanas dependen de esto: recursión en árbol, backtracking y, al final, un intérprete.
No hay nada nuevo en el lenguaje. Una función recursiva es una función común que se llama a sí misma, y todo lo que saben del modelo de entornos sigue valiendo: cada llamada tiene su marco.
Ruta de lectura.
- Antes de clase (15 a 20 minutos, obligatoria): la introducción y Resolver con un problema más pequeño.
- En clase: El salto de fe, Recursión en arreglos, Recursión en cadenas, Búsqueda binaria, Contar las llamadas, Ordenar por mezcla, Recursión e iteración, La pila no es infinita y Depurar recursión.
- Después de clase: El laboratorio, paso a paso. Luego el Resumen y los Ejercicios. Para ir más allá: los últimos ejercicios del capítulo.
Código. Los programas de este capítulo están en
code/week-09. Dentro del entorno del curso, entren a esa carpeta y corranmakepara compilar los ejemplos ymake testpara comprobarlos. Los comandos de este capítulo se corren desde ahí. Los programas deerrors/tienen errores a propósito y se compilan a mano, como se muestra en cada caso.
Resolver con un problema más pequeño
5! es 5 × 4 × 3 × 2 × 1. También es 5 × 4!. Esa segunda forma es la recursión (recursion): para saber el
factorial de n, basta saber el de n - 1. Toda función recursiva tiene dos partes:
- el caso base (base case), tan pequeño que se responde sin otra llamada;
- el caso recursivo (recursive case), que reduce el problema y se llama a sí misma.
algoritmo factorial(n)
    si n ≤ 1 entonces
        devolver 1
    fin si
    resto ← factorial(n - 1)
    devolver n * resto
fin algoritmo
En C es lo mismo. Esta es la versión de factorial.c, que usaremos en gdb:
long long factorial(int n) {
    if (n <= 1) {
        return 1;
    }
    long long rest = factorial(n - 1);
    return n * rest;
}
factorial_trace.c hace la misma cuenta, y escribe qué pasa. Tiene un parámetro más, depth, que solo sirve
para la sangría:
$ build/factorial_trace
entra factorial(4)
  entra factorial(3)
    entra factorial(2)
      entra factorial(1)
      caso base: devuelve 1
    2 * 1 = 2
  3 * 2 = 6
4 * 6 = 24
resultado: 24
Lean el rastro de arriba abajo. Primero baja: cada llamada entra y queda esperando, sin haber multiplicado nada. Al llegar al caso base, vuelve, y recién ahí ocurren las multiplicaciones, de la más interna a la más externa.
Cada llamada tiene su marco
No hay nada especial en que la función se llame a sí misma. factorial(4) llama a factorial(3) igual que
main llama a printf: se crea un marco de llamada (stack frame), con su propio n y su propio rest, y el
marco que llamó se queda esperando. Hay cuatro variables n, en cuatro marcos, con cuatro valores. Comparten el
nombre, igual que dos funciones distintas pueden tener cada una su i.
Justo cuando el caso base va a devolver 1, la pila está así:
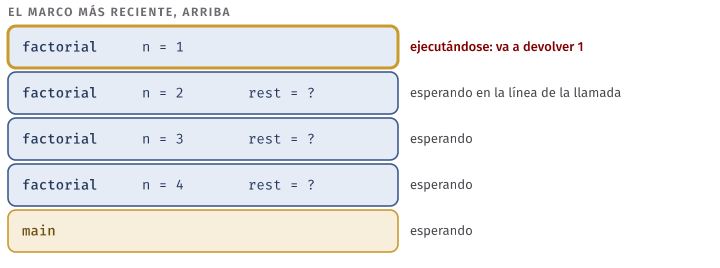
Cada marco recuerda dónde se quedó. Por eso, cuando factorial(1) devuelve 1, la ejecución sigue en el marco
de n = 2, justo donde se había quedado: guarda el 1 en su rest, multiplica, y devuelve 2.
Se puede ver que son variables distintas. frame_addresses.c escribe la dirección de n en cada llamada, y su
valor al volver:
static int count_down(int n) {
    printf("n = %d está en %p\n", n, (void *) &n);
    if (n == 0) {
        return 0;
    }
    int levels = count_down(n - 1);
    printf("al volver, n sigue siendo %d\n", n);
    return levels + 1;
}
Lo compilamos sin sanitizers. ASan agrega espacio alrededor de las variables cuya dirección se toma, y hasta las puede llevar a otra zona de memoria, así que no se vería la pila tal como es. Las direcciones cambian entre corridas y máquinas:
$ gcc -Wall -Wextra -std=c17 -g -O0 frame_addresses.c -o build/frame_addresses_plain
$ build/frame_addresses_plain
n = 3 está en 0xfffff42252cc
n = 2 está en 0xfffff422529c
n = 1 está en 0xfffff422526c
n = 0 está en 0xfffff422523c
al volver, n sigue siendo 1
al volver, n sigue siendo 2
al volver, n sigue siendo 3
niveles: 3
Hay dos cosas que observar. Las direcciones bajan, porque en este entorno la pila crece hacia las direcciones
menores. Y están a 0x30 de distancia, es decir a 48 bytes: en esta máquina, y con este compilador, cada llamada a
count_down gasta 48 bytes de pila. Guarden ese número, porque volverá. Lo que no cambia es lo que dice la
última parte: al volver, cada marco encuentra su n intacto, porque nadie más lo tocó.
Los marcos en gdb
gdb muestra esta misma pila. Para eso se compila con -g -O0 y sin sanitizers. Ya conocen backtrace, frame,
info args, info locals y finish. Hay una herramienta nueva, que en una recursión hace mucha falta: un
breakpoint condicional. Con break factorial, el programa se detendría en cada llamada. Con break factorial if n == 1, se detiene solo en la llamada que nos interesa:
$ gcc -Wall -Wextra -std=c17 -g -O0 factorial.c -o build/factorial_gdb$ gdb -q build/factorial_gdb
Reading symbols from build/factorial_gdb...
(gdb) break factorial if n == 1
Breakpoint 1 at 0x7b4: file factorial.c, line 5.
(gdb) run
Starting program: .../build/factorial_gdb
Breakpoint 1, factorial (n=1) at factorial.c:5
5 if (n <= 1) {
(gdb) backtrace
#0 factorial (n=1) at factorial.c:5
#1 0x0000aaaaaaaa07d4 in factorial (n=2) at factorial.c:8
#2 0x0000aaaaaaaa07d4 in factorial (n=3) at factorial.c:8
#3 0x0000aaaaaaaa07d4 in factorial (n=4) at factorial.c:8
#4 0x0000aaaaaaaa07fc in main () at factorial.c:13
(gdb) frame 2
#2 0x0000aaaaaaaa07d4 in factorial (n=3) at factorial.c:8
8 long long rest = factorial(n - 1);
(gdb) info args
n = 3
(gdb) frame 0
#0 factorial (n=1) at factorial.c:5
5 if (n <= 1) {
(gdb) finish
Run till exit from #0 factorial (n=1) at factorial.c:5
0x0000aaaaaaaa07d4 in factorial (n=2) at factorial.c:8
8 long long rest = factorial(n - 1);
Value returned is $1 = 1
(gdb) next
9 return n * rest;
(gdb) info locals
rest = 1
(gdb) delete 1
(gdb) continue
Continuing.
factorial(4) = 24
[Inferior 1 (process 111) exited normally]backtrace es el dibujo de arriba, con el marco más reciente como #0. Los tres marcos intermedios están detenidos
en la línea 8, la de la llamada, porque ninguno ha terminado esa línea. frame 2 no cambia la ejecución: solo elige
qué marco mirar, y ahí n vale 3. finish termina el marco actual y dice qué devolvió, y después de next se
ve el valor en el rest del marco de n = 2.
Idea clave. Una llamada recursiva no “vuelve al inicio” de la función. Crea un marco nuevo y deja el anterior esperando, con sus variables intactas. Nada se comparte entre marcos, salvo lo que se pase por parámetro: un valor, o un puntero.
El salto de fe
Seguir cada llamada funciona para factorial(4). Para un arreglo de mil elementos, nadie lo hace, ni hace falta.
Hay una forma de convencerse de que una función recursiva es correcta sin bajar: se le llama el salto de fe
(leap of faith). Consiste en suponer que la llamada recursiva da la respuesta correcta a su problema más pequeño, y
comprobar solo lo que hace esta llamada con esa respuesta.
Tomemos count_negative de array_examples.c, que cuenta los negativos de un arreglo:
static size_t count_negative(const int *a, size_t n) {
    if (n == 0) {
        return 0;
    }
    size_t rest = count_negative(a + 1, n - 1);
    if (a[0] < 0) {
        return rest + 1;
    }
    return rest;
}
Para convencerse de que está bien, se responden tres preguntas. Ninguna pide seguir las llamadas:
- ¿Los casos base son correctos? Un arreglo vacío tiene 0 negativos. Sí.
- ¿Cada llamada se acerca a un caso base?
nes un entero que nunca es negativo, y baja de 1 en 1 hasta 0. Sí. - Si la llamada recursiva acierta, ¿esta llamada acierta? Supongamos que
restes el número de negativos desdea[1]. Los negativos de todo el arreglo son esos, más uno sia[0]es negativo. Eso es lo que devuelve. Sí.
Y eso es todo. Con esas tres respuestas, la función es correcta para cualquier n, sin haber escrito ningún
rastro.
Por qué no es magia: la inducción
Parece trampa: usamos la función para justificar la función. No lo es, y la razón es una que ya conocen de matemáticas,
la inducción. Para demostrar algo para todo n, se demuestra para 0, y se demuestra que, si vale para n - 1,
vale para n. Las tres preguntas son exactamente eso:
| Inducción | Función recursiva |
|---|---|
| Vale para 0 | La pregunta 1: el caso base |
Si vale para n - 1, vale para n |
La pregunta 3: el salto de fe |
Se llega de cualquier n a 0 |
La pregunta 2: el problema se achica |
El argumento completo es una cadena: count_negative acierta con n = 0, por la pregunta 1. Entonces acierta con
n = 1, por la pregunta 3. Entonces con n = 2. Y así hasta el n que quieran. Lo que suponen ustedes en el salto
de fe, la inducción ya lo garantizó.
Esto también dice qué vigilar. El salto de fe solo es válido si la pregunta 2 tiene respuesta. Sin ella, se supone algo sobre un problema que no es más pequeño, y el razonamiento no prueba nada: la función simplemente no termina.
Error común. Tratar de entender una función recursiva bajando mentalmente tres o cuatro niveles. Se pierde el hilo, y no prueba nada para el nivel cinco. Escriban primero qué promete la función, en un comentario, y usen esa promesa en la llamada recursiva como si fuera
strlen. Sigan las llamadas una por una solo cuando busquen un bug, y con un caso pequeño.
Termina si algo baja
La pregunta 2 merece más cuidado. Para saber que una función termina, busquen un número entero que no pueda ser negativo y que baje en cada llamada. Como no se puede bajar para siempre sin llegar a negativo, tiene que llegar un momento en que no haya más llamadas.
| Función | Lo que baja | Hasta dónde |
|---|---|---|
factorial |
n |
1 o menos |
count_negative |
n, elementos que quedan |
0 |
| Un palíndromo, por los dos extremos | caracteres que quedan, de 2 en 2 | 0 o 1 |
| Búsqueda binaria | elementos del rango, al menos a la mitad | 0 |
Fíjense en lo del palíndromo: si baja de 2 en 2, el caso base tiene que atajar tanto el 0 como el 1. Si solo atajara el 0, un largo impar se lo saltaría. Veremos ese error de verdad más adelante.
Recursión en arreglos
Un arreglo se puede ver como “el primer elemento, y el resto”. El resto es un arreglo más corto, del mismo tipo, y por eso sirve la recursión. En pseudocódigo, el resto se indica con un índice, por ejemplo para la suma:
algoritmo suma(a, i, n)
    si i = n entonces
        devolver 0
    fin si
    devolver a[i] + suma(a, i + 1, n)
fin algoritmo
La llamada inicial es suma(a, 0, n). En C no hace falta ese parámetro de más, porque se tiene aritmética de punteros, la
de la semana 4: a + 1 es un puntero al segundo elemento, y a + 1 con n - 1 elementos es el resto del arreglo,
listo para pasarlo.
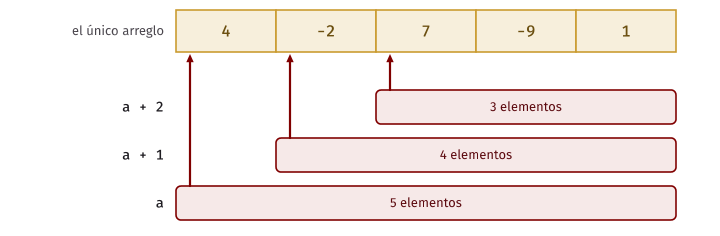
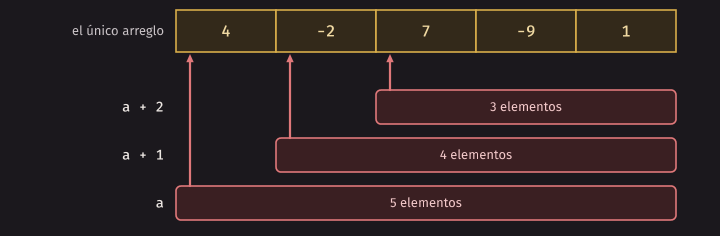
No se copia nada. Las cinco llamadas miran el mismo arreglo, cada una desde un punto más adelante. Lo único que
ocupa memoria son los marcos. El const del parámetro const int *a dice que la función no lo modifica, y sigue
valiendo en cada llamada.
Corramos count_negative a mano con {4, -2, 7}, en el orden en que se termina cada llamada:
| Llamada | Elementos que ve | rest |
a[0] < 0 |
Devuelve |
|---|---|---|---|---|
count_negative(a + 3, 0) |
ninguno | 0 | ||
count_negative(a + 2, 1) |
7 | 0 | no | 0 |
count_negative(a + 1, 2) |
-2, 7 | 0 | sí | 1 |
count_negative(a, 3) |
4, -2, 7 | 1 | no | 1 |
El caso base depende de la pregunta
¿El caso base siempre es el arreglo vacío? No. Para contar o sumar, sí, porque un arreglo vacío tiene respuesta: 0. Para
el mínimo, no: un arreglo vacío no tiene mínimo. Por eso array_min exige n >= 1, y su caso base es un solo
elemento:
static int array_min(const int *a, size_t n) {
    if (n == 1) {
        return a[0];
    }
    int rest = array_min(a + 1, n - 1);
    if (a[0] < rest) {
        return a[0];
    }
    return rest;
}
Las tres preguntas: un elemento es su propio mínimo; n baja de 1 en 1 hasta 1, si empezó en 1 o más; y si rest es
el mínimo del resto, el mínimo de todo es el menor entre a[0] y rest.
La tentación es poner un caso base con n == 0 que devuelva 0, para que parezca más general. Ese error compila, no se
cae y da mal el resultado, y lo veremos en la sección de depuración.
Dos extremos a la vez
No siempre se quita un solo elemento. is_symmetric mira si un arreglo se lee igual desde los dos lados, y en cada paso
quita dos, el primero y el último:
static int is_symmetric(const int *a, size_t n) {
    if (n <= 1) {
        return 1;
    }
    if (a[0] != a[n - 1]) {
        return 0;
    }
    return is_symmetric(a + 1, n - 2);
}
Tiene dos formas de terminar sin llamar: se acabaron los elementos, y entonces es simétrico, o hay un par distinto, y entonces no lo es. Eso no es raro: una función puede tener varios casos base. Aquí la segunda respuesta hace que la función ni siquiera mire el resto, porque ya se sabe.
Error común. Escribir
if (n == 0)como único caso base cuandonbaja de 2 en 2. Conn = 1, la llamada usan - 2, y comosize_tno tiene negativos, el resultado es un número enorme. Lo mismo pasa con cualquiersize_t: antes de restarle algo, asegúrense de que alcanza.
Recursión en cadenas
Una cadena es aún más natural para esto, porque ella sola dice dónde termina. Si s es una cadena, s + 1 es otra cadena,
más corta, y el caso base es encontrar el '\0':
static size_t string_length(const char *s) {
    if (s[0] == '\0') {
        return 0;
    }
    return 1 + string_length(s + 1);
}
array_examples.c corre estas funciones con estos datos: {4, -2, 7, -9, 1} y {3, 8, 8, 3}.
$ build/array_examples
negativos: 2
mínimo: -9
data simétrico: 0
mirror simétrico: 1
largo de "Chosica": 7
largo de "": 0
Un palíndromo
Un palíndromo se lee igual en los dos sentidos: reconocer, abba. La definición ya es recursiva: una cadena es
palíndromo si su primer carácter es igual al último, y lo de en medio también es palíndromo. Para indicar “lo de en medio”
hacen falta dos índices, así que el algoritmo tiene más parámetros que el problema:
algoritmo es_palindromo(s, i, j)
    si i ≥ j entonces
        devolver 1
    fin si
    si s[i] ≠ s[j] entonces
        devolver 0
    fin si
    devolver es_palindromo(s, i + 1, j - 1)
fin algoritmo
La llamada inicial es con i = 0 y j igual al largo menos 1. Con abcba:
| Llamada | i |
j |
s[i], s[j] |
Qué pasa |
|---|---|---|---|---|
| 1 | 0 | 4 | a, a |
iguales: sigue |
| 2 | 1 | 3 | b, b |
iguales: sigue |
| 3 | 2 | 2 | i ≥ j: devuelve 1 |
¿Cómo saben que termina? Lo que baja es j - i, de 2 en 2. Cuando ya no es positivo, i ≥ j detiene la recursión, sea
que el largo era par o impar. Y no hace falta bajar más: un carácter es palíndromo de sí mismo.
Una función auxiliar. A quien usa la función no le interesan i y j. Quiere escribir is_palindrome("abba"). Lo normal
es separar las dos cosas: una función pública, con la interfaz simple, y una auxiliar static, con los parámetros que hagan
falta para la recursión. La función pública solo prepara la primera llamada. En lab/counted.c, linear_search es así:
static long search_from(const int *a, size_t n, size_t i, int value, long *calls) {
    *calls = *calls + 1;
    if (i == n) {
        return -1;
    }
    if (a[i] == value) {
        return (long) i;
    }
    return search_from(a, n, i + 1, value, calls);
}
Esa auxiliar lleva un parámetro i que el problema original no tiene. Es muy común, y lo usarán en el laboratorio.
En C. En
is_palindromeno llamen astrlendentro de la recursión. Calcularla una vez en la función pública y pasarla a la auxiliar es lo natural: si no, se recorre la cadena completa en cada llamada, para obtener algo que no cambia.
Búsqueda binaria
La búsqueda binaria de Introducción a la Computación se escribía con un ciclo. Es uno de los algoritmos que mejor se dicen con recursión: si el valor está, o está en la mitad, o está en la parte que queda a un lado. Solo se usa si el arreglo está ordenado, porque se aprovecha eso para descartar toda una mitad con una sola comparación.
Usaremos un rango semiabierto [lo, hi): lo entra y hi no. Tiene dos ventajas. El rango vacío es simplemente lo = hi. Y
las cuentas no restan 1, lo que importa con size_t.
algoritmo buscar(a, lo, hi, valor)
    si lo ≥ hi entonces
        devolver -1
    fin si
    mid ← lo + (hi - lo) div 2
    si a[mid] = valor entonces
        devolver mid
    sino si a[mid] < valor entonces
        devolver buscar(a, mid + 1, hi, valor)
    sino
        devolver buscar(a, lo, mid, valor)
    fin si
fin algoritmo
La llamada inicial es buscar(a, 0, n, valor). Sigámosla con {7, 9, 14, 18, 22, 25, 31}, buscando el 25 y luego el 10:
| Buscando | Llamada | Rango | mid |
a[mid] |
Qué hace |
|---|---|---|---|---|---|
| 25 | 1 | [0, 7) |
3 | 18 | menor: sigue a la derecha |
| 25 | 2 | [4, 7) |
5 | 25 | lo encontró: devuelve 5 |
| 10 | 1 | [0, 7) |
3 | 18 | mayor: sigue a la izquierda |
| 10 | 2 | [0, 3) |
1 | 9 | menor: sigue a la derecha |
| 10 | 3 | [2, 3) |
2 | 14 | mayor: sigue a la izquierda |
| 10 | 4 | [2, 2) |
vacío: devuelve -1 |
Las tres preguntas. El caso base: un rango vacío no contiene nada. La terminación: lo que baja es hi - lo. Con mid siempre
dentro del rango, tanto [lo, mid) como [mid + 1, hi) son estrictamente más cortos. Y el salto de fe: si el arreglo está
ordenado y a[mid] es menor que el valor, el valor no puede estar a la izquierda, así que la respuesta de la derecha es la
respuesta de todo.
Error común. Llamar con
buscar(a, mid, hi, valor)en vez demid + 1. El rango[lo, lo + 1)tienemid = lo, y la llamada recibe exactamente el mismo rango: el problema no se achica, y la pila se acaba. Se responde la pregunta 2 y se encuentra el bug sin correr nada.
En C.
midse calcula comolo + (hi - lo) / 2, y no como(lo + hi) / 2. La suma de dos índices muy grandes podría no caber, yhi - lonunca es mayor que el tamaño del arreglo.
El código en C es parte del laboratorio. Son pocas líneas, y se deducen de este algoritmo.
Contar las llamadas
Dos funciones pueden dar el mismo resultado y costar muy distinto. Lo vamos a medir de la manera más simple: contando cuántas llamadas hace cada una. Aquí no calculamos ninguna fórmula: eso es de Estructuras de Datos y Algoritmos. Solo contamos.
¿Cómo cuenta una función sus propias llamadas, si las variables globales están prohibidas? Con lo que aprendieron en la semana 4:
un puntero a un contador, que crea quien llama. Es el mismo contador para todos los marcos, porque todos reciben la
misma dirección. Esta es power_slow de lab/counted.c, la versión que sale directo de la definición, b a la n es b
por b a la n - 1:
long long power_slow(long long base, int n, long *calls) {
    *calls = *calls + 1;
    if (n == 0) {
        return 1;
    }
    return base * power_slow(base, n - 1, calls);
}
Hace una llamada por cada valor desde n hasta 0, o sea n + 1 llamadas. Pero hay un atajo. 2^10 es 2^5 por 2^5. Y 2^5,
que es impar, es 2^2 por 2^2 por 2. Si n se parte por la mitad cada vez, el problema baja muy rápido:
algoritmo potencia_rapida(base, n)
    si n = 0 entonces
        devolver 1
    fin si
    mitad ← potencia_rapida(base, n div 2)
    resultado ← mitad * mitad
    si n mod 2 = 1 entonces
        resultado ← resultado * base
    fin si
    devolver resultado
fin algoritmo
Con base = 2 y n = 10, en el orden en que termina cada llamada:
| Llamada | n |
mitad |
mitad * mitad |
¿n impar? |
Devuelve |
|---|---|---|---|---|---|
| 5 | 0 | 1 | |||
| 4 | 1 | 1 | 1 | sí | 2 |
| 3 | 2 | 2 | 4 | no | 4 |
| 2 | 5 | 4 | 16 | sí | 32 |
| 1 | 10 | 32 | 1024 | no | 1024 |
Son 5 llamadas en vez de 11. Con exponentes más grandes, la diferencia crece. lab/demo.c compara las dos versiones, y las de
búsqueda, cuando el laboratorio está terminado. Con la solución escribe esto:
$ build/lab/demo
power(2, 10): lenta 1024 con 11 llamadas, rápida 1024 con 5 llamadas
power(2, 62): lenta 4611686018427387904 con 63 llamadas, rápida 4611686018427387904 con 7 llamadas
power(1, 1024): lenta 1 con 1025 llamadas, rápida 1 con 12 llamadas
buscar 19998 en 10000: lineal da 9999 con 10000 llamadas, binaria da 9999 con 13 llamadas
buscar 7 en 10000: lineal da -1 con 10001 llamadas, binaria da -1 con 14 llamadas
31 18 25 9 22 7 14
7 9 14 18 22 25 31
La versión rápida de power(1, 1024) hace 12 llamadas: n pasa por 1024, 512, 256, 128, 64, 32, 16, 8, 4, 2, 1 y 0. La lenta
hace 1025. Y la búsqueda binaria en 10 000 elementos hace 13 o 14, frente a unas 10 000 de la lineal.
¿Por qué power(1, 1024) y no power(2, 1024)? Porque el número de llamadas no depende de la base, y 2^1024 no cabe
en un long long. errors/power_too_big.c lo muestra con UBSan. Aquí la salida se capturó en una tubería, por eso el aviso de
UBSan sale primero; en su terminal saldrá después de la línea de 2^62:
$ gcc -Wall -Wextra -std=c17 -g -fsanitize=address,undefined errors/power_too_big.c -o build/power_too_big
$ build/power_too_big
errors/power_too_big.c:8:17: runtime error: signed integer overflow: 2 * 4611686018427387904 cannot be represented in type 'long long int'
2^62 = 4611686018427387904
2^1024 = 0
El valor 0 salió en esta corrida, pero es comportamiento indefinido, como en la semana 7: no significa nada. UBSan avisa una
sola vez por cada línea de código, aunque el overflow ocurra muchas veces. Contar llamadas de power(2, 1024) tiene sentido. Usar su
resultado, no.
Un atajo que no ahorra nada
Esta versión parece igual a la rápida, y da el resultado correcto:
long long result = power_twice(base, n / 2, calls) * power_twice(base, n / 2, calls);La diferencia es que llama dos veces con el mismo argumento, en vez de guardar el resultado en una variable. Miren lo que pasa:
$ gcc -Wall -Wextra -std=c17 errors/power_twice.c -o build/power_twice
$ build/power_twice
power_twice(1, 10) = 1, llamadas: 31
power_twice(1, 100) = 1, llamadas: 255
power_twice(1, 1024) = 1, llamadas: 4095
¡4095 llamadas, contra 12 de la rápida y 1025 de la lenta! Cada llamada hace otras dos, y cada una de esas otras dos. La rápida hace un solo camino de llamadas, mientras que esta hace un árbol. Las funciones en que cada llamada hace varias son el tema de la semana 10.
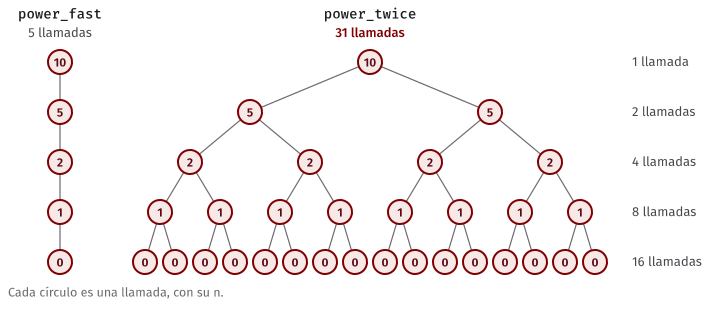
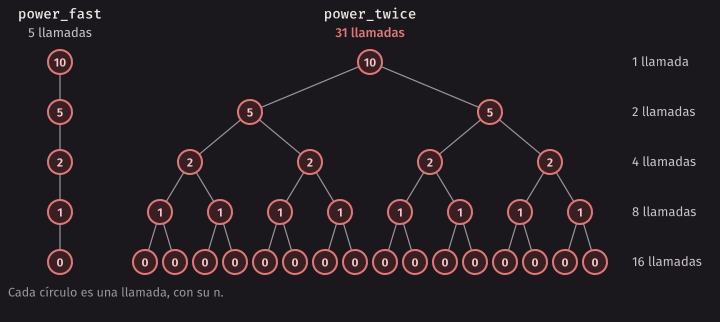
Idea clave. Una variable local que guarda el resultado de una llamada no es un detalle de estilo. Calcular dos veces lo que ya se tiene se paga en cada nivel de la recursión.
Ordenar por mezcla
Hasta ahora, cada función hacía una sola llamada recursiva. Veamos un algoritmo que hace dos, y que además usa memoria dinámica. El ordenamiento por mezcla (merge sort) es la recursión en su forma más limpia:
- Si el arreglo tiene 0 o 1 elementos, ya está ordenado.
- Si no, se parte por la mitad, y se ordena cada mitad con esta misma función.
- Se mezclan las dos mitades ordenadas en una sola.
algoritmo ordenar(a, lo, hi, scratch)
    si hi - lo < 2 entonces
        devolver
    fin si
    mid ← lo + (hi - lo) div 2
    ordenar(a, lo, mid, scratch)
    ordenar(a, mid, hi, scratch)
    mezclar(a, lo, mid, hi, scratch)
fin algoritmo
El rango es semiabierto, como en la búsqueda binaria. En C no hacen falta lo y hi: a + mid con n - mid elementos es la mitad derecha, igual
que en los ejemplos de arreglos. Por eso sort_range del laboratorio solo recibe a, n y scratch.
El salto de fe se ve muy bien aquí. Nadie necesita saber cómo se ordena cada mitad: basta con que ordenar cumpla su promesa con
un problema más pequeño. Todo el trabajo real está en mezclar.
Mezclar dos mitades ordenadas
Mezclar es como juntar dos filas ya ordenadas: siempre se mira el primero de cada fila, y sale el menor. Hace falta un lugar donde
dejar el resultado, porque si se escribe sobre a se pierden datos que aún no se han leído. Ese lugar se llama scratch.
algoritmo mezclar(a, lo, mid, hi, scratch)
    izq ← lo
    der ← mid
    k ← 0
    mientras izq < mid y der < hi hacer
        si a[izq] ≤ a[der] entonces
            scratch[k] ← a[izq]
            izq ← izq + 1
        sino
            scratch[k] ← a[der]
            der ← der + 1
        fin si
        k ← k + 1
    fin mientras
    mientras izq < mid hacer
        scratch[k] ← a[izq]
        izq ← izq + 1
        k ← k + 1
    fin mientras
    mientras der < hi hacer
        scratch[k] ← a[der]
        der ← der + 1
        k ← k + 1
    fin mientras
    para i desde 0 hasta k - 1 hacer
        a[lo + i] ← scratch[i]
    fin para
fin algoritmo
Sigamos el último paso del ejemplo del laboratorio, con {18, 25, 31} a la izquierda y {7, 9, 14, 22} a la derecha:
a[izq] |
a[der] |
Sale | scratch hasta ahora |
|---|---|---|---|
| 18 | 7 | 7 | 7 |
| 18 | 9 | 9 | 7 9 |
| 18 | 14 | 14 | 7 9 14 |
| 18 | 22 | 18 | 7 9 14 18 |
| 25 | 22 | 22 | 7 9 14 18 22 |
| 25 | se acabó la derecha | 7 9 14 18 22 25 31 |
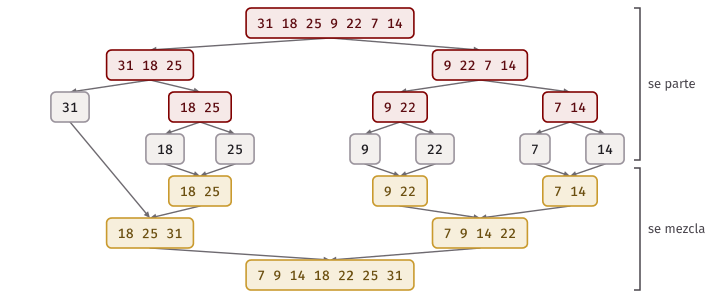
Y el árbol completo de {31, 18, 25, 9, 22, 7, 14}. Se lee bajando hasta los elementos sueltos, y subiendo con las mezclas:
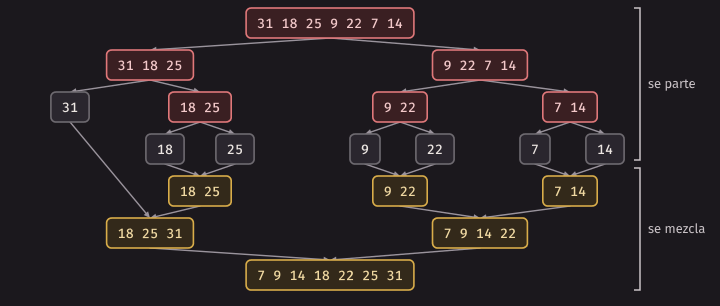
¿Quién es owner de scratch?
Aquí vuelve la pregunta de la semana 5. merge necesita memoria auxiliar. Hay dos formas de conseguirla:
- Que cada
mergehaga su propiomallocy sufree. Funciona, pero se pide memoria miles de veces, y cada pedido puede fallar en medio de la recursión. - Que una función pública reserve de una vez un bloque de
nenteros, y se lo pase a la recursión. Las llamadas lo usan por turnos, y nunca lo liberan.
Usaremos la segunda. El reparto queda claro: merge_sort es owner de scratch. La recursión, sort_range, solo lo presta. Sigue la
misma estructura de la función pública y la auxiliar que vimos en el palíndromo:
int merge_sort(int *a, size_t n);merge_sort debe cuidar tres cosas. Un arreglo con menos de 2 elementos no necesita memoria, y además malloc(0) puede devolver
NULL sin que falte nada. Si malloc falla, devuelve 0 y no toca nada. Y el free se hace una sola vez, al final, en esa función.
¿Se llena la pila? No. El arreglo se parte por la mitad en cada nivel, así que para un millón de elementos son unos 20 niveles apilados, aunque se hagan muchas llamadas en total.
Recursión e iteración
Todo lo que se hace con un ciclo se puede hacer con recursión, y al revés. La pregunta interesante es qué cuesta cada uno.
De ciclo a recursión
Un ciclo tiene variables que cambian en cada vuelta. Una función recursiva no las cambia: llama de nuevo con otros valores. Las variables del ciclo se vuelven parámetros. Lo vemos con el algoritmo de Euclides, para el máximo común divisor:
static int gcd_recursive(int a, int b) {
    if (b == 0) {
        return a;
    }
    return gcd_recursive(b, a % b);
}

static int gcd_loop(int a, int b) {
    while (b != 0) {
        int next_b = a % b;
        a = b;
        b = next_b;
    }
    return a;
}
La condición del ciclo se niega y se vuelve el caso base, y la llamada es el paso del ciclo. Aquí la conversión es directa, porque
en gcd_recursive la llamada recursiva es lo último que se hace: al volver, no queda nada pendiente, solo devolver lo que llegó.
Si queda algo pendiente
En sum_recursive, en cambio, después de la llamada falta la suma:
static long long sum_recursive(int n) {
    if (n <= 0) {
        return 0;
    }
    return n + sum_recursive(n - 1);
}
Para convertirla a un ciclo, se puede pasar lo pendiente por adelantado, con un parámetro más. Se llama acumulador: va juntando lo calculado hasta ahora, y al llegar al caso base ya está la respuesta. Ese es el paso intermedio entre las dos:
static long long sum_accumulator(int n, long long total) {
    if (n <= 0) {
        return total;
    }
    return sum_accumulator(n - 1, total + n);
}

static long long sum_loop(int n) {
    long long total = 0;
    while (n > 0) {
        total = total + n;
        n = n - 1;
    }
    return total;
}
sum_accumulator y sum_loop hacen las mismas cuentas, en el mismo orden. total es el acumulador en las dos, y la llamada inicial
sum_accumulator(100, 0) es la línea long long total = 0;.
$ build/convert
mcd(252, 105): 21 y 21
suma hasta 100: 5050, 5050 y 5050
Antes y después de la llamada
Lo que se hace antes de la llamada ocurre al bajar, y lo que se hace después, al volver. Eso permite resolver problemas que con un
ciclo cuestan más. En digits.c, estas dos funciones se diferencian solo en el orden de dos líneas:
static void print_backward(int n) {
    printf("%d", n % 10);
    if (n >= 10) {
        print_backward(n / 10);
    }
}

static void print_forward(int n) {
    if (n >= 10) {
        print_forward(n / 10);
    }
    printf("%d", n % 10);
}
$ build/digits
6202
2026Con un número, n % 10 da la última cifra, y n / 10 quita esa cifra. Las cifras salen de atrás hacia adelante, así que para
escribirlas en orden con un ciclo habría que guardarlas primero en un arreglo. print_forward no necesita eso: sus n quedan guardadas
en los marcos que están esperando. La pila hace de arreglo.
Qué cuesta cada uno
| Ciclo | Recursión | |
|---|---|---|
| Memoria | Fija: sus variables | Un marco por cada nivel apilado |
| Si es muy profundo | No pasa nada | Se acaba la pila, y el programa cae |
| Estado | Variables que cambian | Parámetros en cada llamada |
| Volver atrás | Hay que guardar los datos | Lo hacen los marcos |
| Varias ramas | Hay que manejar una pila a mano | Natural |
Una regla práctica:
- Prefieran un ciclo cuando la recursión solo avanza por un dato, de uno en uno: sumar un arreglo, contar en una cadena, recorrer una lista. Son fáciles con un ciclo, y su profundidad es igual al tamaño de la entrada, que normalmente no controlan.
- Prefieran la recursión cuando el problema se parte en varios subproblemas, o cuando la profundidad es pequeña: búsqueda binaria, ordenar por mezcla, y lo que viene en la semana 10.
En esta semana harán con recursión cosas que en un programa real se harían con un ciclo. Es para practicar en casos donde pueden comprobar el resultado. No es una recomendación de hacerlo así.
La pila no es infinita
Cada marco ocupa memoria, y la pila tiene un tamaño fijo. Ya vieron que se puede acabar. En la semana 5, errors/big_local.c la llenó con
un solo arreglo enorme. Con recursión, se llena marco por marco. Eso es un stack overflow.
Sin caso base
static long long sum_down(int n) {
    return n + sum_down(n - 1);
}
En este caso tan directo, gcc lo detecta, pero solo es una advertencia:
$ gcc -Wall -Wextra -std=c17 errors/no_base_case.c -o build/no_base_case
errors/no_base_case.c: In function 'sum_down':
errors/no_base_case.c:4:18: warning: infinite recursion detected [-Winfinite-recursion]
    4 | static long long sum_down(int n) {
      |                  ^~~~~~~~
errors/no_base_case.c:5:16: note: recursive call
    5 |     return n + sum_down(n - 1);
      |                ^~~~~~~~~~~~~~~
Al correrlo con ASan, el informe le pone nombre. Es un extracto, y las direcciones y los números de marco cambian:
$ gcc -Wall -Wextra -std=c17 -g -fsanitize=address,undefined errors/no_base_case.c -o build/no_base_case_san 2>/dev/null$ build/no_base_case_san
AddressSanitizer:DEADLYSIGNAL
=================================================================
==122==ERROR: AddressSanitizer: stack-overflow on address 0xffffcb335fe0 (pc 0xaaaab2750d28 bp 0xffffcb336010 sp 0xffffcb336010 T0)
#0 0xaaaab2750d28 in sum_down errors/no_base_case.c:4
#1 0xaaaab2750d64 in sum_down errors/no_base_case.c:5
#2 0xaaaab2750d64 in sum_down errors/no_base_case.c:5
...
SUMMARY: AddressSanitizer: stack-overflow errors/no_base_case.c:4 in sum_downLo que importa está en dos lugares. La primera línea dice qué pasó: stack-overflow. Y la lista de marcos dice dónde: la misma
función y la misma línea, repetidas muchas veces. Eso se reconoce de inmediato: si los marcos se repiten, es una recursión sin
freno. ASan muestra los primeros marcos, y corta la lista.
En C. Si en un Codespace, que corre en x86-64, el programa muere con
Segmentation faultsin mostrar el informe, córranlo otra vez. En este entorno, en ARM, no nos ha pasado, pero en Introducción a la Computación vimos que en x86-64 emulado ocurría en unas 3 de cada 10 corridas.
En gdb
Sin sanitizers, el programa solo dice Segmentation fault. gdb muestra dónde, pero hay que tener cuidado: un backtrace común
querría imprimir todos los marcos, y son muchísimos. Si les pasa, gdb les pregunta cada tanto si quieren seguir, y basta con
responder q. Por eso se le pasa un número: backtrace 3 muestra los 3 más recientes, y backtrace -3 los 3 más antiguos.
$ gcc -Wall -Wextra -std=c17 -g -O0 errors/no_base_case.c -o build/no_base_case_gdb 2>/dev/null$ gdb -q build/no_base_case_gdb
Reading symbols from build/no_base_case_gdb...
(gdb) run
Starting program: .../build/no_base_case_gdb
Program received signal SIGSEGV, Segmentation fault.
sum_down (n=0) at errors/no_base_case.c:4
4 static long long sum_down(int n) {
(gdb) backtrace 3
#0 sum_down (n=0) at errors/no_base_case.c:4
#1 0x0000aaaaaaaa07c8 in sum_down (n=-174726) at errors/no_base_case.c:5
#2 0x0000aaaaaaaa07c8 in sum_down (n=-174725) at errors/no_base_case.c:5
(More stack frames follow...)
(gdb) backtrace -3
#174731 0x0000aaaaaaaa07c8 in sum_down (n=4) at errors/no_base_case.c:5
#174732 0x0000aaaaaaaa07c8 in sum_down (n=5) at errors/no_base_case.c:5
#174733 0x0000aaaaaaaa07e8 in main () at errors/no_base_case.c:9Las dos puntas cuentan toda la historia. backtrace -3 muestra cómo empezó: main llamó con n = 5, luego 4. backtrace 3 muestra
cómo terminó: n iba por -174726, muy lejos de cualquier caso razonable. Si en una recursión los parámetros se alejan del caso base,
ahí está el bug. El n que muestra el marco #0 no sirve: la llamada acababa de entrar y no llegó a guardar su parámetro, así que según la corrida verán otro número, o <error reading variable>.
backtrace -3 tardó unos 17 segundos en esta máquina, porque gdb tiene que recorrer todos los marcos. Tengan paciencia. Y si el programa recibe argumentos en la línea de comandos, se los pasan a run: run recursive 1000000.
¿Y el número? Son unos 174 700 marcos. En este entorno, ulimit -s dice que la pila tiene 8192 KB. En gdb, dos marcos seguidos de
sum_down también están a 48 bytes de distancia, así que caben 8192 × 1024 / 48 = 174 762. La cuenta coincide. Estos números dependen de la máquina y del compilador:
en otra arquitectura el marco puede ser más chico o más grande, y cambian un poco en cada corrida, porque el sistema arranca la pila
en un punto algo distinto. Lo que no cambia es que hay un límite.
Con un caso base que nunca llega
Tener un caso base no basta. Este programa lo tiene, y gcc no avisa nada, porque hay un camino que termina:
static int half_steps(int n) {
    if (n == 0) {
        return 0;
    }
    return 1 + half_steps(n - 2);
}
Con 6 baja por 6, 4, 2 y 0. Con 7 baja por 7, 5, 3, 1, -1, y nunca toca el 0. El informe es el mismo de antes, y lo que falla es la pregunta 2 de
las tres: ¿cada llamada se acerca a un caso base? Sí se achica el número, pero no se acerca a n == 0 cuando es impar. La
corrección es n <= 0: la misma razón por la que el factorial usa n <= 1, y no n == 1.
$ gcc -Wall -Wextra -std=c17 errors/skipped_base.c -o build/skipped_baseCon un caso base correcto y demasiado profundo
deep_sum.c tiene una suma recursiva sin ningún error de lógica. Solo es profunda. build/deep_plain la compila sin sanitizers. Estos números
dependen de la máquina, y aquí bash agrega el número de proceso porque la salida se capturó:
$ gcc -Wall -Wextra -std=c17 -g -O0 deep_sum.c -o build/deep_plain
$ build/deep_plain recursive 170000
14450085000
$ build/deep_plain recursive 180000; echo "estado: $?"
bash: line 1:    10 Segmentation fault      build/deep_plain recursive 180000
estado: 139
$ build/deep_plain loop 10000000
50000005000000
Con la versión recursiva, el límite en esta máquina estuvo cerca de 174 700. Y es un límite bajo: un arreglo de un millón de enteros, recorrido de a uno por recursión, no entra. El ciclo, en cambio, llega a 10 millones sin gastar ni un marco más. Esto es lo que hay detrás de la regla práctica de la sección anterior.
Lo que hace -O2
En la semana 7 vimos que con -O2 el compilador cambia el programa, siempre que el resultado sea el permitido por el lenguaje. Aquí también:
$ gcc -Wall -Wextra -std=c17 -O2 deep_sum.c -o build/deep_o2
$ build/deep_o2 recursive 10000000
50000005000000
¡Con -O2 funciona! gcc se dio cuenta de que esa suma se podía hacer con un ciclo, y eliminó la recursión. La misma optimización le da otro
efecto a errors/no_base_case.c. Con este gcc, el programa ya no cae: se queda dando vueltas para siempre, sin gastar pila. El comando timeout 2 corre un
programa y lo detiene a los 2 segundos, y el estado 124 significa justamente eso:
$ gcc -Wall -Wextra -std=c17 -O2 errors/no_base_case.c -o build/no_base_case_o2 2>/dev/null
$ timeout 2 build/no_base_case_o2; echo "estado: $?"
estado: 124
No cuenten con esto. El lenguaje no lo garantiza, cada compilador decide, y un cambio pequeño en la función lo puede cancelar. Por eso todo el
laboratorio se compila sin -O2, y por eso sus pruebas verán la recursión como es.
Idea clave. La pila aguanta unos cientos de miles de llamadas simples, no millones. Si la profundidad depende de lo que entre el usuario, la recursión lineal es una forma de que el programa se caiga. Si la profundidad crece lento, como en una búsqueda binaria, no hay de qué preocuparse.
Depurar recursión
Primero, los casos base
Una función recursiva se apoya en sus casos base. Si uno está mal, todas las respuestas se construyen sobre él. Por eso, las primeras pruebas
de una función recursiva son los casos más pequeños. Vean errors/min_base_zero.c, un array_min que devuelve 0 con el arreglo vacío:
static int array_min(const int *a, size_t n) {
    if (n == 0) {
        return 0;
    }
    int rest = array_min(a + 1, n - 1);
    if (a[0] < rest) {
        return a[0];
    }
    return rest;
}
$ gcc -Wall -Wextra -std=c17 errors/min_base_zero.c -o build/min_base_zero
$ build/min_base_zero
{5}: 0
{4, 2, 7}: 0
{4, -2, 7}: -2Compila sin advertencias, no se cae, y la última línea es correcta. Si esa hubiera sido su única prueba, habrían creído que funciona. El arreglo de un
solo elemento lo delata de inmediato: el mínimo de {5} no puede ser 0. El error se ve también en el salto de fe: el 0 del caso base no es el
mínimo de nada, solo un número inventado que después compite con los de verdad.
Una forma de trabajar
- Escriban la promesa de la función en un comentario: qué recibe, qué requiere y qué devuelve. El salto de fe se apoya en ella.
- Prueben primero lo más pequeño: vacío, un elemento, dos. Luego casos que entren por cada rama, con
assert. - Si falla, busquen el caso más pequeño que falle. Un error con 3 elementos se sigue a mano. Con 1000, no.
- Usen
gdben ese caso. Ponganbreak funcion if n == 1, o la condición que corresponda, y mirenbacktraceyinfo args. No avancen connextnivel por nivel: es lento, y se pierde el hilo. - Si la pila se acaba, miren los parámetros con
backtrace 3. Si se alejan del caso base, respondan de nuevo la pregunta 2.
Lo que dice cada síntoma
| Síntoma | Causa probable | Dónde mirar |
|---|---|---|
stack-overflow, con la misma línea repetida |
Falta caso base, o los parámetros no se acercan a él | Pregunta 2. backtrace 3 |
| Falla solo con entradas pares o impares | Un caso base que se puede saltar | ¿n == 0 debería ser n <= 0 o n <= 1? |
heap-buffer-overflow o stack-buffer-overflow |
Índice fuera de rango, o un size_t que bajó de 0 |
Las restas, y el rango que recibe cada llamada |
| Resultado equivocado, y siempre del mismo tipo | Un caso base con un valor incorrecto | Pruebas con 0 y 1 elementos |
| Funciona con pocos datos y se cae con muchos | Demasiado profundo | Conviértanla en un ciclo |
| Correcto pero muy lento | Se calcula lo mismo más de una vez | Cuenten las llamadas |
El código de esta semana
make compila los programas de la clase en build/. make test corre tres archivos de pruebas:
| Archivo | Qué comprueba |
|---|---|
test_examples.py |
Que los programas compilan sin advertencias, y lo que afirma este capítulo sobre la pila, ASan y -O2. Los límites se revisan con holgura: 1000 llamadas funcionan y 10 millones no |
test_notes.py |
Vuelve a correr los comandos de este capítulo y compara su salida. Los bloques que dependen del sistema se corren, pero no se comparan. Las sesiones de gdb y el detalle de los informes se comparan solo en ARM |
test_lab.py |
La solución del laboratorio, si está disponible |
make test-lab corre esas mismas pruebas de laboratorio sobre su código.
El laboratorio, paso a paso
Los archivos de partida están en code/week-09/lab, y su README.md tiene las preguntas y lo que pide cada sesión. make test-lab comprueba
todo: falla hasta que terminen. Aquí están las ideas, no el código.
Sesión 1
Los marcos de power(2, 3). Antes de tocar la terminal, dibujen la pila en papel, justo cuando se llega al caso base. Luego compárenla con
backtrace en gdb, usando lab/power_frames.c. Usen lo que vimos: -g -O0, sin sanitizers, y un breakpoint condicional.
Cinco funciones, sin ciclos. En lab/recursion.c, en este orden. Cada una tiene su caso base y su promesa en recursion.h.
array_sumyarray_maxsiguen lo que vimos concount_negativeyarray_min. Fíjense en quearray_sumdevuelvelong long, porque la suma de dosintgrandes no cabe en unint.count_chares comostring_length, pero con una condición.is_palindromees el algoritmo de arriba. No se puede quitar el último carácter de una cadena sin tocarla, así que hagan una auxiliarstaticcon un largo, comois_symmetric, o con dos índices.reverse_stringes la que más hay que pensar: intercambien los extremos y sigan con lo de en medio. Una auxiliar sirve aquí también.
strlen se puede usar. Escriban las pruebas en lab/recursion_tests.c, empezando por los casos más pequeños. test_array_sum es el modelo.
Sesión 2
Búsqueda binaria y power_fast. Están en lab/counted.c, y siguen los algoritmos de arriba. Como en power_slow, la primera instrucción suma
1 al contador. En power_fast el caso base es n == 0, y las pruebas lo comprueban con el número exacto de llamadas. En binary_search la que
cuenta es la auxiliar. Con eso, build/lab/demo debe escribir lo mismo que aparece en la sección “Contar las llamadas”.
merge_sort. Son tres funciones en lab/merge_sort.c: merge, sort_range y merge_sort. Escríbanlas en ese orden. Las dos primeras son static, así
que solo se pueden probar a través de la tercera. Las pruebas incluyen el caso en que malloc falla. Se compilan con ASan, así que una fuga se nota.
El stack overflow. lab/overflow.c tiene dos funciones. sum_by_twos tiene un error, que hay que encontrar leyendo el informe. sum_to está
bien, y sirve para buscar hasta dónde llega la pila en su máquina. Corrijan la primera, y no toquen la segunda.
Resumen
- Una función recursiva resuelve un problema con la solución de uno más pequeño del mismo tipo. Tiene un caso base, que responde sin llamar, y un caso recursivo.
- Cada llamada tiene su marco, con sus propias variables. Al bajar, los marcos quedan esperando. Al volver, cada uno sigue donde se quedó.
- Salto de fe: para convencerse de que una función está bien, no se siguen las llamadas. Se responden tres preguntas: ¿los casos base son correctos?, ¿cada llamada se acerca a un caso base?, y si la llamada recursiva acierta, ¿esta acierta? Es la inducción de matemáticas.
- Termina si hay un entero no negativo que baja en cada llamada. Si baja de 2 en 2, el caso base debe atajar los dos finales posibles.
- En un arreglo,
a + 1conn - 1es el resto, sin copiar nada. En una cadena,s + 1. Cuando hacen falta más parámetros, se usa una función pública y una auxiliarstatic. - El caso base depende de la pregunta: la suma de nada es 0, pero el máximo de nada no existe.
- La búsqueda binaria en un rango
[lo, hi)descarta la mitad en cada llamada.mid + 1importa: conmid, el rango puede no achicarse. - Contar llamadas mide el costo:
power(1, 1024)son 1025 llamadas con la versión lenta, 12 con la rápida. Si se llama dos veces en vez de guardar el resultado, son 4095. Y2^1024no cabe en unlong long, cualquiera sea la versión. - Ordenar por mezcla parte, ordena cada mitad y mezcla. Una sola reserva de memoria en la función pública es lo más simple: la recursión usa, y no libera.
- Todo ciclo se puede volver recursión, y al revés. Las variables del ciclo son los parámetros, y un acumulador se lleva lo pendiente. Prefieran un ciclo si solo avanza de uno en uno, y la recursión si el problema se parte.
- La pila es finita: en este entorno, 8192 KB y unas 175 mil llamadas simples, un número que depende de la máquina. Se ve como
stack-overflowen ASan. Engdbse mira conbacktrace 3ybacktrace -3, nunca conbacktracesolo. -O2puede eliminar una recursión. No cuenten con eso.- Para depurar: primero los casos base, luego el caso más pequeño que falle, y
break f if n == 1engdb.
Ejercicios
Decidan primero y ejecuten después. Todo programa revisa sus lecturas, compila sin advertencias y libera lo que reserva. Salvo que se indique otra cosa, las funciones son recursivas y sin ciclos.
-
Dibujen los marcos de
array_mincon{6, 2, 8}, justo antes de que el caso base devuelva. Escriban qué valeny a qué elemento apuntaaen cada marco. Luego compruébenlo engdbconbreak array_min if n == 1. -
Sin compilar, digan para qué valores de
ntermina cada función, cuandones unint. Luego compruébenlo con ASan.a) int f(int n) { if (n == 0) return 0; return f(n - 1); } b) int g(int n) { if (n <= 0) return 0; return g(n - 3); } c) int h(int n) { if (n == 0) return 0; return h(n / 2); } d) int k(int n) { if (n == 1) return 0; return k(n / 2); } -
Escriban
int sum_digits(int n), que suma las cifras de unnno negativo. Respondan las tres preguntas. Pruébenla conassert, empezando por el 0. -
Escriban
int is_sorted(const int *a, size_t n), que dice si un arreglo está en orden de menor a mayor. ¿Qué dos casos base tiene? ¿Cuál es el que evita leer fuera del arreglo? -
Escriban
int all_digits(const char *s), que dice si todos los caracteres son cifras. ¿Qué devuelve con la cadena vacía? Justifíquenlo. Compárenlo con lo que debería devolverany_digit(""). -
Conviertan a un ciclo:
count_negativeystring_length. Luego conviertan a recursión, con un acumulador, este ciclo:long long total = 1; for (int i = 1; i <= n; i++) { total = total * i; } -
Sin ejecutar nada, cuenten cuántas llamadas hace
power_fastconnigual a 0, 1, 7, 8 y 1000. Compruébenlo modificandodemo.c. ¿Por qué el 7 y el 8 no dan lo mismo, si están tan cerca? -
Busquen el límite de
array_sumen su máquina: reserven conmallocun arreglo denenteros en cero, y prueben valores den. Compárenlo con la versión con un ciclo. Compárenlo con el desum_toenlab/overflow.c, y compilen sin sanitizers, y luego con ellos. ¿Por qué pueden ser distintos? -
En
errors/skipped_base.c, corrijan el caso base. ¿Devuelve lo mismo con 6 y con 7? ¿Qué debería hacer con un número negativo? Decidan y escriban la promesa en un comentario. -
Agreguen a
sort_rangeun parámetrolong *calls, y cuenten sus llamadas connigual a 1, 2, 7 y 1000. Sin ejecutar, digan cuántos marcos pueden estar apilados al mismo tiempo en cada caso, y compruébenlo llevando otro contador con la profundidad. -
merge_sortaquí pide una sola vez el bloquescratch. Escriban otra versión en que cadamergepida y libere el suyo. Hagan que sumallocfalle y digan cómo se lo avisan a quien llamó. Comparen la dificultad de las dos. -
Esta función, llamada
collatz, cuenta los pasos para llegar a 1. Nadie sabe demostrar que termina para todonpositivo. ¿Cuál de las tres preguntas no se puede responder? Corran con los números del 1 al 10 000, y conlong longpara que no haya overflow, y reporten cuál da más pasos.algoritmo collatz(n) si n = 1 entonces devolver 0 fin si si n mod 2 = 0 entonces devolver 1 + collatz(n div 2) fin si devolver 1 + collatz(3 * n + 1) fin algoritmo