Apuntes · Capítulo 14Un intérprete
Análisis léxico y sintáctico
Análisis léxico y sintáctico
La semana pasada construyeron árboles de expresión llamando a los constructores a mano. Para representar
1 + 2 * x escribieron algo así:
expr_binary(OP_ADD, expr_number(1), expr_binary(OP_MUL, expr_number(2), expr_variable("x")))Funciona, pero nadie programa de esa forma. Un programa es texto, y lo primero que debe hacer un intérprete es
pasar de los caracteres 1 + 2 * x a ese árbol. Eso es lo que falta, y es el tema de hoy.
El trabajo tiene dos partes. El análisis léxico (lexing) agrupa caracteres en palabras, que llamamos tokens.
El análisis sintáctico (parsing) arma un árbol con esos tokens, siguiendo unas reglas escritas en una
gramática (grammar). Veremos cómo esas reglas deciden que 1 + 2 * 3 vale 7, y por qué una de las reglas más
naturales no se puede copiar directo a C.
Hay poco que inventar. Una vez escrita la gramática, el programa sale casi solo: una función por regla. Lo delicado es otra cosa: dar mensajes de error útiles, y no dejar fugas cuando el texto está mal. Al final de la semana tendrán un parser de expresiones del lenguaje Mini, el que vamos a interpretar. La próxima semana lo terminamos.
Ruta de lectura.
- Antes de clase (15 a 20 minutos, obligatoria): la introducción, Las etapas de un intérprete, El lenguaje Mini y Gramáticas.
- En clase: Análisis léxico, un repaso de Gramáticas, De la gramática al parser: una función por regla, Por qué
sum → sum "+" termno se puede escribir tal cual y Errores de sintaxis.- Después de clase: El laboratorio, paso a paso. Luego el Resumen y los Ejercicios. Para ir más allá: los últimos ejercicios del capítulo.
Código. Los programas de este capítulo están en
code/week-14. Dentro del entorno del curso, entren a esa carpeta y corranmakepara compilar los ejemplos,make labpara compilar el laboratorio ymake testpara comprobarlos. Los comandos de este capítulo se corren desde ahí, después de esos dosmake. Los programas deerrors/tienen errores a propósito y se compilan a mano, como se muestra en cada caso.
Las etapas de un intérprete
Un intérprete es una cadena de etapas. Cada una recibe lo que produjo la anterior:
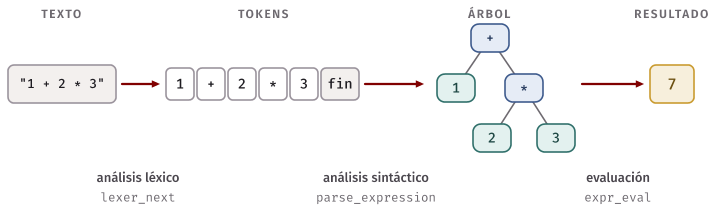
| Etapa | Recibe | Produce | Se escribe | Semana |
|---|---|---|---|---|
| Análisis léxico | caracteres | tokens | lexer_next |
14 |
| Análisis sintáctico | tokens | árbol | parse_expression |
14 |
| Evaluación | árbol | un valor | expr_eval |
13 |
¿Por qué separar las dos primeras? Porque resuelven problemas distintos. El analizador léxico sabe de espacios,
comentarios y de cómo se escribe un número. El parser no quiere saber nada de eso: para él, 1+2 y 1 + 2 son
lo mismo, tres tokens. A cambio, el parser sabe de precedencia, y el analizador léxico no. Es la separación entre
interfaz e implementación de la semana 6, aplicada a un problema más grande.
Idea clave. Cada etapa ignora los detalles de las demás. Si mañana cambia la forma de escribir un comentario, solo cambia el analizador léxico. Si cambia la precedencia, solo cambia el parser.
El lenguaje Mini
Mini tiene solo números, variables, let, print, if, def y llamadas a funciones. Este es un programa completo:
# El factorial, con recursión
def fact(n) = if n < 2 then 1 else n * fact(n - 1)
let x = 5
print fact(x)
Todos los valores son double. Una comparación vale 1 o 0, e if trata el 0 como falso. Los saltos de línea son
como espacios: no hace falta un separador entre instrucciones, porque cada una empieza con una palabra reservada.
La gramática completa del lenguaje es esta. Todavía no tienen que entenderla toda: en la sección de gramáticas
explicamos cómo leerla.
program   → statement*
statement → "let" NAME "=" expr
          | "print" expr
          | "def" NAME "(" [ NAME ("," NAME)* ] ")" "=" expr
expr      → "if" expr "then" expr "else" expr | compare
compare   → sum [ ("<" | "<=" | ">" | ">=" | "==" | "!=") sum ]
sum       → term (("+" | "-") term)*
term      → unary (("*" | "/") unary)*
unary     → "-" unary | primary
primary   → NUMBER | NAME | NAME "(" [ expr ("," expr)* ] ")" | "(" expr ")"
Esta semana el parser solo reconoce expresiones, sin if ni llamadas: de compare para abajo, y en primary solo
NUMBER, NAME y los paréntesis. Las instrucciones, if y las llamadas son de la semana 15, y entran en el mismo
molde.
Análisis léxico
Un token es la unidad mínima de un texto para un lenguaje: un número, un nombre, una palabra reservada, un símbolo. El analizador léxico (lexer) parte el texto en tokens, de izquierda a derecha.
Tiene una interfaz muy corta, en lab/lexer.h:
typedef struct lexer Lexer;
Lexer *lexer_new(const char *source);
void lexer_free(Lexer *lexer);
Token lexer_next(Lexer *lexer);
Lexer es un tipo opaco, como los de la semana 6. Cada llamada a lexer_next devuelve el token siguiente. No hay una
lista de tokens guardada en ningún lado: el parser los pide de uno en uno, según los necesita. Y como lexer_new no
copia el texto, quien llama debe mantenerlo vivo mientras use el lexer.
Un token es un valor pequeño, sin punteros, que se devuelve por copia:
typedef struct {
    TokenKind kind;
    double number;
    char text[64];
    int line;
    int column;
} Token;
Guarda de qué tipo es, su texto, su valor si es un número, y dónde empieza. Sin esa posición, luego no podríamos decir dónde está un error.
El programa show_tokens, también del laboratorio, llama a lexer_next hasta llegar al final y escribe lo que recibe:
$ build/lab/show_tokens 'let x1 = 3*(y+2)'
1:1   LET            let
1:5   NAME           x1
1:8   ASSIGN         =
1:10  NUMBER         3
1:11  STAR           *
1:12  LPAREN         (
1:13  NAME           y
1:14  PLUS           +
1:15  NUMBER         2
1:16  RPAREN         )
1:17  END
Noten tres cosas. Los espacios desaparecieron: 3*(y+2) y 3 * ( y + 2 ) dan los mismos tokens, aunque en otras
columnas. x1 es un solo token, no una x y un 1. Y el último token es END: el parser va a preguntar “¿ya
terminó?”, y es más simple responder con un token que con un caso especial.
Cómo se lee un token
El analizador léxico mira el primer carácter, y con eso sabe qué tipo de token viene:
algoritmo lexer_next(lexer)
    saltar los espacios
    c ← carácter actual
    si c = NULO entonces
        devolver token END
    sino si c es un dígito entonces
        devolver leer_numero(lexer)
    sino si c es una letra o _ entonces
        devolver leer_nombre(lexer)
    sino si c es un símbolo conocido entonces
        consumir c
        devolver el token de ese símbolo
    sino
        consumir c
        devolver token ERROR
    fin si
fin algoritmo
Leer un nombre es un ciclo: mientras siga una letra, un dígito o un guion bajo, avanzar. Luego se revisa si esa
palabra es reservada. lets y _if son nombres, porque primero se lee la palabra entera y después se compara:
$ build/lab/show_tokens 'if x1 then 2.50'
1:1   IF             if
1:4   NAME           x1
1:7   THEN           then
1:12  NUMBER         2.50
1:16  END
Toda la lectura pasa por una sola función, advance, que es la que lleva la cuenta de la posición:
static void advance(Lexer *lexer) {
    if (*lexer->current == '\n') {
        lexer->line++;
        lexer->column = 1;
    } else {
        lexer->column++;
    }
    lexer->current++;
}
Si todo avance pasa por aquí, la línea y la columna siempre están bien. Las dos empiezan en 1, como en los mensajes de
gcc.
En C.
ctype.h, que en Introducción a la Computación vieron conislowerytoupper, también traeisdigit,isalpha,isalnumeisspace. Reciben unint, que debe valer como ununsigned char. Por eso van con un cast:isdigit((unsigned char) c). Sichartiene signo, como en x86_64, un byte de unañsería negativo, y pasarlo sin cast es comportamiento indefinido.
Los números: qué entra y qué no
En Mini, NUMBER es dígitos y una parte decimal opcional. Parece poco, y justo por eso se leen a mano. La función
strtod, de stdlib.h, convierte texto a double, pero entiende mucho más que eso: 1e5, 0x10 e incluso inf. Si la
dejáramos leer directamente del texto, Mini aceptaría números que la gramática no tiene. Así que el lexer busca dónde
termina el número, lo copia a text y solo entonces llama a strtod, sobre algo que ya sabe que está bien formado.
$ build/lab/show_tokens '1e5 0x10 3. .5'
1:1   NUMBER         1
1:2   NAME           e5
1:5   NUMBER         0
1:6   NAME           x10
1:10  NUMBER         3
1:11  ERROR          carácter inesperado '.'
1:13  ERROR          carácter inesperado '.'
1:14  NUMBER         5
1:15  END
Lean esa salida con cuidado. 1e5 son dos tokens, porque el lexer no sabe qué significan: un número termina en el primer
carácter que no le sirve. Y el punto solo entra si le sigue un dígito, por eso 3. y .5 no son números de Mini.
Tampoco es trabajo del lexer quejarse de 12abc. Para él son dos tokens válidos, uno detrás del otro:
$ build/lab/show_tokens '12abc'
1:1   NUMBER         12
1:3   NAME           abc
1:6   END
El que se dará cuenta es el parser, porque ninguna regla permite un nombre pegado a un número.
En C.
snprintf(dest, size, formato, ...)funciona comoprintf, pero escribe en una cadena desizebytes, sin pasarse y siempre con su'\0'. Si no cabe, corta. Es la forma más simple de armar un mensaje de longitud limitada, y la usaremos en todos los mensajes de error.
text tiene 64 bytes
Un nombre puede ser más largo que el arreglo. El lexer mide antes de copiar, y si no cabe devuelve un error:
if (length >= sizeof token->text) {Es la misma regla de siempre con los arreglos de tamaño fijo: se mide primero, y solo entonces se escribe.
Errores léxicos
Si aparece un carácter que no empieza ningún token, el lexer devuelve un TOKEN_ERROR, y en text pone el mensaje. No
escribe nada en la pantalla ni detiene el programa: eso lo decide quien lo usa. Y consume el carácter, para que la
siguiente llamada no devuelva lo mismo para siempre.
Esta semana el analizador léxico que les damos todavía no conoce los comparadores, así que < es un carácter inesperado.
Arreglar eso es la primera parte del laboratorio:
$ build/lab/show_tokens 'x <= 1 # hola'
1:1   NAME           x
1:3   LESS_EQUAL     <=
1:6   NUMBER         1
1:14  END
Fíjense en un detalle: <= es un solo token. Al leer < hay que mirar un carácter más antes de decidir. El criterio es
quedarse con el token más largo posible, de modo que <= nunca se lee como < y =, y === se lee como == y =.
La columna cuenta bytes, no letras. Una ñ son dos bytes en UTF-8, así que el lexer ve dos caracteres inesperados. En un
comentario no molesta, porque se salta. Fuera de un comentario es un error: los nombres de Mini solo llevan letras de ASCII.
$ build/lab/show_tokens 'ñ'
1:1   ERROR          carácter inesperado (byte 195)
1:2   ERROR          carácter inesperado (byte 177)
1:3   END
Gramáticas
Una gramática son las reglas que dicen qué textos pertenecen a un lenguaje. Se escribe así, y esta notación se lee con pocas convenciones. Tomemos un lenguaje pequeño de expresiones lógicas, que será nuestro ejemplo de clase:
or_rule  → and_rule ("or" and_rule)*
and_rule → not_rule ("and" not_rule)*
not_rule → "not" not_rule | atom
atom → "true" | "false" | "(" or_rule ")"| Notación | Se lee | Ejemplo |
|---|---|---|
a → b |
un a se escribe como un b |
atom → "true" |
"or" |
ese token, tal cual | "(" |
NAME, NUMBER |
un token de ese tipo | NUMBER |
a b |
un a y después un b |
"(" or_rule ")" |
a | b |
un a o un b |
"true" | "false" |
( ... )* |
eso, cero o más veces | ("or" and_rule)* |
[ ... ] |
eso, cero o una vez | [ "<" sum ] |
Cada línea es una regla. Una regla habla de tokens y de otras reglas, y también puede hablar de sí misma: not_rule
usa not_rule, y atom llega a or_rule a través de los paréntesis. Por eso un texto puede tener cualquier longitud y
cualquier profundidad con tan pocas líneas.
Un texto pertenece al lenguaje si se puede obtener desde la primera regla. Por ejemplo, not true:
or_rule → and_rule → not_rule → "not" not_rule → "not" atom → "not" "true"En cambio true true no pertenece: ninguna regla pone un atom junto a otro sin un and o un or en medio.
Una gramática ambigua
¿Por qué tantas reglas? ¿No bastaría con esto para las expresiones?
expr → expr "+" expr | expr "*" expr | NUMBEREsa gramática dice bien qué textos son válidos, pero no dice qué significan. El texto 1 + 2 * 3 se puede obtener de
dos formas, y cada una es un árbol distinto:
      +                  *
     / \                / \
    1   *              +   3
       / \            / \
      2   3          1   2

    vale 7             vale 9
Una gramática así se llama ambigua. Para un intérprete es inaceptable, porque el mismo programa tendría dos resultados. Hay que escribirla de otra forma, de modo que cada texto tenga un solo árbol.
La precedencia se escribe con niveles
La solución es separar las operaciones en reglas distintas, una por nivel de precedencia:
sum     → term (("+" | "-") term)*
term    → unary (("*" | "/") unary)*
unary   → "-" unary | primary
primary → NUMBER | NAME | "(" expr ")"
Lean lo que dice sum: una suma es una lista de términos. Y un término no puede contener un + suelto, porque term
solo conoce * y /. Entonces, en 1 + 2 * 3, no hay más que una forma de repartir los tokens:
sum
├── term → unary → primary → 1
├── "+"
└── term
    ├── unary → primary → 2
    ├── "*"
    └── unary → primary → 3
El 2 * 3 queda dentro de un solo term, y 1 + 2 no puede ser un term, porque tiene un +. Por eso vale 7. La regla
es esta: cuanto más abajo en la gramática, más fuerte liga. Nadie le dio a * una “prioridad” numérica. La precedencia
es solo la forma de las reglas.
Los paréntesis son la salida de emergencia. primary permite una expresión entera entre paréntesis, así que (1 + 2) * 3
vuelve a empezar desde arriba dentro de un primary:
term
├── unary → primary
│           ├── "("
│           ├── expr → compare → sum → 1 + 2
│           └── ")"
├── "*"
└── unary → primary → 3
La asociatividad
Falta decidir qué pasa con operaciones del mismo nivel. ¿1 - 2 - 3 es (1 - 2) - 3, que vale -4, o 1 - (2 - 3), que vale
2? En Mini, y en C, se asocia por la izquierda: vale -4. La gramática también debe decir eso, y esta es la forma más
directa de lograrlo:
sum → sum "-" term | termEsta regla dice que lo que está a la izquierda de un - es a su vez una suma, y a la derecha hay solo un término. Eso da
exactamente el árbol de la izquierda: el 1 - 2 se agrupa primero.
        -                     -
       / \                   / \
      -   3                 1   -
     / \                       / \
    1   2                     2   3

  sum → sum "-" term      sum → term "-" sum
     vale -4                  vale 2
Y aquí aparece el problema de esta semana: esa regla es correcta como gramática, pero no se puede programar tal cual. Antes de ver por qué, veamos cómo se programa una gramática.
De la gramática al parser: una función por regla
Un parser descendente recursivo (recursive descent parser) tiene una función por cada regla. Se llama descendente porque empieza por la primera regla y baja hacia los tokens, y recursivo porque las reglas se llaman entre sí. La traducción es casi mecánica:
| En la gramática | En el programa |
|---|---|
| una regla | una función |
| una referencia a otra regla | una llamada a esa función |
| un token | revisar el token actual y avanzar |
a | b |
un si, mirando el token actual |
( ... )* |
un mientras |
[ ... ] |
un si |
Todo el estado del parser es el lexer y el token actual, el que toca mirar y aún no se consume:
typedef struct {
    Lexer *lexer;
    Token current;
    LogicError *error;
} Parser;
Avanzar es pedir el siguiente:
static void advance(Parser *p) {
    p->current = lexer_next(p->lexer);
}
Con mirar un solo token alcanza para decidir qué regla seguir, porque en cada alternativa de nuestra gramática el primer token es distinto. No hay que probar y retroceder como en el backtracking de la semana 11.
Primero en pseudocódigo
Empecemos por la regla más común, una lista con operadores, escrita para sum. Por ahora sin errores:
algoritmo parse_sum(p)
    izquierda ← parse_term(p)
    mientras p.actual es "+" o "-" hacer
        op ← p.actual
        avanzar(p)
        derecha ← parse_term(p)
        izquierda ← nodo(op, izquierda, derecha)
    fin mientras
    devolver izquierda
fin algoritmo
Y una regla con alternativas, como primary, mira el token y decide:
algoritmo parse_primary(p)
    si p.actual es NUMBER entonces
        hoja ← nodo_numero(p.actual)
        avanzar(p)
        devolver hoja
    sino si p.actual es "(" entonces
        avanzar(p)
        adentro ← parse_expr(p)
        exigir ")" y avanzar(p)
        devolver adentro
    sino
        error: se esperaba una expresión
    fin si
fin algoritmo
Noten el salto en parse_primary: llama a parse_expr, que baja hasta llamar de nuevo a parse_primary. La recursión de
la gramática se vuelve recursión del programa. Por cada paréntesis abierto hay un grupo más de marcos en la pila, y los
paréntesis sin cerrar son justamente esas llamadas que todavía no regresan. Cuando en la semana 9 vieron la pila de llamadas
crecer y encogerse, era esto mismo.
En C, con las expresiones lógicas
El programa logic_parser.c es un parser completo del lenguaje lógico. Usa el mismo lexer: and, or, not, true y
false le llegan como TOKEN_NAME, así que los reconoce comparando el texto:
static int is_word(const Parser *p, const char *word) {
    return p->current.kind == TOKEN_NAME && strcmp(p->current.text, word) == 0;
}
El árbol es una unión etiquetada simplificada, y logic_new toma posesión de sus hijos, igual que expr_binary. Esta es la
regla not_rule → "not" not_rule | atom:
static Logic *parse_not(Parser *p) {
    if (!is_word(p, "not")) {
        return parse_atom(p);
    }
    advance(p);
    Logic *operand = parse_not(p);
    if (operand == NULL) {
        return NULL;
    }
    Logic *node = logic_new(LOGIC_NOT, 0, operand, NULL);
    if (node == NULL) {
        fail(p, "no hay memoria");
    }
    return node;
}
Es recursiva, y funciona porque consume un token antes de llamarse. Volveremos a eso. Esta es or_rule, la de la lista:
static Logic *parse_or(Parser *p) {
    Logic *left = parse_and(p);
    if (left == NULL) {
        return NULL;
    }
    while (is_word(p, "or")) {
        advance(p);
        Logic *right = parse_and(p);
        if (right == NULL) {
            logic_free(left);
            return NULL;
        }
        left = logic_new(LOGIC_OR, 0, left, right);
        if (left == NULL) {
            fail(p, "no hay memoria");
            return NULL;
        }
    }
    return left;
}
El programa escribe el árbol con todos los paréntesis, para que se vea su forma, y luego lo evalúa:
$ build/logic_parser 'true or false and false'
árbol: (true or (false and false))
valor: true
and ligó más fuerte, porque and_rule está más abajo en la gramática. Con paréntesis cambia:
$ build/logic_parser '(true or false) and false'
árbol: ((true or false) and false)
valor: false
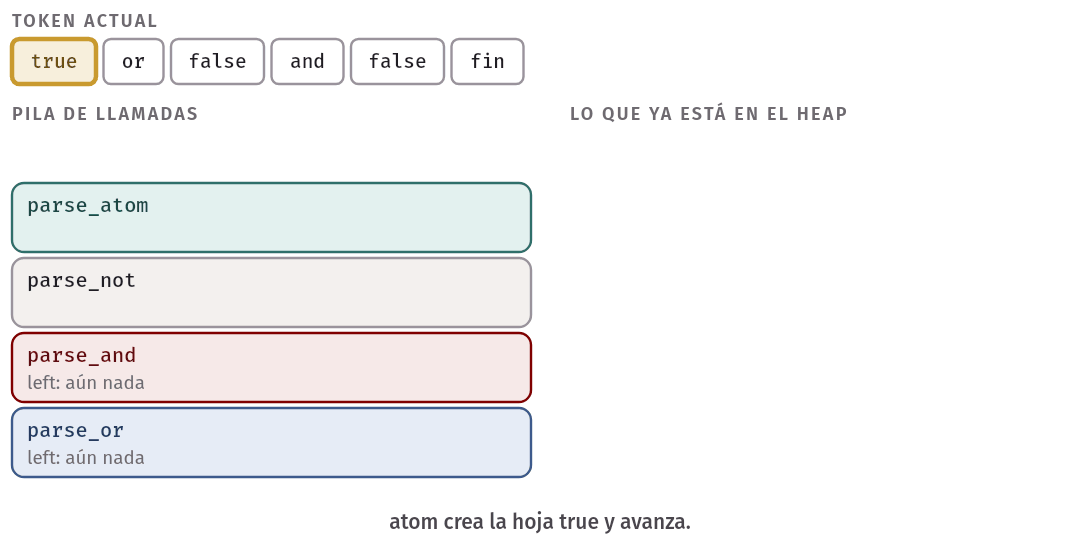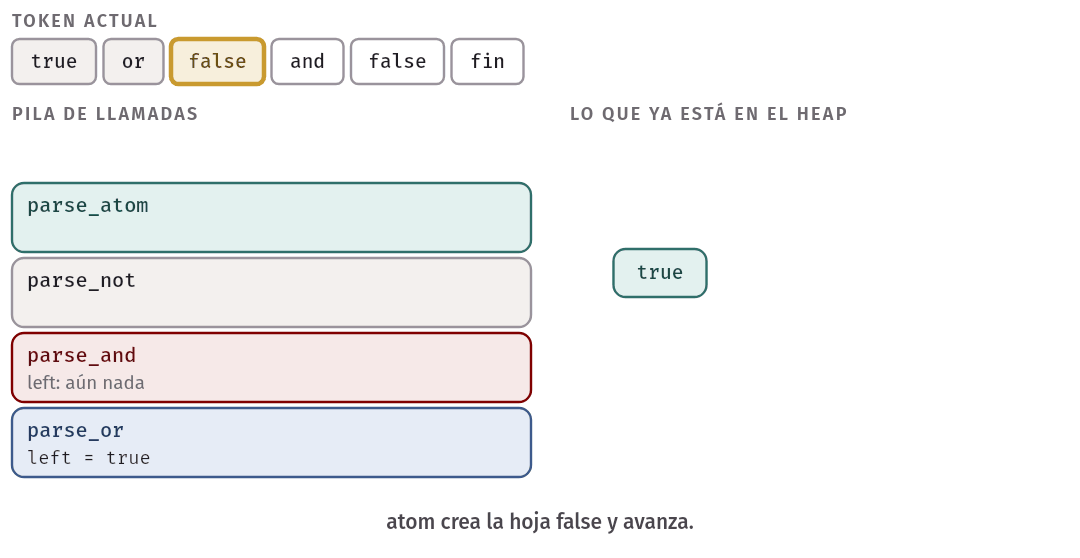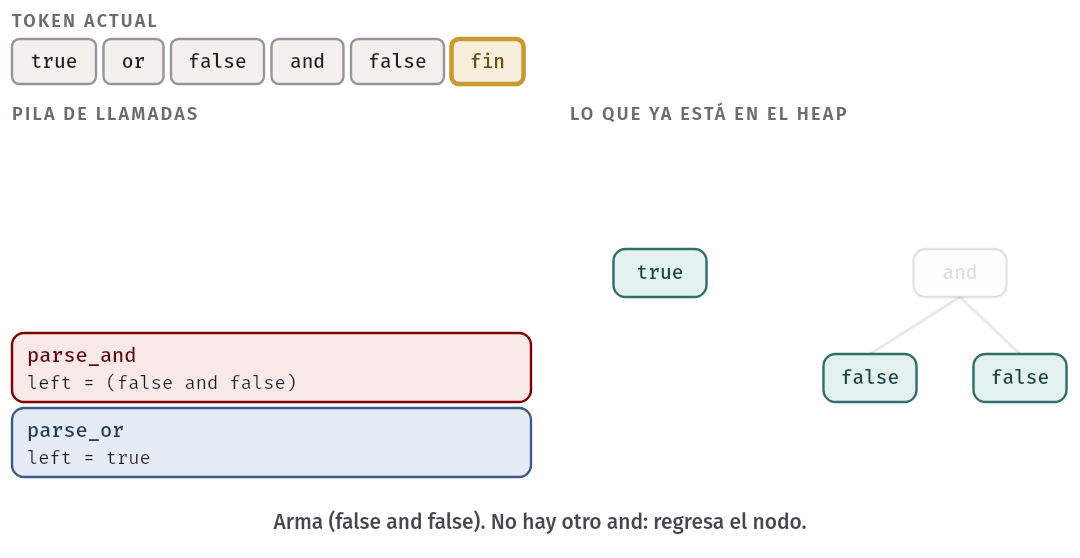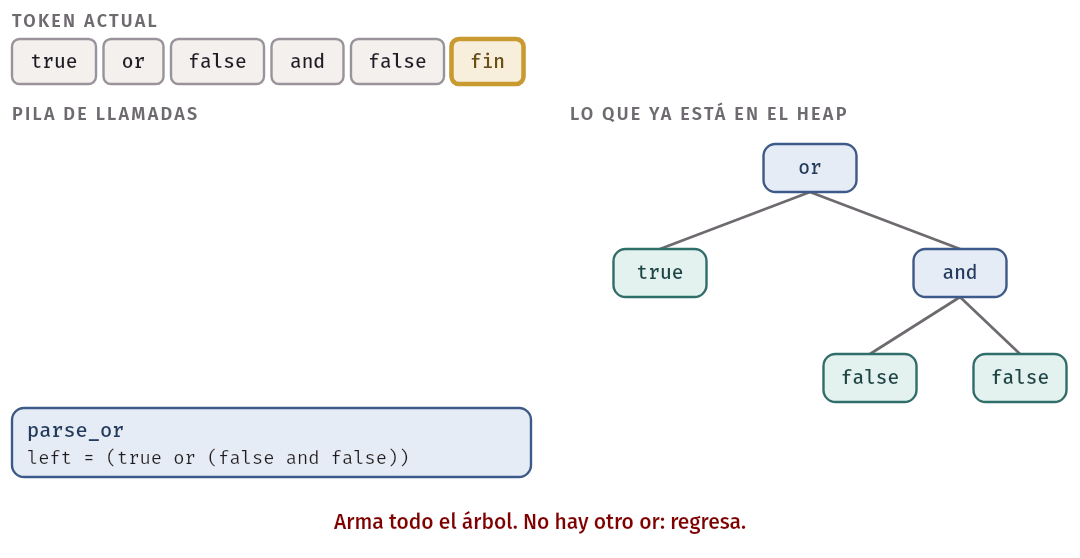
Una llamada, paso a paso
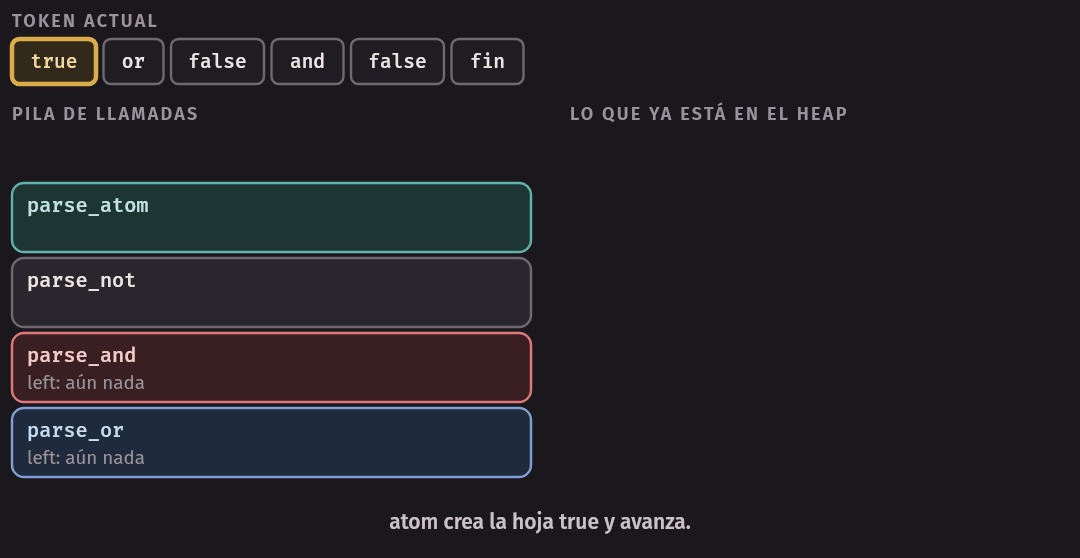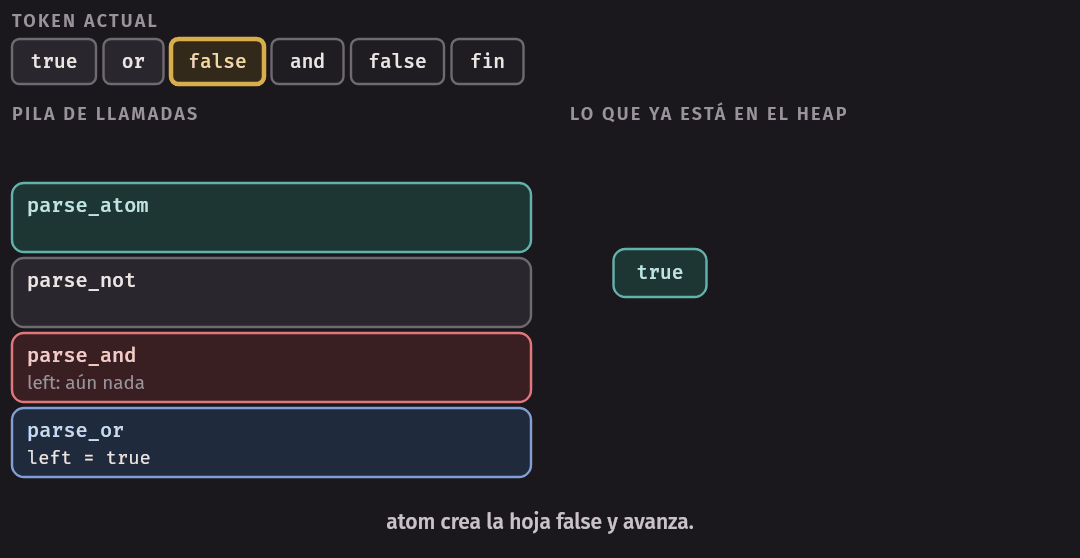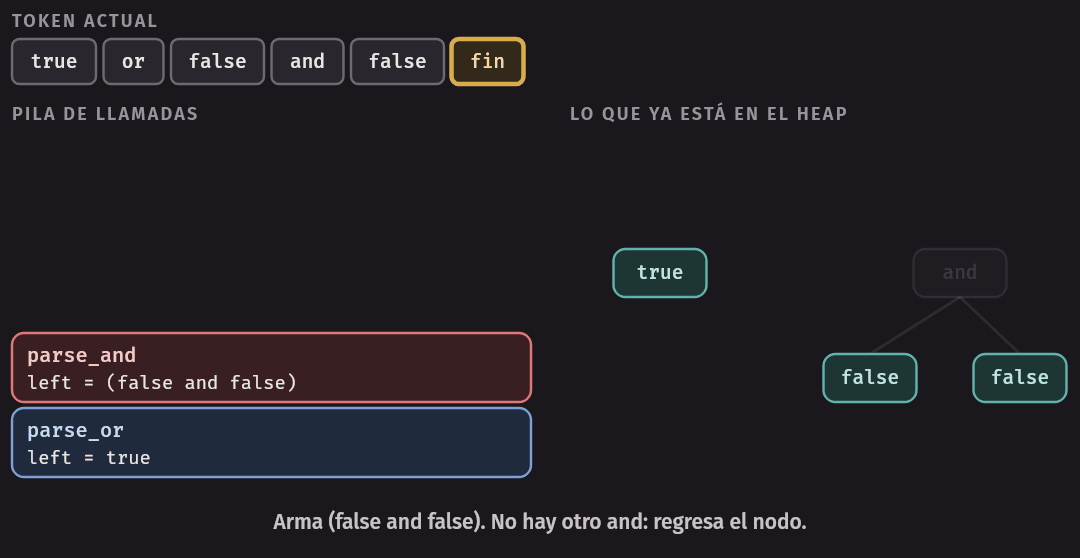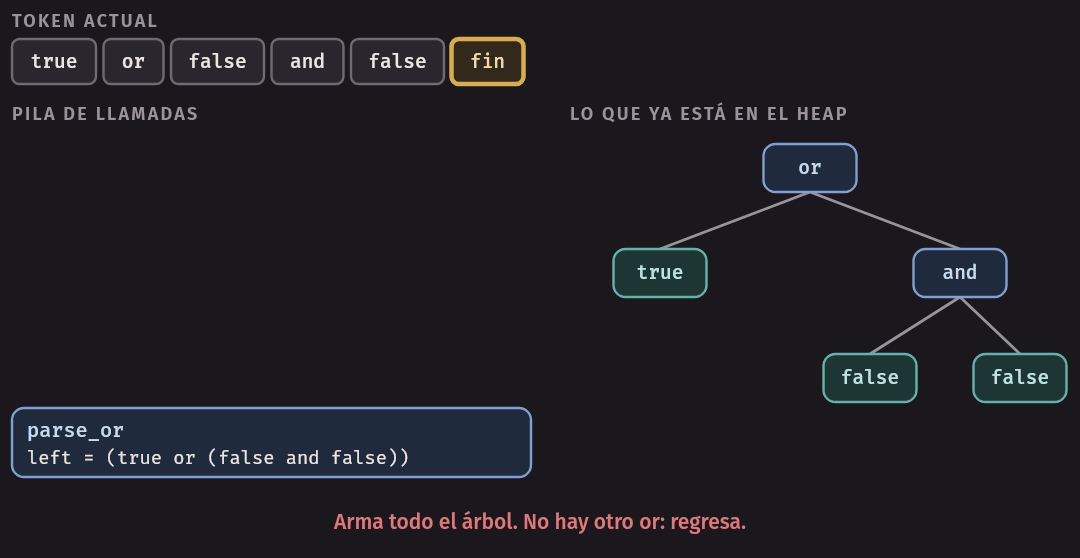
Sigamos true or false and false. La tabla muestra, en cada paso, qué funciones están activas y cuál es el token actual.
| Token actual | Pila de llamadas | Qué pasa |
|---|---|---|
true |
or → and → not → atom |
atom crea la hoja true y avanza |
or |
or → and |
not y atom regresaron. and ve or, no es lo suyo, y regresa la hoja |
or |
or |
left es true. Ve or: entra al ciclo y avanza |
false |
or → and → not → atom |
crea la hoja false y avanza |
and |
or → and |
left de and es false. Ve and: entra al ciclo y avanza |
false |
or → and → not → atom |
crea la segunda hoja false y avanza |
| fin | or → and |
arma (false and false). No hay otro and: regresa el nodo |
| fin | or |
arma (true or (false and false)). No hay otro or: regresa |
Noten cómo decide cada función: si el token actual no es lo suyo, regresa y no lo consume. Le toca a quien llamó
decidir qué hacer con él. Es lo que hace and en la segunda fila.
Idea clave. Una función del parser cumple una promesa simple: al entrar, el token actual es el primero de su regla; al salir, ya consumió todo lo que era suyo, y el token actual es el primero que no le pertenece.
Por qué sum → sum "+" term no se puede escribir tal cual
Volvamos a la regla directa, la de la asociatividad. Tomemos la versión mínima, una cadena de restas, y copiémosla a C literalmente, con una función por regla. La regla empieza por sí misma, así que la función empieza por llamarse. Esto es recursión por la izquierda (left recursion):
static double parse_chain(Parser *p) {
    double left = parse_chain(p);       // primero la regla misma, sin consumir nada
Esa llamada recibe exactamente el mismo token actual, porque nadie avanzó. Entonces hace lo mismo, y otra vez, para siempre.
Los parámetros no se acercan a nada: es una recursión sin caso base, como las de la semana 9. gcc ya lo nota al compilar:
$ gcc -Wall -Wextra -std=c17 -g -fsanitize=address,undefined -Ilab errors/left_recursion.c lab/lexer.c -o build/left_recursion
errors/left_recursion.c: In function 'parse_chain':
errors/left_recursion.c:15:15: warning: infinite recursion detected [-Winfinite-recursion]
   15 | static double parse_chain(Parser *p) {
      |               ^~~~~~~~~~~
errors/left_recursion.c:16:19: note: recursive call
   16 |     double left = parse_chain(p);       // primero la regla misma, sin consumir nada
      |                   ^~~~~~~~~~~~~~
Y si lo corren, la pila se llena. Este es un extracto del informe de ASan:
$ build/left_recursion
==154==ERROR: AddressSanitizer: stack-overflow on address 0xfffff2cdefd0 (pc 0xaaaae95e437c bp 0xfffff2cdf000 sp 0xfffff2cdf000 T0)
    #1 0xaaaae95e438c in parse_chain errors/left_recursion.c:16
    #2 0xaaaae95e438c in parse_chain errors/left_recursion.c:16
    #3 0xaaaae95e438c in parse_chain errors/left_recursion.c:16
Es la misma firma de la semana 9: stack-overflow, con una línea repetida.
Idea clave. En un parser descendente, toda llamada recursiva debe haber consumido al menos un token antes. Así, cada nivel tiene menos texto por delante, y el texto es finito.
not_rule → "not" not_rulelo cumple;sum → sum "-" term, no.
Voltear la regla tampoco sirve
Lo primero que se nos ocurre es poner la recursión a la derecha:
chain → NUMBER [ "-" chain ]Esto sí termina, porque consume un número antes de llamarse, y además acepta exactamente los mismos textos. Pero agrupa al
revés: lo que queda a la derecha del primer - es toda una cadena, o sea 1 - (2 - 3). El programa subtract_chain.c tiene
las dos versiones, y calcula directamente, sin árbol:
static double chain_right(Parser *p) {
    double value = read_number(p);
    if (p->current.kind == TOKEN_MINUS) {
        advance(p);
        return value - chain_right(p);
    }
    return value;
}
$ build/subtract_chain '1 - 2 - 3'
recursión por la derecha: 2
con un ciclo: -4El parser funciona, no se cae, no tiene fugas, y calcula mal. Es el peor tipo de error.
El ciclo
La salida viene de mirar qué textos genera la regla por la izquierda. sum → sum "-" term | term produce: un term, luego
quizás - term, luego quizás otro - term, las veces que sean. Eso se puede escribir sin recursión:
sum → term ("-" term)*Es el mismo lenguaje, y aquí la repetición ya no es recursión, sino un ciclo:
static double chain_loop(Parser *p) {
    double value = read_number(p);
    while (p->current.kind == TOKEN_MINUS) {
        advance(p);
        value = value - read_number(p);
    }
    return value;
}
Sigamos 1 - 2 - 3:
| Paso | Token actual al entrar | value |
|---|---|---|
| Lee el primer número | - |
1 |
| Vuelta 1: resta 2 | - |
1 - 2 = -1 |
| Vuelta 2: resta 3 | fin | -1 - 3 = -4 |
¿Por qué sale asociado por la izquierda? Porque lo acumulado se combina con el siguiente, en orden. Es el array_fold de la
semana 12, que combinaba de izquierda a derecha. Y si en vez de calcular armamos un árbol, cada vuelta pone lo acumulado como
hijo izquierdo de un nodo nuevo, que es justo lo que hace parse_or y lo que hará su parse_sum:
left = 1      left = (1 - 2)      left = ((1 - 2) - 3)

   1                -                     -
                   / \                   / \
                  1   2                 -   3
                                       / \
1 2| Regla | ¿Termina? | Agrupa | ¿Sirve? |
|---|---|---|---|
sum → sum "-" term | term |
no: se llama sin consumir | por la izquierda | correcta, pero no se programa así |
sum → term "-" sum | term |
sí | por la derecha | da mal 1 - 2 - 3 |
sum → term ("-" term)* |
sí | por la izquierda, según armemos el ciclo | esta |
Error común. Pensar que todos los operadores deben usar un ciclo. La recursión por la derecha es lo correcto cuando el operador asocia por la derecha, y eso pasa con
-unario:- - xes-(-x), yunary → "-" unarylo dice bien.
Errores de sintaxis
Un parser recibe texto que escriben personas, y en todo ese texto habrá errores. Se necesitan dos cosas: decir bien qué pasó, y no dejar basura en la memoria.
Dónde y qué
Lo más útil de un mensaje es el lugar. Cuando una función no encuentra lo que necesita, el culpable está a la vista: es el
token actual, que trae su línea y su columna. La función fail anota eso, y como cada error se reporta una sola vez, solo
queda el primero:
static void fail(Parser *p, const char *message) {
    p->error->line = p->current.line;
    p->error->column = p->current.column;
    const char *text = p->current.kind == TOKEN_ERROR ? p->current.text : message;
    snprintf(p->error->message, sizeof p->error->message, "%s", text);
}
La línea del TOKEN_ERROR es la que une las dos etapas. Si el lexer encontró un carácter raro, el parser recibe un token que
ninguna regla acepta, y al reportarlo, se usa el mensaje que ya escribió el lexer. No hace falta ningún otro camino:
$ build/logic_parser 'true @'
línea 1, columna 6: carácter inesperado '@'
$ build/logic_parser 'true or (false'
línea 1, columna 15: se esperaba ')'¿Dónde va el error si se acabó el texto? En el token END, que está justo donde terminó el texto. En true or (false,
tiene 14 caracteres, y por eso marca la columna 15. Si el texto termina con un salto de línea, END está en la línea
siguiente. Es un detalle que a algunos parsers les preocupa más; nosotros lo dejamos así.
Hay un error que es fácil pasar por alto. Si el parser solo pide “una expresión”, en true maybe encuentra true, y
termina contento. Por eso, al salir de la regla principal hay que exigir END:
if (tree != NULL && parser.current.kind != TOKEN_END) {$ build/logic_parser 'true and false)'
línea 1, columna 15: sobra texto después de la expresiónQué hay que liberar
Cuando falla, ya se construyó parte del árbol. Veamos true or false and (true or, que falla al final:
$ build/logic_parser 'true or false and (true or'
línea 1, columna 27: se esperaba true, false o '('
En el momento del fallo, la pila de llamadas tiene esto, desde la función más antigua hasta la última. De paso también
están activas otras parse_and y parse_not, que aún no tienen nada:
| Función activa | Su left |
Qué hace al recibir NULL |
|---|---|---|
parse_or, la de afuera |
hoja true |
la libera y devuelve NULL |
parse_and, la de afuera |
hoja false |
la libera y devuelve NULL |
parse_atom, por el paréntesis |
devuelve NULL |
|
parse_or, la de adentro |
hoja true |
la libera y devuelve NULL |
parse_atom, la última |
reporta el error y devuelve NULL |
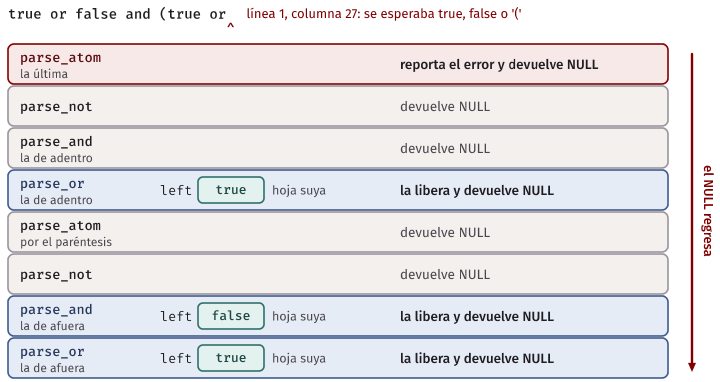
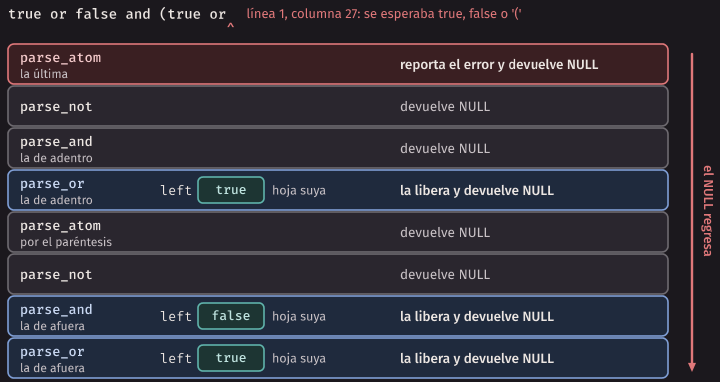
No hay ningún árbol completo. Lo construido hasta ahí son tres hojas sueltas, y cada una está en una variable local de un
marco distinto. Quien tiene esa variable es su owner. Por eso el NULL tiene que subir por todos los marcos, y cada uno
libera lo suyo al pasar. Es la disciplina de la semana 5, aplicada a la pila.
| Situación | ¿Quién libera? |
|---|---|
right falló, y left ya está |
esta función libera left |
logic_new(kind, left, right) falló |
logic_new ya los liberó. Si los liberan otra vez, es un double free |
Falló el ), y inside ya está |
esta función libera inside |
Sobra texto, y tree ya está |
quien hizo esa comprobación libera tree |
Si se les olvida, el programa no falla: da el mensaje correcto, pero tiene una fuga. El ejemplo errors/leak_on_error.c es una
regla como or_rule a la que le falta el logic_free:
if (right == NULL) {
    return NULL;                // ¿y left?
$ gcc -Wall -Wextra -std=c17 -g -fsanitize=address,undefined -Ilab errors/leak_on_error.c lab/lexer.c -o build/leak_on_errorgcc no dice nada. ASan lo encuentra al terminar el programa, y este es un extracto del informe:
$ build/leak_on_error
==163==ERROR: LeakSanitizer: detected memory leaks
Direct leak of 16 byte(s) in 1 object(s) allocated from:
    #1 0xaaaab7fe4954 in node_new errors/leak_on_error.c:31
    #2 0xaaaab7fe4b40 in parse_atom errors/leak_on_error.c:47
    #3 0xaaaab7fe4b60 in parse_or errors/leak_on_error.c:51
La lista de marcos dice dónde se reservó, no dónde se olvidó liberar. Tienen que seguir al owner desde ahí: parse_atom lo
crea, y parse_or lo recibe en left.
Error común. Probar solo con entradas correctas. Las fugas de un parser están en los caminos de error, y esos solo corren con entradas malas. Para cada función, prueben una entrada que falle después de que ella ya tenga algo construido.
En C. ¿Por qué
LogicError, igual queParseErroren el laboratorio, es un parámetro y no una variable global? Por lo de siempre: el estado de una llamada va en la llamada. Con un parámetro, dos análisis no se pisan, y el error vive en el marco de quien lo quiere leer.
Un límite que no vamos a arreglar
Cada paréntesis abierto son varios marcos en la pila, y la pila es finita, como vieron en la semana 9. Con mil paréntesis no hay problema. Con cien mil, sí. El número exacto depende de la máquina y del tamaño de la pila, y con ASan los marcos son más grandes. Este es un extracto:
$ build/logic_parser "$(python3 -c 'print("(" * 100000)')"
ERROR: AddressSanitizer: stack-overflow
Es un límite real de los parsers recursivos. Un parser serio lleva la cuenta de la profundidad y devuelve un error. El nuestro no lo hace, porque ningún programa de este curso anida tanto, y agregarlo es un buen ejercicio.
El código de esta semana
make compila los programas de la clase en build/, y make lab compila el laboratorio. make test corre tres archivos de
pruebas:
| Archivo | Qué comprueba |
|---|---|
test_examples.py |
Que los programas compilan sin advertencias, cada error de logic_parser en su columna y sin fugas, subtract_chain, y lo que avisan gcc y ASan en errors/ |
test_notes.py |
Vuelve a correr los comandos de este capítulo y compara su salida, y revisa que el código citado exista |
test_lab.py |
La solución del laboratorio, si está disponible |
Los extractos de los informes solo se comparan en las líneas citadas, sin contar direcciones. make test-lab corre las pruebas de
laboratorio sobre su código.
El laboratorio, paso a paso
Esta semana hay una sola sesión de laboratorio, y la otra es para la Práctica 4. Los archivos están en code/week-14/lab, y su
README.md tiene las preguntas y lo que pide cada parte. Aquí están las ideas, no el código. Reciben terminados expr.c, con las
seis comparaciones agregadas a BinaryOp, y env.c.
Parte 1: el lexer. Primero léanlo, con sus pruebas. Luego agreguen los comparadores y los comentarios. Para los comparadores
hay que mirar el carácter siguiente sin consumirlo todavía. ! solo no es un token de Mini. Para los comentarios, skip_blanks
ya no es solo un ciclo sobre espacios, porque después de un comentario puede venir un espacio, y después otro comentario. Pregúntense
si el comentario debe comerse el \n, y qué le pasaría al contador de líneas.
Parte 2: el parser. Esta es la gramática de esta semana, que además está al inicio de parser.c:
expr    → compare
compare → sum [ ("<" | "<=" | ">" | ">=" | "==" | "!=") sum ]
sum     → term (("+" | "-") term)*
term    → unary (("*" | "/") unary)*
unary   → "-" unary | primary
primary → NUMBER | NAME | "(" expr ")"
Traduzcan regla por regla, con logic_parser.c al lado. Son cuatro decisiones nuevas:
sumytermson comoor_rule, pero con dos tokens posibles, que hay que recordar antes de avanzar.-xse construye como0 - x. No hay una variante nueva enExpr. Si no hay memoria para el 0, ya tienen un operando que liberar.compareusa[ ]: unsi, sin ciclo. Por eso1 < 2 < 3es un error, y no porque alguien lo prohíba. El segundo<llega aparse_expressioncomo texto de más.- Un constructor que devuelve
NULLsignifica que no hay memoria. También hay que llenar el mensaje.
Cuando funcione, se ve así. parse_main evalúa con x = 2 e y = 3:
$ build/lab/parse_main 'x + 1 <= y * 2'
árbol: x + 1 <= y * 2
valor: 1
expr_print solo pone los paréntesis necesarios, así que lo que escribe revela la forma del árbol. El menos unario se nota:
$ build/lab/parse_main '-x * 2'
árbol: (0 - x) * 2
valor: -4
Parte 3: los errores. Escriban syntax_error, y lleven la disciplina de la tabla de arriba a cada función. parse_main muestra
la línea con una marca en la columna:
$ build/lab/parse_main '(x + 2'
(x + 2
      ^
línea 1, columna 7: se esperaba ')'
Las pruebas exigen la línea y la columna exactas, pero no su redacción del mensaje, salvo dos casos: si falta un ), debe
mencionarlo; y si el error viene del lexer, debe llegar su mensaje. Con ASan, una entrada que falla tarde detecta lo que no
liberaron. También hay una prueba que hace fallar cada malloc, uno por uno.
Resumen
- Un intérprete es una cadena: texto → tokens → árbol → resultado. Cada etapa ignora los detalles de las demás.
- Un token es la unidad mínima del lenguaje. El analizador léxico los entrega de uno en uno, con su posición, y termina en
END. - El lexer se queda con el token más largo posible, y lee los números a mano para aceptar solo lo que dice la gramática.
- Un
TOKEN_ERRORlleva su mensaje. El lexer no escribe nada ni detiene el programa. - Una gramática dice qué textos pertenecen a un lenguaje. Si un texto tiene dos árboles, es ambigua.
- La precedencia se escribe con niveles: cuanto más abajo en la gramática, más fuerte liga. Los paréntesis vuelven a empezar desde arriba.
- Un parser descendente recursivo tiene una función por regla. La recursión de la gramática se vuelve recursión del programa.
- La recursión por la izquierda no se puede programar directo: la función se llama sin consumir nada, y la pila se llena. Toda llamada recursiva debe consumir antes un token.
- La recursión por la derecha termina, pero asocia al revés:
1 - 2 - 3da 2. - Un ciclo reemplaza la recursión por la izquierda, y lo acumulado pasa a ser el hijo izquierdo. Eso da la asociatividad por la izquierda.
- Un error se reporta con la posición del token actual. El
NULLsube por los marcos, y cada uno libera lo que es suyo. - Después de la regla principal se exige
END. Si no,1 2pasa como válido. - Una entrada muy anidada produce un stack overflow: es un límite real de los parsers recursivos.
Ejercicios
Decidan primero y ejecuten después. Todo programa revisa sus lecturas, compila sin advertencias y libera lo que reserva.
-
Escriban a mano los tokens de
let total = (a1 + 2.5)*b # fin, con su línea y su columna. Compruébenlo conshow_tokens, una vez hecha la primera parte del laboratorio. -
¿Cuántos tokens tiene cada texto, y cuáles son? Hagan primero la lista:
x1,x 1,1x,<=,< =,===,!x. -
Con la gramática lógica, dibujen el árbol de
not true and false or true. Digan su valor. Compruébenlo conlogic_parser. -
Con la gramática de esta semana, dibujen el árbol de
1 - 2 * -3 < 4. ¿Cuántos nodos tiene, sabiendo que el-unario es0 - x? -
Cambien la gramática lógica para que
orligue más fuerte queand. ¿Cuántas líneas cambian en la gramática? ¿Y enlogic_parser.c? ¿Qué árbol da ahoratrue or false and false? -
Para cada regla, digan si tiene recursión por la izquierda. Si la tiene, reescríbanla con
*, sin cambiar el lenguaje.a) list → list "," NAME | NAME b) list → NAME "," list | NAME c) block → "(" block ")" | NAME d) p → q "x" y además q → p "y" | "z" -
Sigan a mano
chain_rightychain_loopcon10 - 2 - 3 - 1, y hagan una tabla para cada una. ¿Qué expresión con paréntesis calcula cada una? Compruébenlo consubtract_chain. -
Para
true and (false or not (true, hagan una tabla como la de “Qué hay que liberar”. ¿Cuántas hojas están vivas al fallar? ¿En qué marco está cada una? ¿En qué columna marca el error? -
En
logic_parser.c, quiten ellogic_free(inside)deparse_atom. Encuentren una entrada que haga que ASan lo reporte, y otra que no lo revele. Luego piensen en esta variante: guardan el resultado delogic_newennode, y si esNULLllaman alogic_free(left). ¿Qué pasa? ¿Por qué es difícil verlo con entradas normales? -
Agreguen a
logic_parser.cun límite de profundidad: un campo enParserqueparse_atomaumenta al entrar a un paréntesis y reduce al salir, con un error si pasa de 1000. ¿Protege también contranot not not ...? Si no, ¿dónde más hay que contar? -
Agreguen a la gramática lógica un operador
impliesque ligue menos queory asocie por la derecha:a implies b implies csignificaa implies (b implies c). Escriban primero la regla. ¿Lleva ciclo o recursión? Agréguenlo al programa, y comprueben el árbol. -
Extiendan su lexer para aceptar
1e5y2.5e-3como un soloNUMBER. ¿Qué debe pasar con1e? ¿Y conx1e5? ¿Cuántas líneas del parser tuvieron que cambiar?