Apuntes · Capítulo 15Un intérprete
El intérprete
El intérprete
Hace dos semanas escribieron un árbol que sabe evaluarse: Expr. La semana pasada escribieron un parser que convierte texto en ese
árbol. Si juntan las dos cosas, tienen una calculadora con variables. Falta poco para un lenguaje de verdad, y ese poco es lo más
interesante: que un programa pueda definir sus propias funciones, y que esas funciones se puedan llamar a sí mismas.
Hoy terminamos Mini. Este programa es la meta del capítulo:
def fact(n) = if n < 2 then 1 else n * fact(n - 1)
let x = 5
print fact(x)     # 120
Para correrlo se necesitan tres cosas nuevas: instrucciones, un if y llamadas. Las dos primeras son más de lo mismo. La tercera es la
idea de la semana. Para evaluar una llamada, el intérprete hace exactamente lo que ustedes hacen en el papel desde la semana 3:
calcula los argumentos, crea un marco, pone en él los parámetros y sigue ahí. El modelo de entornos deja de ser una forma de
razonar sobre un programa, y pasa a ser un programa escrito por ustedes.
Es también el cierre del curso. Casi todo lo que vieron aparece en este intérprete, y al final del capítulo haremos la cuenta.
Ruta de lectura.
- Antes de clase (15 a 20 minutos, obligatoria): la introducción, Lo que ya está, y lo que falta, Dos variantes más para
Expry Las instrucciones son otra unión etiquetada.- En clase: Completar la gramática, Ejecutar: la tabla de funciones, Evaluar el
if, Evaluar una llamada, La recursión de un lenguaje sostenida por la de otro, Errores de ejecución, Probar un programa grande y, como repaso del curso, Qué idea sirvió en cada parte.- Después de clase: Programas de verdad y El laboratorio, paso a paso. Luego el Resumen y los Ejercicios. Para ir más allá: el ejercicio 11, el reto.
Código. Los programas de este capítulo están en
code/week-15. Dentro del entorno del curso, entren a esa carpeta y corranmakepara compilar el ejemplo de clase ymake testpara comprobarlo. Los comandos se corren desde ahí. Los que empiezan conbuild/lab/minifuncionan cuando terminen el laboratorio: las salidas de este capítulo salieron de una versión terminada.
Lo que ya está, y lo que falta
El lenguaje completo cabe en esta gramática, en la notación de la semana 14:
program   → statement*
statement → "let" NAME "=" expr
          | "print" expr
          | "def" NAME "(" [ NAME ("," NAME)* ] ")" "=" expr
expr      → "if" expr "then" expr "else" expr | compare
compare   → sum [ ("<" | "<=" | ">" | ">=" | "==" | "!=") sum ]
sum       → term (("+" | "-") term)*
term      → unary (("*" | "/") unary)*
unary     → "-" unary | primary
primary   → NUMBER | NAME | NAME "(" [ expr ("," expr)* ] ")" | "(" expr ")"
Las reglas desde compare hasta unary son las de la semana pasada, y ya vienen hechas en el laboratorio. Lo nuevo son program,
statement, el if de expr y la llamada de primary.
Las reglas de significado, en pocas frases:
- Todo valor es un
double. Una comparación da 1 o 0. - En un
if, el 0 es falso y cualquier otro valor es verdadero. Solo se evalúa la rama elegida. printescribe el valor con%gy un salto de línea.letdefine o cambia una variable global. No hay otras variables: dentro de una función solo existen sus parámetros.- Los saltos de línea son espacios en blanco. Las instrucciones no llevan separador, porque cada una empieza con su palabra clave.
Fíjense en una decisión del lenguaje: el cuerpo de una función es una expresión, no una lista de instrucciones. No hay let
dentro de un def, ni return, ni ciclos. Con eso, Mini es pequeño, pero veremos que alcanza para programas de verdad, porque
tiene recursión.
En C. Si alguna vez
%gles parece raro, recuerden lo que hace: usa 6 cifras significativas, y notación científica si el número es muy grande o muy chico. Por esoprint fact(10)no escribe 3628800. Lo verán abajo.
Dos variantes más para Expr
Expr crece igual que en la semana 7: una etiqueta más en el enum y un caso más en la unión. Así queda expr.h:
typedef enum { EXPR_NUMBER, EXPR_VARIABLE, EXPR_BINARY, EXPR_IF, EXPR_CALL } ExprKind;struct expr {
ExprKind kind;
union {
double number;
char *name; // EXPR_VARIABLE: copia propia
struct { BinaryOp op; Expr *left; Expr *right; } binary;
struct { Expr *condition; Expr *then_branch; Expr *else_branch; } conditional;
struct { char *name; Expr **args; int arg_count; } call; // args es NULL si arg_count es 0
} as;
};El campo se llama conditional y no if, porque if es una palabra de C.
La variante call es la primera con un número variable de hijos. args es un arreglo dinámico de punteros a Expr: por eso
Expr **. Cada casilla apunta a un árbol, y el nodo es owner del arreglo y de los árboles. Dibujemos max(a + 1, 2):
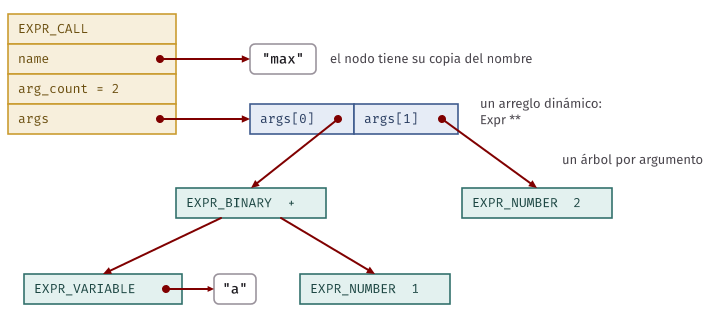
En ese dibujo hay varios bloques: el nodo, su cadena name, el arreglo y cada árbol, con sus propias cadenas. La regla de ownership de la semana 5 dice qué libera expr_free en esta variante, y en qué orden: primero lo que cuelga de un bloque y luego
el bloque, porque después de un free ya no se puede leer el campo.
case EXPR_CALL:
    free(e->as.call.name);
    free_args(e->as.call.args, e->as.call.arg_count);
    break;
Los constructores nuevos siguen el contrato de expr_binary. Esto lo verán en cada línea del parser, así que vale la pena repetirlo:
// Estos tres se vuelven owners de lo que reciben, aunque fallen: en ese caso lo liberan y
// devuelven NULL. Un hijo NULL cuenta como falla.
Expr *expr_binary(BinaryOp op, Expr *left, Expr *right);
Expr *expr_if(Expr *condition, Expr *then_branch, Expr *else_branch);
Expr *expr_call(const char *name, Expr **args, int arg_count);
Pregúntense por qué se copia name, y args no. El nombre llega como const char *: puede estar en cualquier lado, como dentro de
un token que está por cambiar. El arreglo, en cambio, se reservó justo para este nodo, y copiarlo no ganaría nada. La firma lo dice:
const significa “lo miro”, y sin const, según el comentario, “ahora es mío”.
Idea clave. Agregar una variante toca todas las funciones que hacen
switchsobrekind:expr_free,expr_print,expr_copy,expr_equal, y las demás. Es la misma observación de la semana 7, y-Wallles ayuda: si olvidan un caso de unswitchsindefault, avisa. Por eso elswitchdeexpr_freey el deevalno tienendefault.
Una cosa cambia respecto a la semana 13. Su expr_eval recibe un Env y nada más, y una llamada necesita saber qué funciones hay.
En expr.c sigue una expr_eval que devuelve 0 si encuentra una llamada, porque sirve para expresiones simples. El intérprete
usa otra, eval, que verán en un momento.
Las instrucciones son otra unión etiquetada
Una expresión tiene un valor. Una instrucción, en cambio, hace algo: define una variable, escribe, registra una función. Son
cosas distintas, y por eso van en otro tipo, en stmt.h:
typedef enum { STMT_LET, STMT_PRINT, STMT_DEF } StmtKind;struct stmt {
StmtKind kind;
union {
struct { char *name; Expr *value; } let;
struct { Expr *value; } print;
struct { char *name; char **params; int param_count; Expr *body; } def; // params es NULL si son 0
} as;
Stmt *next;
};Es el mismo estilo de Expr, con una diferencia: el campo next. Un programa es una lista enlazada de instrucciones, como los
bloques enlazados de la semana 6. El programa del inicio se ve así en memoria:
 program ─▶ STMT_DEF ───next──▶ STMT_LET ───next──▶ STMT_PRINT ───next──▶ NULL
            name = "fact"       name = "x"          value
            params = ["n"]      value                 │
            body                  │                   ▼
              │                   ▼                 llamada fact
              ▼                   5                 con el argumento x
            if ...
stmt_free recorre esa lista con un ciclo. Podría ser recursiva, y sería más corta. Pero lo que aprendieron en la semana 9 se aplica:
la profundidad de la recursión sería el largo del programa, y eso lo decide quien lo escribe.
void stmt_free(Stmt *program) {
    while (program != NULL) {
        Stmt *next = program->next;
        free_one(program);
        program = next;
    }
}
Con expr_free no se hace lo mismo, y es razonable: un árbol recursivo se recorre más fácil con recursión, y su profundidad es la del
anidamiento del texto, no su largo.
Completar la gramática
Cada regla nueva se vuelve una función, como la semana pasada. Y como la semana pasada, lo difícil no es el camino feliz: es salir bien cuando el texto está mal.
Instrucciones: el primer token decide
static Stmt *parse_statement(Parser *p) {
    switch (p->current.kind) {
    case TOKEN_LET:
        return parse_let(p);
Mirando un solo token, el parser sabe qué regla seguir. Nunca tiene que probar una opción y deshacerla, y por eso aquí no hay
backtracking. Por eso también las instrucciones no necesitan separador. Después de la expresión de un let, si viene print, no
puede ser parte de la expresión, así que esa expresión terminó.
algoritmo analizar_let(p)
    consumir "let"
    nombre ← token actual
    exigir un NAME
    exigir "="
    valor ← analizar_expr(p)
    si falló la lectura de valor entonces
        devolver "falló"
    fin si
    devolver una instrucción let con nombre y valor
fin algoritmo
Error común. Guardar el texto del nombre cuando ya se pasó el token.
p->current.textcambia en cuanto se llama aadvance. Por eso se guarda antes una copia del token completo,Token name = p->current;. Unstructse copia entero, como vieron en la semana 2, con su arreglotextincluido, y aquí es justo lo que se necesita.
La lista: dónde enganchar la siguiente
parse_program viene hecha. Tiene un detalle que vale la pena leer con calma:
Stmt *first = NULL;
Stmt **tail = &first;   // dónde se engancha la próxima instrucción
tail es un puntero a puntero: la dirección de la casilla donde hay que guardar la próxima instrucción. Al principio, esa casilla es
first. Después, es el next de la última.
*tail = s;
tail = &s->next;
Con esto, las instrucciones quedan en el orden del texto, y no se recorre la lista para agregar al final. Si algo falla, se libera
lo armado hasta ahí con stmt_free(first), y como cada next nace en NULL, la lista siempre está bien terminada.
Hay un caso sutil. La gramática dice statement*, así que un archivo vacío, o solo con comentarios, es un programa correcto, y
su lista es… vacía, o sea NULL. Pero NULL también significa error de sintaxis. Lo que los distingue es el mensaje:
if (program == NULL && syntax.message[0] != '\0') {Es un costo de esta firma, y es bueno que lo vean escrito en parser.h: “también es NULL, pero con error->message vacío”.
El if
El if está en la regla expr, así que puede ir donde vaya una expresión: en un argumento, en un let o dentro de otro if. Tiene
tres subexpresiones, y hay que liberar las que ya se leyeron si aparece un error en la siguiente:
algoritmo analizar_if(p)
    consumir "if"
    condicion ← analizar_expr(p)
    si falló la lectura de condicion entonces
        devolver "falló"
    fin si
    si el token actual no es "then" entonces
        anotar el error
        liberar condicion
        devolver "falló"
    fin si
    consumir "then"
    rama_si ← analizar_expr(p)
    ...
fin algoritmo
Cada paso que puede fallar libera todo lo que se tiene hasta ese momento. Por eso la función crece como una escalera. Al final,
expr_if se vuelve owner de los tres.
Una consecuencia de la gramática: 1 + if a then b else c es un error de sintaxis, porque un sum está hecho de term, y estos
de unary y primary. El if solo entra ahí con paréntesis. Y if a then b else c + 1 se lee con c + 1 dentro de la rama, porque
la rama es una expr y llega tan lejos como puede.
Las llamadas: un token más
En primary, un NAME puede ser una variable o el comienzo de una llamada. Se resuelve mirando el token que sigue:
if (token.kind == TOKEN_NUMBER || token.kind == TOKEN_NAME) {
    advance(p);
    if (token.kind == TOKEN_NAME && p->current.kind == TOKEN_LPAREN) {
        return parse_call(p, token.text);
    }
Esa token es la copia local, por lo que su text sigue bien después de advance. Los argumentos no se sabe cuántos son, así que el
arreglo crece con realloc, duplicando la capacidad, como en la semana 5. parse_parameters, en el laboratorio, ya lo hace para los
nombres de los parámetros de un def. Vean el núcleo:
if (count == capacity) {
    int new_capacity = capacity == 0 ? 4 : capacity * 2;
    char **grown = realloc(names, (size_t) new_capacity * sizeof *grown);
    if (grown == NULL) {
        no_memory(p);
        free_names(names, count);
        return 0;
    }
    names = grown;
    capacity = new_capacity;
}
Tiene los cuidados de siempre. El resultado va a grown, y names solo se reemplaza si funcionó: si realloc falla, names sigue
siendo válido, y hay que liberarlo. Y al liberar se usa count, no capacity: solo esas casillas tienen algo.
parse_call es la misma forma, con un Expr **, y con una diferencia en el camino de error. Cada argumento ya leído es un árbol
entero:
 f(a + 1, b * 2, c - )
                     ^ error aquí
Cuando el parser llega al ), ya tiene dos árboles en el arreglo y uno a medio leer. La llamada interna, a parse_expr, se encarga
de su pedazo. parse_call se encarga de los árboles completos y del arreglo. Cada uno libera lo suyo, y por eso nadie libera dos
veces.
Error común. Olvidar que
f()no tiene argumentos. Si la función empieza a leer una expresión sin mirar antes si viene), lo rechaza como un error de sintaxis. Y si reservan conmalloc(0), el resultado puede serNULLsin que falte memoria. Con cero argumentos, el arreglo esNULLy no se reserva nada.
Ejecutar: la tabla de funciones
Con el programa ya en memoria, correrlo es recorrer la lista. Para eso necesitamos un lugar donde guardar lo que se usa todo el tiempo:
el marco global, las funciones, a dónde escribir y dónde anotar un error. Va en un struct:
typedef struct {
    Env *global;            // el marco global de Mini
    Function *functions;    // la tabla de funciones de Mini
    FILE *out;
    RunError *error;
} Interp;
Este es el contexto de la semana 12, sin el void *, porque aquí sabemos el tipo. Se pasa como parámetro a todas las funciones.
“Global” significa global en Mini. En C no hay ninguna variable global, y por eso se pueden correr dos programas seguidos sin que
se mezclen.
Cada instrucción corre en el marco global:
algoritmo ejecutar(s)
    si s es let entonces
        valor ← evaluar(expresión de s, marco global)
        definir el nombre de s en el marco global, con valor
    sino si s es print entonces
        valor ← evaluar(expresión de s, marco global)
        escribir valor
    sino si s es def entonces
        registrar s en la tabla de funciones
    fin si
fin algoritmo
Lean bien el último caso. Un def no evalúa su cuerpo. Solo lo guarda para más tarde. Por eso def f(n) = n / 0 es una
instrucción perfectamente válida: el error aparecería al llamar a f.
Quién es owner de un def
La tabla es una lista de entradas, y cada entrada guarda un puntero al def:
typedef struct function {
    const Stmt *definition;
    struct function *next;
} Function;
¿Copiamos el cuerpo de la función en la tabla? No hace falta. La regla de la semana 5 pide una sola cosa: un owner para cada bloque.
La entrada de la tabla es owner de sí misma, y la libera run_program. El def y su árbol son del programa, y la tabla solo los toma
prestados. Es seguro porque el programa vive más que la tabla: quien llama a run_program lo libera recién después.
free_functions      libera las entradas de la tabla, no los def; la llama run_program
stmt_free           libera los def, con todo el programa; la llama main
El const del campo ayuda. free no acepta ese puntero sin un aviso, y eso es lo que queremos: quien lo intente recibe una queja.
Un def tiene efecto cuando corre
La tabla empieza vacía y se llena cuando se ejecuta cada def. Eso explica dos resultados que a primera vista parecen contradecirse.
Llamar antes de definir falla, y lo que ya se escribió se queda escrito:
print 1
print twice(4)
def twice(n) = n * 2
$ build/lab/mini lab/programs/before_def.mini
1
lab/programs/before_def.mini: error de ejecución: función desconocida: twicePero el cuerpo de una función sí puede nombrar a otra definida más abajo, porque el cuerpo no corre hasta la llamada, y para entonces
los dos def ya se ejecutaron:
# Cada función llama a la otra. Funciona porque, al llamarlas, ya se ejecutaron los dos def.
def even(n) = if n == 0 then 1 else odd(n - 1)
def odd(n) = if n == 0 then 0 else even(n - 1)
print even(10)
print even(7)
$ build/lab/mini lab/programs/even_odd.mini
1
0Si un nombre se vuelve a definir, el def nuevo reemplaza al anterior, igual que env_set con una variable. Las funciones y las
variables están en tablas separadas, así que let f = 1 y def f(x) = x + 1 conviven: f(f) vale 2. Es una decisión de Mini, y
muchos lenguajes deciden lo contrario.
Evaluar el if
eval tiene la forma de siempre, un caso por variante, y le agrega dos parámetros a la expr_eval de la semana 13: el contexto y el
marco actual.
static int eval(Interp *in, const Expr *e, const Env *frame, double *result) {Los casos conocidos casi no cambian. Una variable se busca desde el marco actual, y ahora el error dice cuál faltó:
case EXPR_VARIABLE:
    if (!env_get(frame, e->as.name, result)) {
        return run_fail(in, "variable desconocida", e->as.name);
    }
    return 1;
eval devuelve 1 si salió bien, y 0 si hay un error, ya anotado. Cada nivel que recibe un 0 limpia lo suyo y devuelve 0. Así, el
error sube por toda la recursión sin más ceremonia. No hay goto ni nada parecido: es el mismo patrón de devolver un código, repetido.
El if en pseudocódigo:
algoritmo evaluar_if(e, marco)
    condicion ← evaluar(la condición de e, marco)
    si condicion ≠ 0 entonces
        devolver evaluar(la rama then de e, marco)
    sino
        devolver evaluar(la rama else de e, marco)
    fin si
fin algoritmo
Es simple, y hay una razón profunda para que esté aquí y no sea una función. Fíjense:
# Solo se evalúa la rama elegida: la otra dividiría entre cero.
let d = 0
print if d == 0 then 0 else 1 / d
$ build/lab/mini lab/programs/only_branch.mini
0Que solo corra una rama no es una optimización: sin eso, esta línea daría error. Y hay un caso peor. ¿Se puede escribir if como una
función de Mini?
# Un if escrito como función: una llamada evalúa todos sus argumentos antes de entrar.
def my_if(c, a, b) = if c then a else b
print my_if(1, 10, 20)
def fact(n) = my_if(n < 2, 1, n * fact(n - 1))
print fact(3)
my_if(1, 10, 20) da 10 sin problema. Pero en el nuevo fact, para llamar a my_if hay que calcular antes sus tres argumentos, y el
tercero llama a fact(n - 1). Ese llama a my_if, que necesita sus argumentos, y así sin fin. El caso base está escrito, pero nunca
se llega a usar. Veremos qué pasa cuando corre.
Idea clave. El
ifno se comporta como una llamada, y por eso cada lenguaje lo trae incorporado. Elifde C, y también&&y||, tienen la misma propiedad.
Evaluar una llamada
Aquí está la idea de la semana. Vuelvan a las reglas del modelo de entornos que vieron en la semana 3:
| Regla de la semana 3 | Qué hace el intérprete |
|---|---|
| 1. Se calculan los argumentos en el marco de quien llama | eval de cada argumento, con el frame actual |
| 1. Se crea un marco nuevo | env_new(in->global) |
| 1. Cada parámetro recibe una copia del valor, por posición | env_set de cada parámetro, con los valores |
| 2. Se busca en el marco actual, y al final fuera de toda función. Nunca en el marco de otra llamada | env_get busca en el marco y luego en sus padres. El único padre es el global |
| 4. Se calcula el valor de retorno, y el marco desaparece | eval del cuerpo, y env_free del marco |
Es una correspondencia uno a uno. Lo que antes dibujaban a mano, ahora lo escribe eval_call. Primero revisa que la llamada tenga
sentido:
const Stmt *function = find_function(in, name);
if (function == NULL) {
    return run_fail(in, "función desconocida", name);
}
int count = e->as.call.arg_count;
if (count != function->as.def.param_count) {
    return wrong_arg_count(in, name, function->as.def.param_count, count);
}
Y luego sigue el algoritmo:
algoritmo evaluar_llamada(f, argumentos, n, marco)
    valores ← arreglo nuevo de n números
    para i desde 0 hasta n - 1 hacer
        valores[i] ← evaluar(argumentos[i], marco)
    fin para
    nuevo ← marco vacío, con el marco global como padre
    para i desde 0 hasta n - 1 hacer
        definir el parámetro i de f en nuevo, con valores[i]
    fin para
    liberar valores
    resultado ← evaluar(el cuerpo de f, nuevo)
    liberar nuevo
    devolver resultado
fin algoritmo
Falta el manejo de errores: cada línea que puede fallar libera lo que ya existe. Los argumentos pueden fallar, y entonces se libera
valores. El cuerpo puede fallar, y entonces igual se libera nuevo. Ese último caso es el que se olvida con más facilidad, y por eso
el resultado va a una variable y no se hace return eval(...) antes de liberar.
Hay dos detalles del orden que importan.
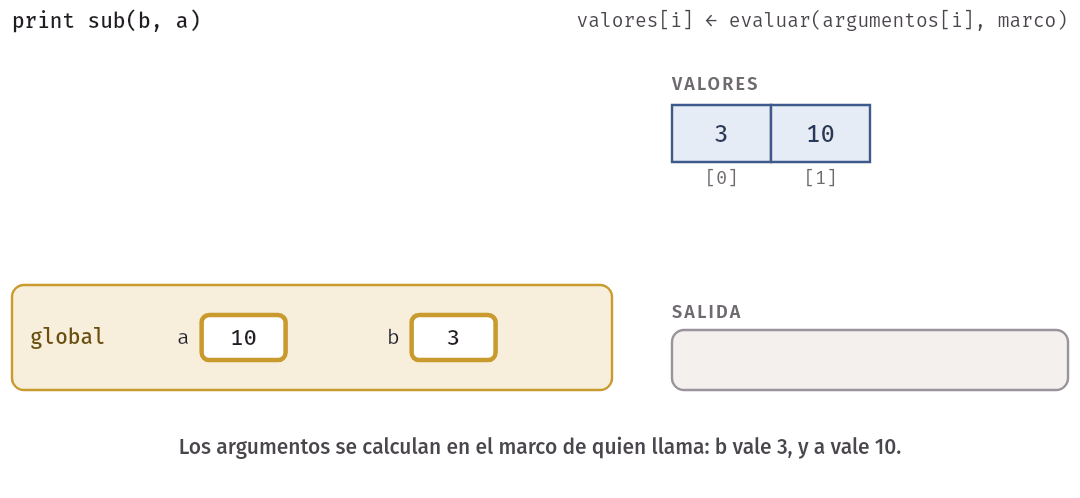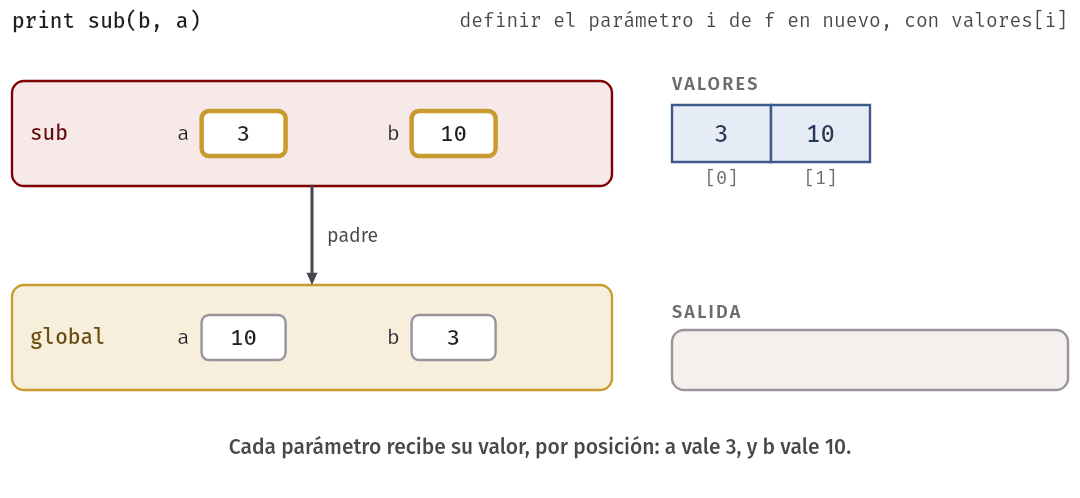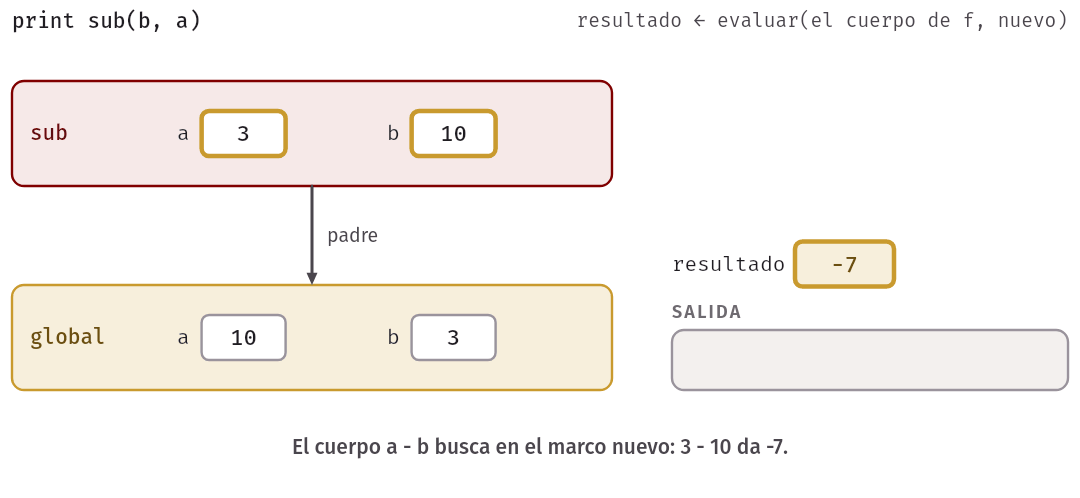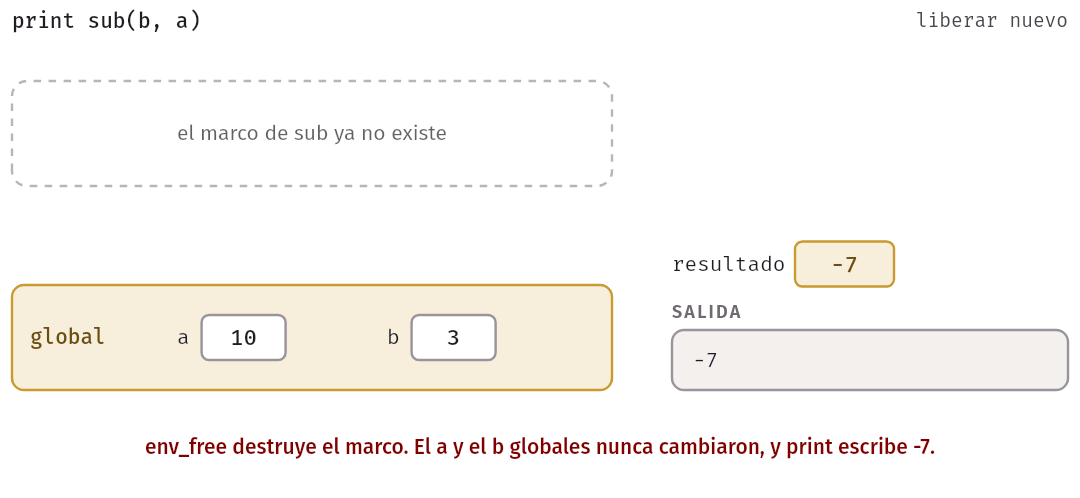
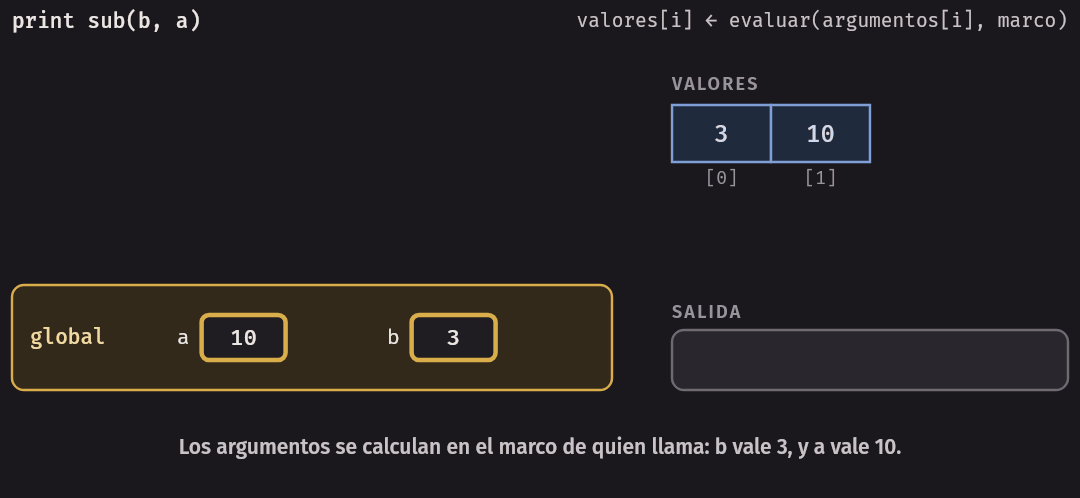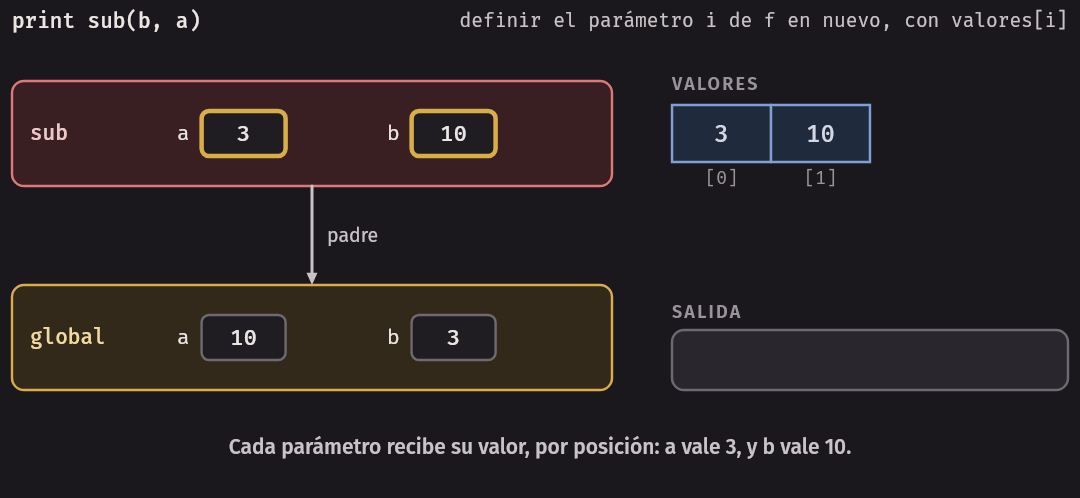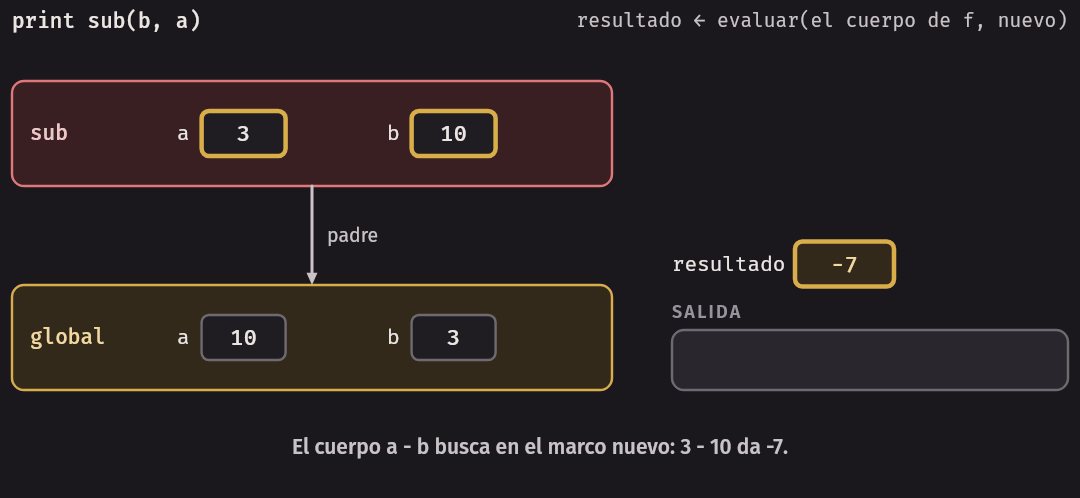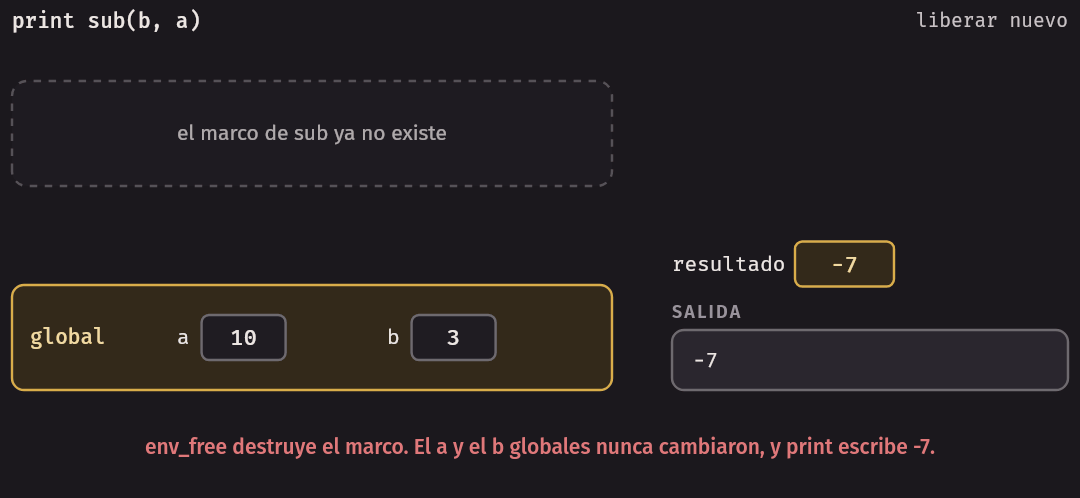
Los argumentos van antes del marco, y en el marco de quien llama. Si se evaluaran en el marco nuevo, esto saldría mal:
def sub(a, b) = a - b
let a = 10
let b = 3
print sub(b, a)
Debe dar -7: el b y el a del print son los globales, 3 y 10. Si el intérprete evaluara cada argumento en el marco nuevo, para
el segundo argumento a ya existiría, con el valor 3, y daría 0. Es la confusión que les advertimos en la semana 3: “se llaman igual, y
son otras casillas”.
El arreglo de valores es del heap, no de la pila, y es por llamada. Mientras el cuerpo corre ya se liberó. Eso es bueno: las
llamadas recursivas no guardan arreglos que ya no se usan. Noten que en Mini no se puede saber el número de argumentos al compilar
eval_call, y por eso usamos memoria dinámica.
Seguir fact(3)
Hagámoslo en el formato de la semana 3: el marco activo arriba. Usaremos fact3.mini:
def fact(n) = if n < 2 then 1 else n * fact(n - 1)
print fact(3)
El def solo llena la tabla. El print evalúa fact(3) en el marco global: el argumento vale 3, se crea un marco, y en él n = 3.
fact    n = 3
global  (vacío)
El cuerpo es un if. Como 3 < 2 da 0, se evalúa la rama n * fact(n - 1). Para eso se evalúa n, que vale 3, y luego fact(n - 1). El
argumento se calcula en este marco, y da 2. Nace otro marco, también con su n:
fact    n = 2
fact    n = 3     esperando: 3 * ?
global  (vacío)
Lo mismo otra vez, con n - 1 = 1:
fact    n = 1
fact    n = 2     esperando: 2 * ?
fact    n = 3     esperando: 3 * ?
global  (vacío)
Ahora 1 < 2 da 1, y corre la rama 1, sin llamada. Ese marco devuelve 1, y env_free lo destruye. Luego 2 * 1 = 2, y otro marco se
destruye. Luego 3 * 2 = 6, y otro.
global (vacío) el print escribe 6¿Cuántos marcos de Mini existen, como máximo, durante fact(3)? Tres de fact, y el global, que siempre está. Tres n distintas
conviven, y cada eval ve la suya porque recibe su frame. Es lo mismo que vieron en la semana 9 con la pila de C.
Por qué el marco nuevo cuelga del global
Esta es la línea más importante del laboratorio: env_new(in->global). ¿Por qué no env_new(frame), el marco de quien llama? También
parece razonable, y hasta sería más corto de explicar. frames.c arma a mano, con Env, los marcos de este programa:
let rate = 2
def scale(n) = n * rate
def outer(n) = scale(n + 1)
print outer(4)
Son cuatro marcos: el global, el de outer, el de scale colgado del global, y un cuarto, wrong, colgado de outer, que es
justo lo que Mini no hace:
Env *global = env_new(NULL);
Env *outer = env_new(global);
Env *scale = env_new(global);       // cuelga del global, no de outer
Env *wrong = env_new(outer);        // lo que NO hace Mini: colgar del marco de quien llama
$ build/frames
global rate = 2
global n no existe
outer n = 4
outer rate = 2
scale n = 5
scale rate = 2
wrong n = 4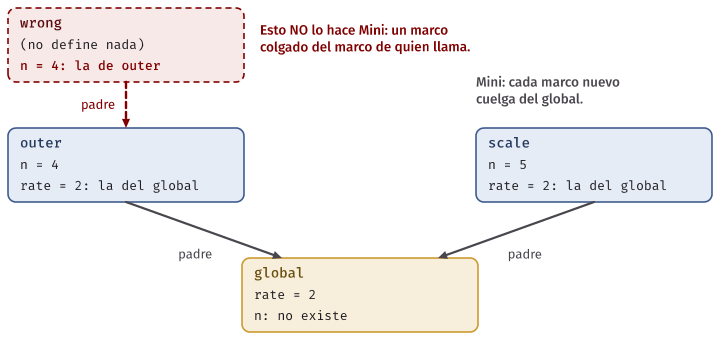
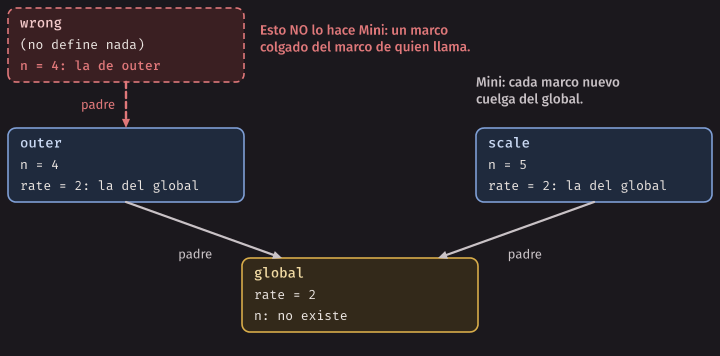
Las primeras seis líneas son la regla 2 de la semana 3: cada marco ve lo suyo y lo global, y el global no ve a nadie. La última
línea muestra lo que cambiaría: wrong no definió ningún n, y aun así encuentra el de outer. Si Mini colgara el marco de quien
llama, una función vería las variables de quien la llamó, y su significado dependería de quién y de cómo la llamen. Este programa lo
muestra. show nombra a un n que no tiene:
# show no tiene n, y el marco de outer no le sirve.
def show() = n
def outer(n) = show()
print outer(7)
$ build/lab/mini lab/programs/caller_local.mini
lab/programs/caller_local.mini: error de ejecución: variable desconocida: nEs el mismo error que caller_local.c les dio en la semana 3, solo que allá lo detectó gcc y aquí, al correr: Mini no tiene una etapa
que revise los nombres antes de ejecutar. Una función solo conoce los nombres escritos en su propio texto, más los globales.
Colgar el marco de quien llama se conoce como alcance dinámico (dynamic scope). Lo usaron algunos lenguajes antiguos, y hoy es raro, porque obliga a leer a todos los que llaman para entender una función.
Un parámetro con el nombre de una global
¿Y si un parámetro se llama igual que una variable global? En Mini se puede, y funciona solo:
# Un parámetro puede llamarse igual que una variable global: la tapa, sin cambiarla.
let x = 10
def double(x) = x * 2
print double(3)
print x
$ build/lab/mini lab/programs/shadow.mini
6
10env_get busca primero en el marco, y encuentra ahí el x de double. Nunca llega al global. Y env_set escribe en el marco que se le
da, así que el x global no cambia. Si Mini prohibiera ese nombre, cada let nuevo podría romper una función ya escrita, solo porque
coincide con el nombre de un parámetro. Por eso casi ningún lenguaje lo prohíbe.
Lo que un cuerpo lee de un global es su valor en ese momento, no el de cuando se definió:
# El cuerpo lee la variable global cuando corre, no cuando se define.
let rate = 2
def scale(n) = n * rate
print scale(5)
let rate = 3
print scale(5)
$ build/lab/mini lab/programs/globals.mini
10
15Programas de verdad
Con todo armado, el programa del inicio corre:
$ build/lab/mini lab/programs/fact.mini
120
También corre Fibonacci, con la misma recursión en árbol de la semana 10:
# Fibonacci en recursión en árbol, como en la semana 10.
def fib(n) = if n < 2 then n else fib(n - 1) + fib(n - 2)
print fib(1)
print fib(10)
print fib(20)
$ build/lab/mini lab/programs/fib.mini
1
55
6765Y un detalle de %g, ya anunciado. Son 6 cifras significativas:
$ build/lab/mini lab/programs/big.mini
720
3.6288e+06
6.22702e+09
Ese 3.6288e+06 es 3628800, y resulta exacto solo porque tiene pocas cifras. fact(13) es 6227020800, y %g escribe
6.22702e+09. El valor dentro del intérprete sigue completo: lo que se redondea es lo que se escribe. Y como todo es double, los errores de la semana 1 siguen ahí: 0.1 + 0.2 == 0.3 da 0 también en Mini.
La recursión de un lenguaje sostenida por la de otro
¿Por qué funciona la recursión en Mini? No hay ninguna línea del intérprete que la implemente. No hay una pila de Mini en ningún lado.
Lo que hay es esto: eval llama a eval_call, y este llama a eval para evaluar el cuerpo. Si en ese cuerpo hay otra llamada, se
repite. La recursión del intérprete sostiene la del lenguaje.
Se puede ver con gdb. Paremos el intérprete cuando evalúa el 1 del caso base de fact(3). break eval if ... es un breakpoint con
condición: solo se detiene si esa condición de C se cumple. El 1 de n - 1 también es un número 1, por eso ignore 1 2 le dice al
breakpoint 1 que deje pasar las dos primeras paradas. Los tres set solo acortan lo que se imprime: sin argumentos, sin direcciones y sin
carpetas. Los números de línea dependerán de su código. Como en todo uso de gdb del curso, se compila con -g -O0, sin sanitizers:
$ gcc -Wall -Wextra -std=c17 -g -O0 lab/*.c -o build/mini_gdb
$ gdb -q -batch -ex 'set print frame-arguments none' -ex 'set print address off' -ex 'set filename-display basename' -ex 'break eval if e->kind == EXPR_NUMBER && e->as.number == 1' -ex 'ignore 1 2' -ex 'run lab/programs/fact3.mini' -ex 'backtrace' build/mini_gdb
#0  eval (in=..., e=..., frame=..., result=...) at interp.c:144
#1  eval_if (in=..., e=..., frame=..., result=...) at interp.c:96
#2  eval (in=..., e=..., frame=..., result=...) at interp.c:156
#3  eval_call (in=..., e=..., frame=..., result=...) at interp.c:138
#4  eval (in=..., e=..., frame=..., result=...) at interp.c:158
#5  eval_binary (in=..., e=..., frame=..., result=...) at interp.c:79
#6  eval (in=..., e=..., frame=..., result=...) at interp.c:154
#7  eval_if (in=..., e=..., frame=..., result=...) at interp.c:96
#8  eval (in=..., e=..., frame=..., result=...) at interp.c:156
#9  eval_call (in=..., e=..., frame=..., result=...) at interp.c:138
#10 eval (in=..., e=..., frame=..., result=...) at interp.c:158
#11 eval_binary (in=..., e=..., frame=..., result=...) at interp.c:79
#12 eval (in=..., e=..., frame=..., result=...) at interp.c:154
#13 eval_if (in=..., e=..., frame=..., result=...) at interp.c:96
#14 eval (in=..., e=..., frame=..., result=...) at interp.c:156
#15 eval_call (in=..., e=..., frame=..., result=...) at interp.c:138
#16 eval (in=..., e=..., frame=..., result=...) at interp.c:158
#17 exec_statement (in=..., s=...) at interp.c:176
#18 run_program (program=..., out=..., error=...) at interp.c:195
#19 main (argc=..., argv=...) at mini.c:53
Es un extracto de las líneas de la pila. Lean de abajo hacia arriba: main, run_program, exec_statement, y entonces hay tres veces
eval_call, una por cada llamada de Mini que está viva. Es decir, hay dos pilas a la vez:
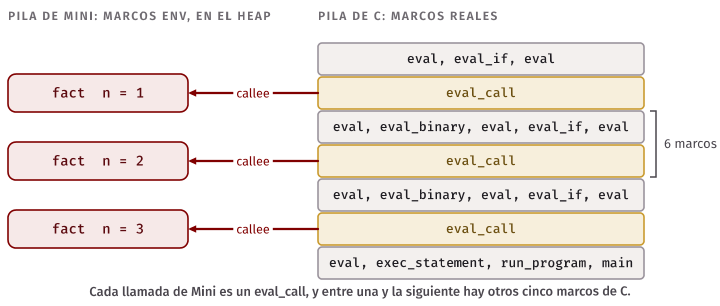
El marco de Mini es un Env en el heap. El marco de C guarda el puntero callee y espera. Cada llamada de Mini cuesta, en este
fact, seis marcos de C: eval_call más los eval, eval_if y eval_binary que hay entre una llamada y la siguiente. Vuelve a
aparecer el salto de fe de la semana 9. eval_call no sabe nada de recursión: confía en que eval del cuerpo devolverá el valor
correcto, y eso basta.
Idea clave. Un lenguaje interpretado usa la pila de su intérprete. Si la pila de C se acaba, se acaba también la de Mini. Y al revés: si
evalno fuera recursiva, Mini no tendría de dónde sacar sus marcos sin escribir una pila a mano, como en la semana 10.
Una recursión sin fin
Eso anticipa lo que pasa con un programa de Mini sin caso base:
def forever(n) = forever(n + 1)
print forever(0)
Mini no tiene un chequeo, así que eval_call se sigue llamando hasta que la pila de C se acaba. Con ASan, en el laboratorio, verán
esto. Es un extracto, y las direcciones y las líneas cambian:
==29==ERROR: AddressSanitizer: stack-overflow on address 0xffffebe09f90 (pc 0xffff92c6c2b8 bp 0xffffebe0a810 sp 0xffffebe09f90 T0)
    #0 0xffff92c6c2b8 in strcmp ../../../../src/libsanitizer/sanitizer_common/sanitizer_common_interceptors.inc:459
    #1 0xaaaac2707270 in env_get lab/env.c:67
    #2 0xaaaac270f374 in eval lab/interp.c:149
    #3 0xaaaac270e378 in eval_binary lab/interp.c:79
    #4 0xaaaac270f42c in eval lab/interp.c:154
    #5 0xaaaac270ed8c in eval_call lab/interp.c:119
    #6 0xaaaac270f45c in eval lab/interp.c:158
    #7 0xaaaac270f10c in eval_call lab/interp.c:138
Es el informe que conocen de la semana 9: dice stack-overflow, y la lista de marcos se repite. Pero noten qué se repite: eval_call
y eval en C, no forever. El intérprete no sabe que un programa de Mini hizo mal las cosas. El que se cae es el programa de C, con
todo: una falla en el programa interpretado derrumbó a quien lo interpretaba. Sin sanitizers, es un Segmentation fault, con estado 139. El
my_if de hace un rato termina igual, por el mismo motivo.
Tampoco le pidan a una recursión legítima que llegue muy lejos. Medimos en este entorno cuántas llamadas aguanta
def sum(n) = if n < 1 then 0 else n + sum(n - 1), con 8192 KB de pila. Estos números dependen de la máquina y del compilador, y de cómo
hayan escrito su intérprete:
| Compilado con | Se cae cerca de |
|---|---|
-g -O0 |
22 000 llamadas de Mini |
-g -fsanitize=address,undefined |
13 000 llamadas de Mini |
Compárenlos con los casi 175 000 marcos de sum_down en la semana 9. Una llamada de Mini cuesta varios marcos de C, y por eso cabe bastante
menos. Una prueba del laboratorio llega a 1000, muy por debajo de esos dos.
Un intérprete serio no se debería caer con lo que escriba su usuario. Podría llevar la cuenta de la profundidad y dar un error de ejecución. Mini lo deja así, a propósito, para que vean la relación entre las dos pilas. Agregar ese límite es una extensión del laboratorio, y pensarla les ayuda a entender qué número poner.
En C.
fprintfa unFILE *, y la salida estándar suele guardar el texto en un buffer si no va a una terminal. Por eso, cuando el programa se cae, lo que estaba en el buffer se pierde. Corriendomy_if.minien una terminal se ve el10antes del informe. Con la salida redirigida, como en las pruebas, ese10no aparece. Si al depurar les falta una línea de salida, no concluyan que no se ejecutó.
Errores de ejecución
Mini tiene cuatro errores de ejecución, y todos pasan por el mismo camino:
| Error | Dónde se detecta | Ejemplo |
|---|---|---|
| Variable desconocida | eval, si env_get devuelve 0 |
print prcie * 2 |
| Función desconocida | eval_call, antes de todo |
print twice(4) antes del def |
| Número de argumentos incorrecto | eval_call, antes de evaluar los argumentos |
add(1) |
| División entre cero | eval_binary, si expr_apply devuelve 0 |
inverse(0) |
$ build/lab/mini lab/programs/wrong_args.mini
3
lab/programs/wrong_args.mini: error de ejecución: número de argumentos incorrecto: add espera 2 y recibió 1
$ build/lab/mini lab/programs/zero_division.mini
0.25
lab/programs/zero_division.mini: error de ejecución: división entre cero$ build/lab/mini lab/programs/unknown_variable.mini
lab/programs/unknown_variable.mini: error de ejecución: variable desconocida: prcieEs distinto un error de sintaxis, que el parser detecta antes de correr nada, y que tiene línea y columna:
def add(a, b) = a + b
print add(1, 2
let x = 3
La posición es la del token que llegó: el ) que falta en la línea 2 se detecta en la 3, al ver el let.
$ build/lab/mini lab/programs/syntax_error.mini
lab/programs/syntax_error.mini:3:1: error de sintaxis: se esperaba ')'
Los errores de ejecución no traen línea, porque los nodos del árbol no guardan su posición. Agregarla es posible: cada nodo necesitaría
un line, y el constructor recibiría uno más.
Liberar en cada camino
Un error de ejecución se puede producir a muchas llamadas de profundidad:
def down(n, m) = if n == 0 then 1 / 0 else 1 + down(n - 1, m)
print down(50, 1)
Cuando la división falla, hay 51 marcos de Mini vivos. El 0 sube, y cada eval_call hace su env_free antes de devolverlo. Los marcos
se liberan en orden, como si la función hubiera terminado normalmente. No hay nada especial que hacer, si cada camino está bien.
Si olvidan el env_free del camino normal, el programa da el resultado correcto, y ASan lo delata al final. Este es un extracto del
informe, con fact(5) y el env_free quitado de eval_call:
SUMMARY: AddressSanitizer: 210 byte(s) leaked in 15 allocation(s).Son 15 bloques, y la cuenta se puede hacer. fact(5) crea 5 marcos. Cada uno son 3 bloques: el marco, la entrada de la variable y la
copia del nombre "n". Los 5 x 3 son los 15. Si un informe dice un múltiplo de lo que esperan, ya tienen una pista.
Probar un programa grande
Hasta ahora, sus laboratorios probaban módulos pequeños. Este programa tiene seis módulos que dependen unos de otros, y una falla se puede esconder a varios niveles. Por eso las pruebas de esta semana también vienen por niveles, y conviene pensar qué atrapa cada uno:
| Nivel | Prueba | Qué atrapa |
|---|---|---|
| Módulo | test_examples.py: expr, lexer, parse_expression, por su interfaz |
Un error local, cerca de donde está |
| Interfaz | Interface: la forma de los árboles y el resultado de run_program |
Un acuerdo roto entre dos módulos |
| Programa | LetAndPrint, IfExpression, Calls, Programs: texto de Mini y su salida |
Que todo junto hace lo que dice el lenguaje |
| Errores | RunErrors, SyntaxErrors |
Los caminos que el uso normal casi nunca recorre |
| Memoria | ASan y UBSan, en todas | Fugas y accesos inválidos, sobre todo en los caminos de error |
Una prueba de programa es la más fácil de escribir: un texto y lo que debe escribir. También es la que menos explica: si falla, el bug puede estar en cualquiera de los seis módulos. Una de módulo es lo contrario. Por eso se usan las dos, y por eso se empieza por las pequeñas.
La fila de errores merece atención. Fíjense en test_call, en test_lab.py: tiene textos como print f(1, 2, 3, 4, 5, 6, 7, 8, 9, *), cuyo
único objetivo es fallar justo después de que el arreglo creció, con árboles ya dentro. Ningún programa correcto llega ahí, y por eso una
fuga en ese camino puede vivir años. Una buena prueba busca el camino que nadie recorre.
¿Sus pruebas sirven? Rompan el programa
Una prueba que pasa no dice mucho si no es capaz de fallar. Hay una forma directa de averiguarlo: metan un bug a propósito y vean si
alguna prueba lo atrapa. Por ejemplo, cambien env_new(in->global) por env_new((Env *) frame), y piensen qué programa da otro
resultado. No sirve cualquiera. fact, Fibonacci y casi todos los ejemplos siguen dando lo mismo, porque esas funciones no nombran
las variables de nadie más. Hace falta uno así:
# Atrapa un marco que cuelga de quien llama: rate debe ser la global, no el parámetro de outer.
let rate = 2
def scale(n) = n * rate
def outer(rate) = scale(rate)
print outer(10)
Bien hecho da 20. Con el bug da 100, porque scale encuentra el rate de outer. Escribir esa prueba los obliga a entender qué
distingue al programa correcto del incorrecto. Eso es lo que se pide en la segunda sesión.
Qué idea sirvió en cada parte
Terminamos con la cuenta prometida. Esta es la columna vertebral del curso, y conviene repasarla con el código abierto:
| Parte del intérprete | Idea | Semana |
|---|---|---|
| Leer los módulos dados y sus pruebas antes de extenderlos | Leer código es una habilidad | 2 |
eval_call: argumentos, marco nuevo, parámetros, cuerpo, destruir el marco |
El modelo de entornos | 3 |
Env y parámetros que tapan a los globales |
Alcance: buscar en el marco y luego afuera | 3 |
double *result para devolver el valor y un 1 o un 0 |
Paso por puntero | 4 |
const Expr *, const Env * |
const y punteros: mirar sin cambiar |
4 |
Expr, el arreglo args, expr_binary que se apropia de sus hijos |
Memoria dinámica y ownership | 5 |
El arreglo que crece con realloc |
realloc, y el puntero que no se pierde |
5 |
La tabla de funciones que toma prestados los def |
Prestar en vez de copiar, y quién vive más | 5 |
| ASan en todas las pruebas | Fugas y accesos inválidos | 5 |
env.h, lexer.h, parser.h y interp.h |
Módulos e interfaz | 6 |
Lexer y Env, que solo se usan por su encabezado |
Tipos opacos | 6 |
Stmt y su campo next |
Bloques enlazados | 6 |
Expr y Stmt, con un switch por cada variante |
Uniones etiquetadas | 7 |
eval, expr_free, expr_print y el parser |
Recursión, y el salto de fe | 9 |
stack-overflow con una recursión sin fin de Mini |
La pila no es infinita | 9 |
fib en Mini |
Recursión en árbol | 10 |
Interp, que viaja por parámetro |
El contexto, en vez de variables globales | 12 |
| Las funciones que siguen la forma de los datos | Datos recursivos | 13 |
| Una función por regla de la gramática | Análisis léxico y sintáctico | 14 |
Faltan dos filas, y es honesto decirlo. El backtracking de la semana 11 no aparece: la gramática de Mini se decide con un token, y el
parser nunca tiene que deshacer. Hay gramáticas que sí lo necesitan. Y de la semana 12 solo quedó el contexto: aquí no hubo callbacks ni
nada que ordenar con qsort.
¿Qué parte del curso usaron en el analizador léxico, en el parser y en el evaluador? En resumen:
- En el analizador léxico: cadenas y
struct(semana 2), un tipo opaco (semana 6) yenum(semana 7). - En el parser: recursión (semana 9), ownership en cada camino de error (semana 5) y uniones etiquetadas (semana 7).
- En el evaluador: el modelo de entornos (semana 3), recursión (semana 9), ownership (semana 5) y contexto (semana 12).
Este lenguaje tiene límites claros: no hay cadenas, ni ciclos, ni arreglos, ni variables locales. Agregar lo que falta no requeriría ideas muy distintas. Los árboles de búsqueda y las tablas hash, que harían más rápida la búsqueda de un nombre, quedan para Estructuras de Datos.
El código de esta semana
make compila frames.c en build/. make test corre tres archivos de pruebas:
| Archivo | Qué comprueba |
|---|---|
test_examples.py |
frames, y los módulos ya terminados: expr, lexer y parse_expression, sin advertencias ni informes. Con la solución, también la recursión sin fin y la pila de gdb |
test_notes.py |
Vuelve a correr los comandos de este capítulo y compara su salida, y revisa que el código citado exista. Los bloques que dependen del sistema se corren, pero no se comparan |
test_lab.py |
La solución del laboratorio, si está disponible |
make test-lab corre esas mismas pruebas de laboratorio sobre su código.
El laboratorio, paso a paso
Son dos sesiones, y cada una está pensada para unos 90 minutos. lab/README.md tiene el detalle y la lista de archivos.
Sesión 1: unir las partes.
- Lean
stmt.h,parse_parameters,parse_programy el comienzo deinterp.c, y respondan las preguntas de lectura. Unos 15 minutos. - Escriban
parse_let,parse_printy dos casos deexec_statement. Ya pueden correr un programa desde un archivo. - Escriban
parse_ifyeval_if. - Terminen
parse_def, escribanparse_cally termineneval_call. Antes, dibujen los marcos defact(3)en papel. Es la parte larga: unos 45 minutos. Si no alcanza, lo que falte deeval_callse termina antes de la sesión 2.
Lo que ya viene hecho les ahorra mucho: las expresiones, parse_parameters, la tabla de funciones, run_program y mini.c. No hace falta
reescribirlo, pero sí leerlo.
Sesión 2: probar y repasar.
- Corran
make test-labpor grupos, hasta que no quede ninguna falla y ningún informe de ASan. - Escriban en
lab/mine/un programa propio, con su resultado esperado, y programas que atrapen dos bugs metidos a propósito. - Los últimos 35 minutos son de repaso: las preguntas de la guía, la tabla de arriba, y los ejercicios marcados como repaso.
Resumen
- Un programa de Mini es una lista enlazada de instrucciones (
Stmt), y cada instrucción tiene sus árboles (Expr). Son dos uniones etiquetadas, con un owner claro en cada bloque. ExprganaEXPR_IFyEXPR_CALL. Una llamada tiene un arreglo dinámico de hijos, que el nodo posee.- Cada función del parser libera lo que ya tiene si algo falla, y una vez entregado a un constructor, ya no es suyo.
- Un
defno evalúa su cuerpo: lo registra. La tabla de funciones toma prestados losdef, porque el programa vive más que ella. - Un
deftiene efecto cuando se ejecuta. Un cuerpo puede nombrar funciones definidas más abajo, si existen cuando se llama. - El
ifsolo evalúa la rama elegida. Por eso no se puede escribir como una función. - Evaluar una llamada es el modelo de entornos de la semana 3: argumentos en el marco de quien llama, marco nuevo, parámetros, cuerpo, destruir el marco.
- El marco nuevo cuelga del global, no de quien llama. Una función ve sus parámetros y los globales, nunca lo local de su llamador.
- Un parámetro puede llamarse como una global, y la tapa solo dentro de la función.
- La recursión de
evalsostiene la recursión de Mini. Cada marco de Mini es unEnven el heap, sostenido por varios marcos de C. - Una recursión sin fin en Mini produce un stack overflow en C, y cae el intérprete entero.
- Hay cuatro errores de ejecución. Suben como un 0 por la recursión, y cada nivel libera lo suyo.
- Las pruebas de un programa grande van por niveles, y se comprueban rompiendo el programa a propósito.
Ejercicios
Decidan primero y ejecuten después. Los marcados con (repaso) sirven para la última parte de la sesión 2.
-
(repaso) Dibujen el árbol de
f(1 + 2, if a then b else c). ¿Cuántos nodos tiene? ¿Cuántas llamadas amallochace construirlo, contando las cadenas y el arreglo? -
(repaso) En
def f(n) = if n < 2 then 1 else n * f(n - 1), ¿cuántos marcos de Mini existen, como máximo, durantef(4)? Dibújenlos en el momento de mayor profundidad. ¿CuántosEnvcrea en total el programa? -
¿Cuántos marcos de Mini crea
fib(5)en total? ¿Cuántos existen a la vez, como máximo? Comprueben el primer número agregando un contador aInterp. Comparen con lo que midieron en la semana 10. -
(repaso) Sin correrlo, ¿qué escribe este programa? ¿En qué línea se detiene, y con qué error?
let a = 1 def f(a) = a + b let b = 2 print f(10) def g() = h() print a print g() def h() = 3 print g() -
(repaso) Para cada línea, ¿es válida en la gramática de Mini? Si no, ¿en qué token falla?
a) print 1 < 2 < 3 b) print 1 + if 1 then 2 else 3 c) print -(-2) d) let print = 3 e) def f(a, b) = a let x = f(1, 2) f) print f(g(1), (2)) -
(repaso) Una versión de
parse_calltiene este camino de error: siparse_exprdevuelveNULL, hacefree(args)y devuelveNULL. ¿Qué se fuga, y con qué texto de Mini lo mostrarían? Escriban ese texto, y compruébenlo con ASan. -
Cambien
eval_callpara evaluar cada argumento en el marco nuevo, y encuentren un programa de Mini que dé otro resultado. Expliquen la diferencia con el modelo de la semana 3. Deshagan el cambio. -
Escriban en Mini
gcd(a, b), ypower(x, n)paranentero. Mini no tiene módulo: ¿cómo calculan el resto con lo que hay? ¿Con qué valores falla por la pila? -
Agreguen a Mini el operador
%, con su token, suBinaryOpy sus casos. Hagan la lista de todos los archivos yswitchque tocaron. ¿Quién les avisó de los que se olvidaron? -
Agreguen un error de ejecución si la profundidad de Mini pasa de un límite. Expliquen por qué no alcanza con un número fijo, considerando lo que aprendieron del tamaño de la pila y de lo que cuesta cada llamada.
-
(reto) Hagan que un
defpueda tener locales: agreguenlet NAME = expr in exprcomo expresión. ¿En quéEnvse guarda ese nombre? ¿Hace falta un marco nuevo? ¿Qué pasa con una función que se llama dentro del cuerpo?